

Réussir l’intégration des données CRM consiste à alimenter le CRM avec les informations utiles, fiables et suffisamment récentes. Je détaille comment partir des cas d’usage, organiser les flux, limiter les doublons et choisir une approche cohérente avec votre architecture.
À quoi sert l’intégration des données CRM ?
L’intégration des données CRM sert à rendre disponibles aux utilisateurs les données dont ils ont besoin, au bon moment, depuis les systèmes de l’entreprise. Je la définis à partir des usages attendus du CRM, pas à partir de l’ensemble des données disponibles.
La question à poser est simple : quelle décision ou quelle action l’utilisateur doit-il pouvoir prendre ? Remonter toutes les données « au cas où » donne rarement un meilleur CRM. Ça alourdit l’outil et augmente les coûts de spécification et de maintenance, sans garantir que les données intégrées seront utiles.
Prenons une relance après un premier achat. Pour décider qui relancer et avec quel message, l’équipe peut avoir besoin de la date et du montant de la commande, du canal d’achat et du consentement e-mail. Ce besoin permet de cadrer les données à intégrer. Il ne justifie pas, à lui seul, de rapatrier tout l’historique disponible.
Agents IA n8n : une formation pratique pour accélerer votre productivité avec le No Code !
Les formations n8n vous ouvrent les portes d’une automatisation intelligente, fluide et évolutive. Vous y apprendrez à construire des workflows sur mesure, à interconnecter vos outils métiers, à transformer vos données, et même à intégrer des agents IA ou des systèmes RAG dans vos scénarios.
Je classe généralement les données utiles à cet usage en quatre catégories :
- Identité : les données qui permettent de reconnaître le client.
- Transaction : les informations sur l’achat, notamment sa date et son montant.
- Interaction : les informations sur le canal d’achat ou les échanges avec l’entreprise.
- Consentement : l’autorisation de contacter le client par e-mail.
Ce cadrage évite de confondre données accessibles et données nécessaires. C’est un point souvent sous-estimé : chaque donnée ajoutée peut créer des besoins de spécification et de maintenance. Un CRM qui accumule des champs sans usage défini devient plus lourd à gérer, et l’équipe perd du temps à distinguer l’information utile du reste.
Une fois les usages et les données nécessaires définis, il faut préciser comment ces données circulent depuis les systèmes de l’entreprise jusqu’au CRM. C’est le rôle des flux de données.
Quels flux alimentent un CRM ?
Les flux qui alimentent un CRM relient les systèmes sources au CRM. Leur périmètre dépend de l’activité et de l’architecture de l’entreprise : il n’existe ni architecture ni fréquence de synchronisation universelle. Je définis les flux à partir des usages attendus, pas à partir de toutes les données disponibles.
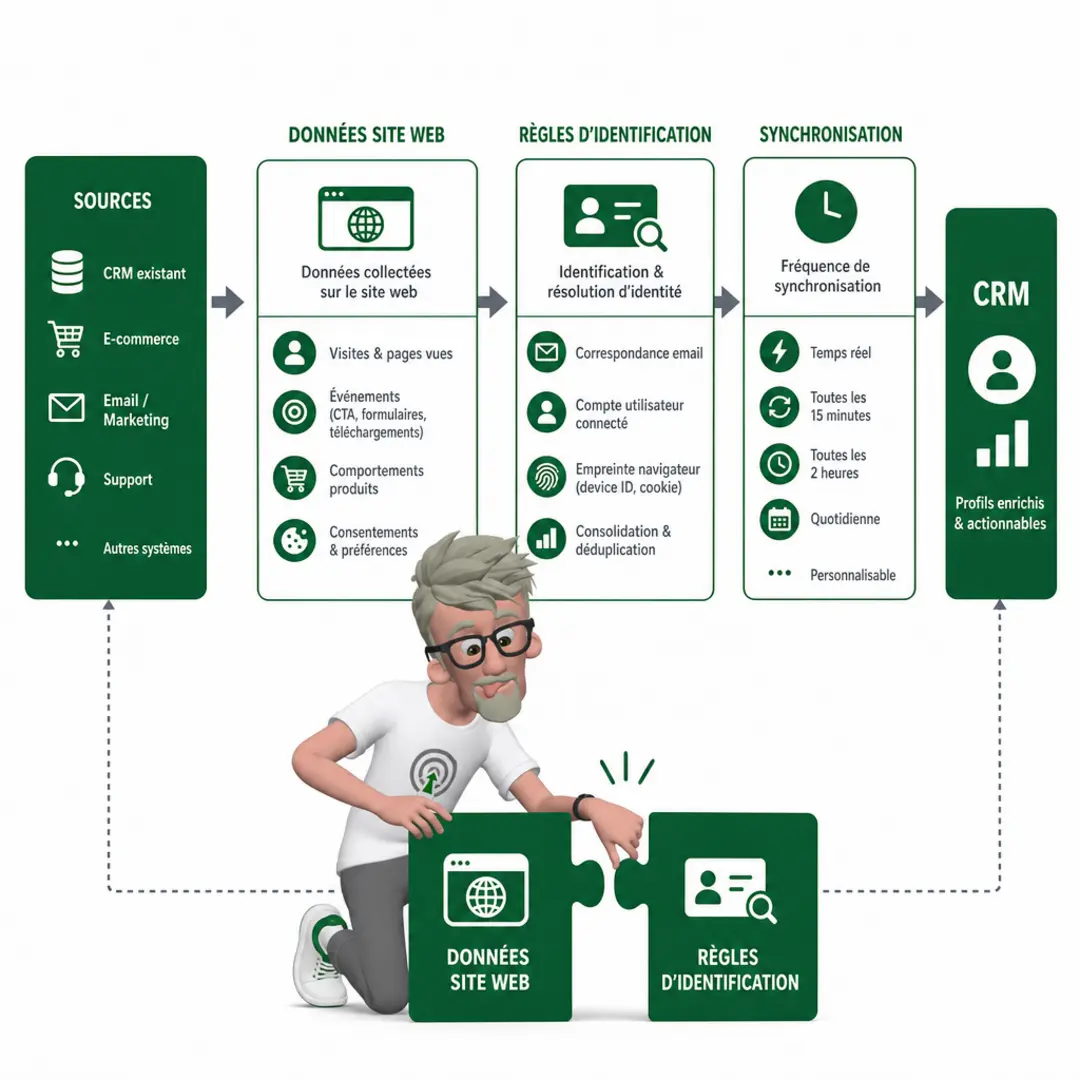
Le site web constitue souvent une source importante. Il peut transmettre des inscriptions à la newsletter, des créations de comptes clients, des achats en ligne et, si le besoin le justifie, des pages consultées ou d’autres événements. Chaque donnée doit répondre à un usage CRM précis.
Concrètement, une inscription à la newsletter permet de gérer l’abonnement et les préférences de contact. La création d’un compte client alimente la fiche d’identité et facilite le rapprochement des interactions associées à ce compte. Un achat en ligne apporte des informations transactionnelles utiles au suivi de la relation client et à la lecture de l’historique d’achat. Les pages consultées et les événements peuvent renseigner les centres d’intérêt ou les interactions d’un contact, à condition qu’un cas d’usage CRM exploite réellement ces informations.
Je sélectionne les données selon les besoins métier et les traitements prévus. Une page consultée n’a pas vocation à entrer dans le CRM par défaut. Si elle ne sert ni à une action définie ni à une analyse utile, son transfert ajoute du volume et de la complexité sans améliorer l’usage du CRM.
Avant de retenir un flux, je vérifie aussi comment les données sont identifiées et rapprochées : adresse e-mail, identifiant de compte, identifiant de commande… Ces règles dépendent des systèmes en place. La fréquence de transfert se choisit elle aussi selon le besoin opérationnel et les contraintes techniques, plutôt que selon une règle unique.
Une fois les flux définis, l’enjeu est de garantir que les données transférées sont complètes, cohérentes et correctement associées aux fiches CRM. C’est cette fiabilité qui conditionne la qualité des usages en aval.
Comment fiabiliser les données CRM ?
Je fiabilise les données CRM en m’assurant qu’elles sont unifiées, normalisées et suffisamment récentes pour être utilisées. Une donnée présente dans le CRM n’est pas forcément exploitable : si elle est incohérente, dupliquée ou périmée, elle peut fausser les analyses et dégrader la confiance des équipes.
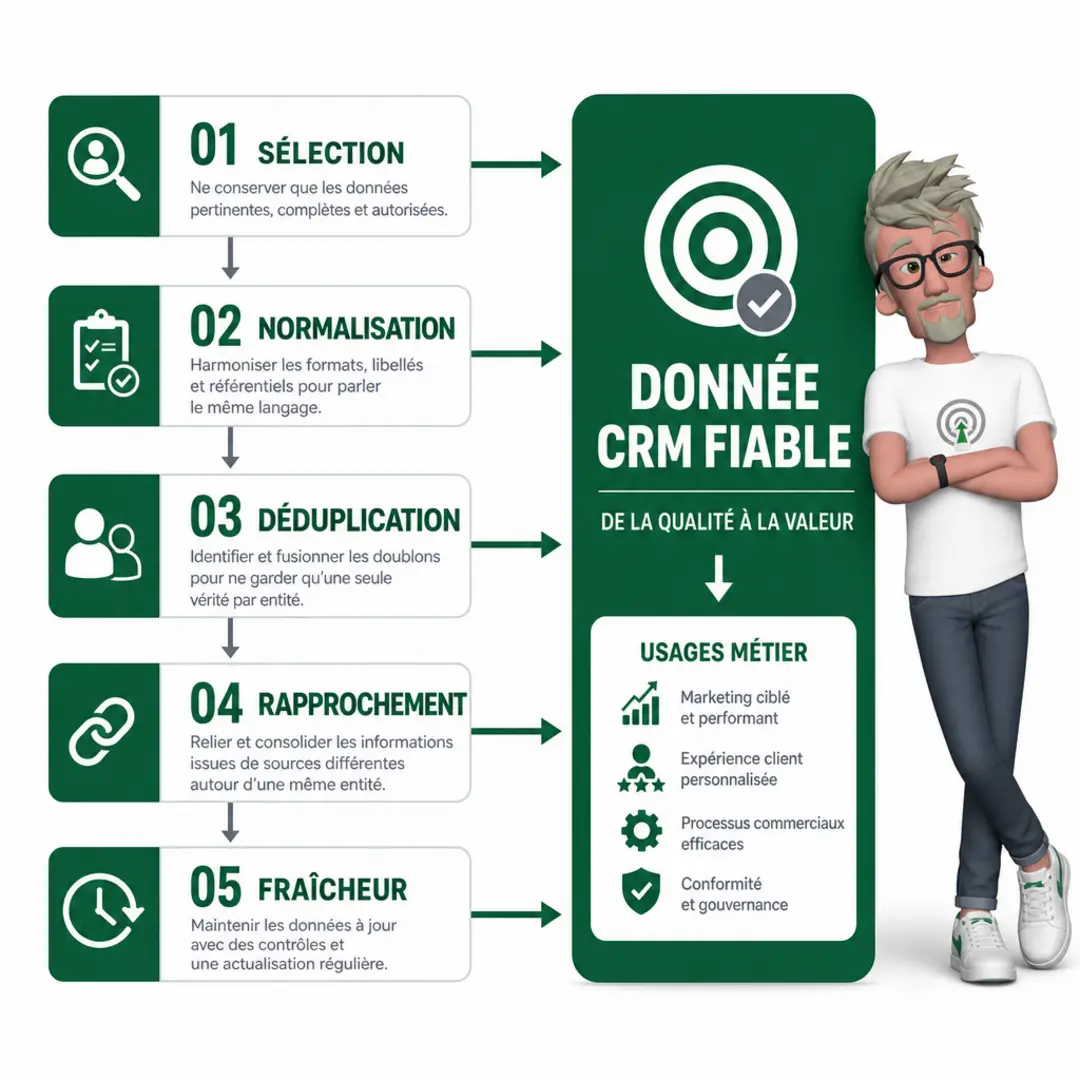
Les doublons et les informations obsolètes ne sont pas de simples défauts de présentation. Ils peuvent créer des contacts en double, brouiller l’historique d’une relation ou conduire à des décisions fondées sur une situation qui n’est plus actuelle. À terme, ces écarts fragilisent la qualité du CRM et son adoption. Les équipes finissent par contourner l’outil quand elles ne savent plus quelles données croire.
La fiabilisation commence avant l’intégration, par la sélection des données réellement nécessaires aux usages visés. Plus on importe de champs sans utilité claire, plus on augmente le volume à contrôler et le risque de conserver des informations incohérentes. Je distingue deux niveaux :
- Les exigences de qualité : les données doivent être cohérentes, compréhensibles et assez récentes pour l’usage prévu.
- Les choix d’implémentation : ils concernent la façon dont les données sont transformées, rapprochées ou synchronisées entre les systèmes.
Ces deux niveaux sont liés, mais ils ne se confondent pas. Une exigence de qualité décrit le résultat attendu ; elle ne prescrit pas à elle seule une règle de déduplication, une fréquence de synchronisation ou un outil. Ces choix dépendent du contexte et ne peuvent pas être déduits sans connaître les sources, les usages et les contraintes du CRM.
Je ne considère donc pas la fraîcheur comme une garantie automatique. Elle doit être évaluée au regard de l’usage et des capacités réelles de l’intégration. Une fois les données nécessaires identifiées et les exigences de qualité clarifiées, on peut comparer les solutions d’intégration adaptées aux systèmes et aux flux concernés.
Quels outils choisir pour intégrer les données CRM ?
Je choisis l’outil d’intégration CRM en fonction des sources à connecter, des usages attendus et de l’architecture déjà en place. Il n’existe pas de catégorie universellement supérieure : un outil adapté à un contexte peut devenir une contrainte dans un autre.
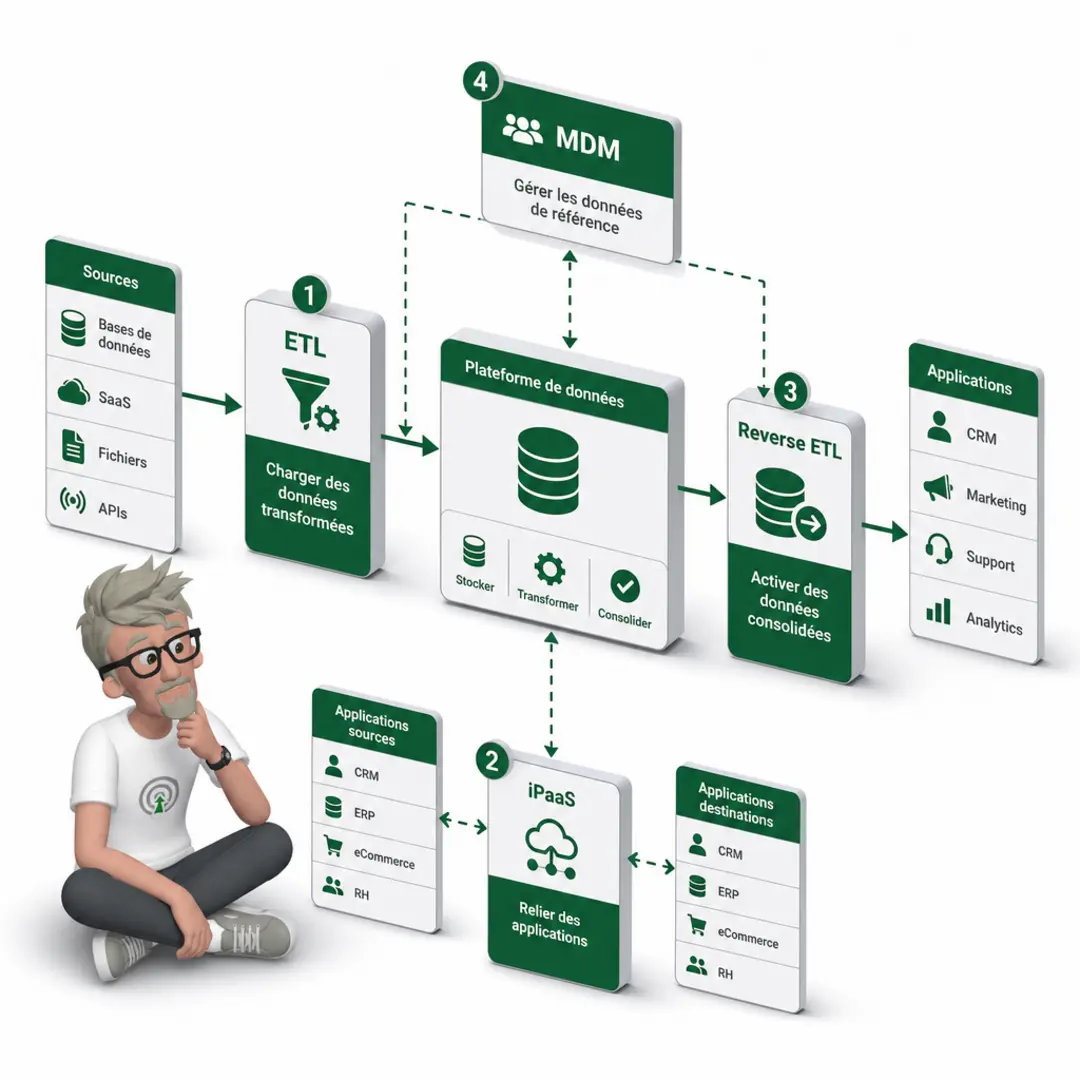
Les principales familles répondent à des logiques différentes :
- ETL (Extract, Transform, Load) extrait des données, les transforme puis les charge dans un système cible. Cette approche convient notamment lorsque l’intégration s’inscrit dans une architecture de données structurée.
- iPaaS (Integration Platform as a Service) fournit un environnement d’intégration entre applications. Je l’évalue selon les systèmes concernés, les flux à gérer et les contraintes de l’entreprise.
- Reverse ETL réinjecte des données préparées dans une plateforme de données vers des outils opérationnels, comme un CRM. C’est pertinent quand les équipes CRM doivent exploiter des données consolidées ailleurs.
- MDM (Master Data Management, ou gestion des données de référence) vise à organiser et fiabiliser des données maîtres partagées entre plusieurs systèmes. Ce n’est pas, à lui seul, une réponse à tous les besoins de synchronisation.
Le choix dépend aussi des usages CRM : alimenter les fiches, partager des données entre équipes, éviter les doublons ou rendre des indicateurs disponibles dans les outils opérationnels. Je regarde où les données sont produites, quels systèmes doivent les consommer, et quelles contraintes existent déjà en matière de sécurité, de gouvernance et d’exploitation.
Comparer ces familles sans connaître les besoins, les volumes, les systèmes sources et cibles, ni l’architecture de l’entreprise, reste forcément limité. Une catégorie ne garantit pas la qualité des flux. L’outil ne définit pas quelles données sont utiles et ne fiabilise pas automatiquement les valeurs, les identifiants ou les règles métier. J’ai vu des intégrations techniquement fonctionnelles produire des résultats inutilisables, faute d’accord sur le sens des champs.
Le choix de l’outil vient donc après la clarification des données et des usages. Il reste à attribuer clairement les responsabilités du projet : qui décide des règles, qui valide les données et qui maintient les flux.
Qui doit piloter l’intégration des données CRM ?
Je fais piloter l’intégration par les personnes capables de relier les usages CRM, les systèmes sources et le niveau de qualité attendu. Sans ce lien, on risque de transférer des données disponibles, mais inutiles, mal interprétées ou peu fiables.
Je pars des cas d’usage. À quoi le CRM doit-il servir : segmenter des clients, prioriser des prospects, suivre des interactions, déclencher des actions ? Ces réponses déterminent les données nécessaires. Elles évitent d’intégrer des champs simplement parce qu’ils existent dans un système source.
Je clarifie ensuite qui peut répondre aux questions clés, sans présumer de l’organisation de l’entreprise :
- Qui précise les usages attendus et les décisions que les données doivent permettre ?
- Qui connaît les systèmes sources, leurs champs, leurs règles de gestion et leurs limites ?
- Qui valide que les données retenues sont compréhensibles, exploitables et adaptées au CRM ?
Ces réponses orientent la sélection des données et la conception des flux : quelles informations extraire, à quelle fréquence, selon quelles règles de transformation et avec quels contrôles. Par exemple, un statut client peut avoir des définitions différentes selon les outils. Il faut trancher laquelle fait foi avant de la synchroniser.
La fiabilité ne dépend pas seulement du transfert technique. Elle suppose des données suffisamment complètes, cohérentes et à jour, ainsi qu’un traitement défini des erreurs et des doublons. J’ai déjà vu des intégrations fonctionner sans incident apparent, alors que les équipes prenaient leurs décisions à partir de valeurs obsolètes. Le flux était opérationnel, pas l’information.
Avant de lancer l’intégration, je fais donc trancher trois points : les usages à couvrir, les sources et données à retenir, puis les critères de qualité et de validation dans le CRM. Ces décisions donnent un cadre concret au pilotage et permettent de vérifier que les flux produisent une information réellement exploitable.
Votre CRM contient-il les données vraiment utiles ?
Une intégration CRM efficace commence par les usages, pas par l’inventaire exhaustif des données disponibles. Il faut identifier les informations nécessaires, puis organiser les flux depuis les systèmes concernés. Les données d’identité, transactionnelles, d’interaction et de consentement ne sont utiles que si elles sont fiables, unifiées, normalisées et suffisamment récentes. Les doublons et les informations périmées peuvent nuire à l’adoption du CRM. Le choix entre ETL, iPaaS, Reverse ETL et MDM dépend des besoins et de l’architecture ; aucun outil ne remplace le cadrage fonctionnel. En définissant ces éléments en amont, vous alimentez un CRM plus exploitable et évitez les coûts d’intégration inutiles.
FAQ
-
Qu’est-ce que l’intégration des données CRM ?
C’est le travail qui consiste à rendre disponibles dans le CRM les données utiles provenant des systèmes de l’entreprise, au moment où les utilisateurs en ont besoin. -
Quelles données intégrer dans un CRM ?
Je pars des usages. Selon le besoin, les données concernent l’identité, les transactions, les interactions et le consentement. Pour une relance après un premier achat, la date et le montant de la commande, le canal d’achat et le consentement e-mail peuvent être nécessaires. -
Pourquoi éviter d’intégrer toutes les données disponibles ?
Une collecte « au cas où » alourdit le CRM et augmente les coûts de spécification et de maintenance. Elle ne garantit pas que les données seront utiles aux équipes. -
Quelles données un site web peut-il envoyer au CRM ?
Selon les usages, le flux peut inclure les inscriptions à la newsletter, les comptes clients, les achats en ligne et parfois les pages consultées ou les événements. -
Quelles solutions sont citées pour intégrer les données CRM ?
Les catégories à examiner sont l’ETL, l’iPaaS, le Reverse ETL et le MDM. Le choix dépend des besoins et de l’architecture de l’entreprise ; il ne remplace pas le cadrage des données utiles ni leur fiabilisation.
A propos de l’auteur
Je suis Franck Scandolera, expert en Data engineering. J’aide les équipes à structurer leurs flux de données et à rendre leurs applications métier, dont les CRM, plus fiables et utiles aux opérations.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.