

En 2027, l’IA pourrait accélérer une partie du travail data, mais elle ne remplacera pas la compréhension des activités métier. Le vrai enjeu sera de relier les outils aux processus réels, souvent dispersés entre systèmes, équipes et connaissances tacites.
Que change l’usage quotidien de l’IA ?
L’IA passe de l’expérimentation à un usage régulier dans certaines équipes data. Des outils comme Claude Code s’intègrent désormais au travail quotidien et déplacent les questions : moins « peut-on utiliser l’IA ? », davantage « quelles tâches lui confier, avec quel contrôle, et où garder l’expertise humaine ? »
Certaines tâches de production, d’exploration ou de documentation peuvent être accélérées ou réalisées différemment. Le changement ne se limite donc pas au temps gagné : il touche aussi la façon de formuler un problème, de vérifier un résultat et de répartir le travail dans une équipe. La responsabilité de la qualité, de la cohérence des données et des choix techniques reste un sujet central.
Devenez un expert en Data Marketing avec nos formations !
Maîtrisez les outils essentiels pour analyser, automatiser et visualiser vos données comme un pro. De BigQuery SQL à Google Apps Script, de n8n à Airtable, en passant par Google Sheets et Data Studio, nos formations couvrent tous les niveaux pour vous permettre d’optimiser vos flux de données, structurer vos bases SQL, automatiser vos tâches et créer des dashboards percutants. Que vous soyez débutant ou avancé, chaque formation est conçue pour une mise en pratique immédiate et un impact direct sur vos projets.
Les effets sur le rôle d’ingénieur data restent incertains. L’adoption d’un outil ne dit pas, à elle seule, comment un métier va évoluer. Elle ne permet pas non plus de conclure que l’ingénieur data va disparaître. Les tâches peuvent changer, certaines étapes être accélérées, mais les conséquences sur les responsabilités et les compétences attendues dépendront des usages réels et de leur intégration dans les équipes.
En 2026, cette adoption n’est pas uniforme. Elle varie selon le type d’organisation, ses contraintes et la manière dont ses équipes intègrent l’IA à leurs pratiques. C’est là que les écarts deviennent visibles : l’usage quotidien ne recouvre pas la même réalité d’une organisation à l’autre.
Pourquoi les organisations avancent-elles différemment ?
Les organisations avancent différemment parce que l’adoption de l’IA et les priorités data dépendent de leur taille, de leur maturité et de la complexité de leurs opérations. Pour un ingénieur data, le même objectif — rendre les données exploitables — ne recouvre donc pas le même chantier.
Dans une start-up, l’expérimentation peut aller vite. Les flux métier sont souvent assez simples à représenter, ce qui facilite la création de premiers cas d’usage et leur ajustement. La difficulté consiste alors à avancer sans confondre rapidité de prototypage et compréhension suffisante des données mobilisées.
Dans une PME établie, un projet de modernisation peut commencer par une question plus fondamentale : quelles données sont réellement essentielles à l’activité ? Quand les opérations sont physiques, les informations utiles ne sont pas toujours concentrées dans les outils numériques. Il faut relier les données disponibles aux processus concrets, sans supposer que les priorités d’une PME sont identiques à celles d’une start-up.
Dans une grande entreprise, l’enjeu peut être de faire dialoguer des données réparties entre plusieurs plateformes, des systèmes SAP et des solutions acquises. Le travail porte alors autant sur les liens entre ces environnements que sur les données elles-mêmes. Une vue métier cohérente est difficile à construire si chaque système décrit une partie différente de l’activité.
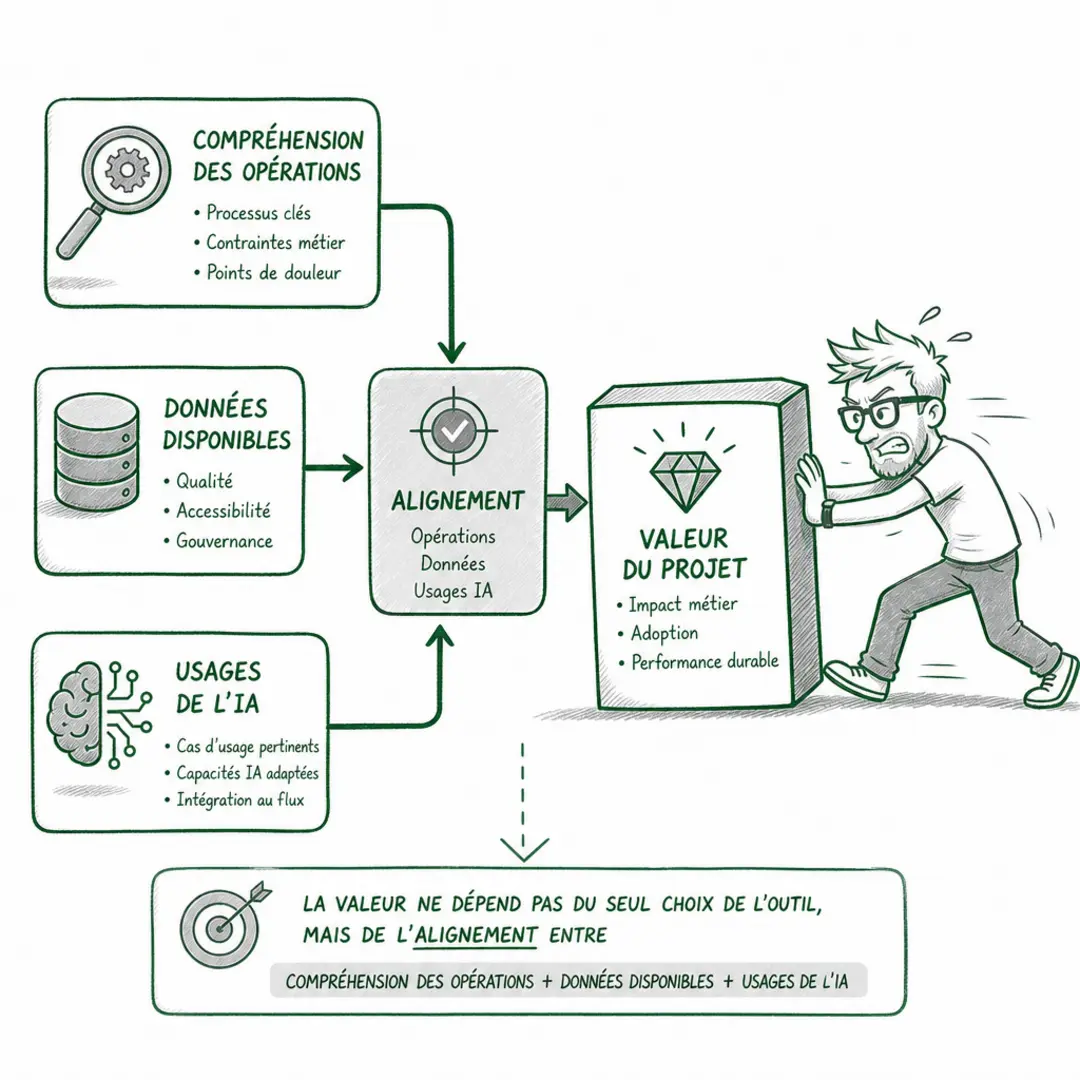
Ces situations ne décrivent pas toutes les organisations de leur catégorie. Elles montrent plutôt pourquoi l’ingénierie data ne se résume pas au choix d’une plateforme ou d’un modèle d’IA. Dans les trois cas, comprendre les processus métier permet de savoir quelles données compter, comment les interpréter et où l’IA peut produire une valeur utile.
| Contexte | Enjeu principal |
| Start-up | Expérimenter rapidement et représenter les flux métier |
| PME établie | Identifier les données essentielles, notamment pour les opérations physiques |
| Grande entreprise | Relier les données dispersées entre plateformes, systèmes SAP et solutions acquises |
Pourquoi la connaissance métier restera-t-elle décisive ?

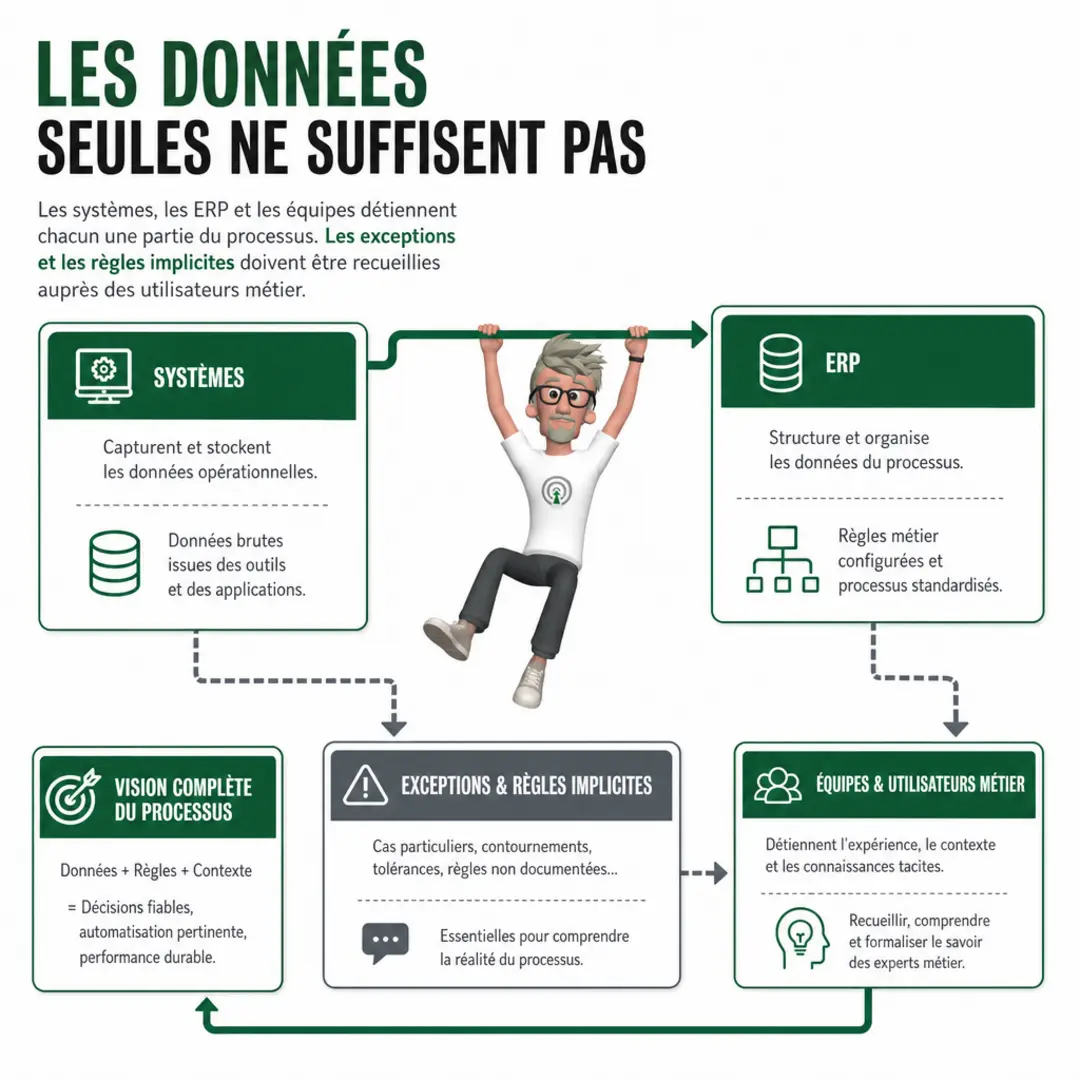
La connaissance métier restera décisive parce que les systèmes et les données disponibles ne décrivent pas toujours les processus réels, leurs acteurs ni leurs exceptions. Une table peut montrer qu’une commande a changé de statut. Elle ne dit pas nécessairement pourquoi, qui a pris la décision ou ce qui se passe quand le cas sort du parcours standard.
Les rôles d’ingénieur data pourraient évoluer vers des intitulés comme AI engineer ou FDE (Forward Deployed Engineer, un ingénieur qui travaille au plus près des équipes utilisatrices pour adapter et déployer des solutions). Ces intitulés ne s’imposeront pas forcément et ne correspondront pas à tous les profils. Le point important, c’est que relier les données à un usage d’IA demande aussi de comprendre le travail que ces données sont censées représenter.
Modéliser le parcours d’un client, d’une commande, d’une marchandise ou d’une demande de remboursement exige souvent des échanges avec les personnes concernées. Les ERP et les systèmes de référence décrivent une partie des opérations, mais rarement toutes les règles implicites, les contournements et les exceptions. J’ai déjà vu des informations indispensables absentes des outils, simplement parce qu’elles étaient connues des employés qui traitaient les cas au quotidien.
Cette connaissance ne se récupère pas toujours par une requête SQL ou une documentation existante. Il faut comprendre comment les opérations se déroulent réellement, où les décisions sont prises et quelles situations ne suivent pas le chemin prévu. Sans ce travail, un modèle peut être cohérent sur le plan technique tout en représentant imparfaitement la réalité métier.
La conséquence pratique est directe : cartographier les opérations et recueillir cette connaissance restent essentiels. C’est ce travail qui permet de relier les données disponibles aux usages de l’IA, sans confondre les traces laissées par un processus avec le processus lui-même.
Qu’est-ce qui fera la différence en 2027 ?
En 2027, les outils d’IA pourront accélérer une partie du travail des équipes data et faire évoluer certains intitulés de poste. Mais l’enjeu central restera la compréhension des opérations. Les start-up, les PME établies et les grandes entreprises n’abordent pas l’IA avec les mêmes contraintes : simplicité des flux, modernisation des activités ou fragmentation des systèmes. Dans tous les cas, les ERP et les données disponibles ne racontent qu’une partie de l’histoire. Il faut aussi comprendre les parcours, les exceptions et les savoirs détenus par les équipes. En reliant mieux processus métier, données et usages de l’IA, vous pourrez produire des projets plus pertinents et utiles.
FAQ
-
Quel sera l’enjeu principal pour les ingénieurs data en 2027 ?
L’enjeu ne sera pas seulement d’adopter des outils d’IA. Il faudra aussi comprendre les processus métier et relier les données aux opérations réelles. -
L’IA va-t-elle remplacer les ingénieurs data ?
Les éléments disponibles évoquent des tâches que l’IA pourrait accélérer ou modifier, mais ne permettent pas de conclure à un remplacement des ingénieurs data. -
Pourquoi les besoins diffèrent-ils entre start-up et grandes entreprises ?
Les start-up peuvent souvent représenter leurs flux métier plus simplement. Les grandes entreprises doivent fréquemment relier des données réparties entre plusieurs plateformes, systèmes SAP et solutions acquises. -
Pourquoi les données ne suffisent-elles pas à comprendre un processus métier ?
Les systèmes de référence documentent seulement une partie des processus. Les exceptions et certaines informations opérationnelles peuvent rester dans la mémoire des employés. -
Les métiers d’ingénieur data vont-ils changer d’intitulé ?
Certains ingénieurs data pourraient adopter des intitulés comme AI engineer ou FDE. Cela reste une possibilité, pas une évolution certaine ni adaptée à tous.

A propos de l’auteur
Franck Scandolera est expert en data engineering et en automatisation IA. Il accompagne les équipes dans la structuration des données et la conception d’applications métier intelligentes, avec une attention particulière à la compréhension des processus opérationnels.

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
- Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
- Data Engineering : BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
- Automatisation IA : n8n, Apps Script, scraping, API, LLM
- Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals