

Claude Opus 5.5 change surtout la donne sur le codage agentique, le coût, la vitesse et les tâches de connaissance complexes. Je vais droit au concret ici : ce qui progresse vraiment, ce qui reste à lire avec prudence, et pourquoi les benchmarks seuls ne suffisent plus.
Qu’est-ce que Claude Opus 5.5 apporte vraiment ?
Claude Opus 5.5, c’est surtout un signal clair : Anthropic pousse encore plus fort sur le code IA et les agents. Le modèle a été lancé le 22 septembre 2026, deux mois après Claude Opus 5, et il ouvre la famille Claude 5.5. Donc oui, on est sur une évolution rapide, pas sur un petit rafraîchissement marketing tous les ans.
Ce que j’en retiens, c’est que Claude Opus 5.5 vise les usages où le modèle ne se contente pas de répondre à une question. Il doit planifier, écrire du code, corriger, relancer, raisonner sur plusieurs fichiers, garder le contexte et produire quelque chose d’exploitable. C’est ça le codage agentique. Un modèle qui agit presque comme un développeur junior très rapide, avec des limites bien sûr, mais capable d’enchaîner plusieurs actions sans qu’on lui tienne la main à chaque ligne.
Anthropic le présente aussi comme son modèle le plus performant à ce jour sur ses tests internes d’alignement. L’alignement, pour faire simple, c’est la capacité du modèle à suivre les intentions de l’utilisateur, éviter les comportements dangereux ou absurdes, et rester cohérent avec les consignes. Je prends ça comme une indication intéressante, pas comme une vérité gravée dans le marbre. Les tests internes restent des tests internes. Ce qui compte, c’est ce que ça donne dans votre stack, vos prompts, vos dépôts Git, vos contraintes métier.
La promesse est assez claire : meilleur codage agentique, meilleures tâches de connaissance, coût typique plus bas, sortie plus rapide, écriture plus nette. Pour un client qui me demande si ça vaut le coup de tester maintenant, je réponds oui, si vous avez déjà des cas concrets. Migration de scripts, revue de code, génération de tests, automatisation d’un workflow, analyse documentaire un peu lourde. Là, ça peut parler vite.
- Modèle : Claude Opus 5.5
- Date de lancement : 22 septembre 2026
- Positionnement : premier modèle Claude 5.5
- Promesse principale : meilleur codage agentique, meilleur raisonnement de connaissance, coûts et sorties plus efficaces
Sonnet 5.5 et Haiku 5.5 sont annoncés comme devant suivre. C’est logique. Opus sert souvent à poser le haut de gamme, puis Sonnet et Haiku viennent couvrir les usages plus quotidiens, plus rapides ou moins chers. Ici, je pose juste le cadre. Après, la vraie question, c’est simple : Est-ce que Claude Opus 5.5 change vraiment quelque chose quand on code, quand on automatise, quand on lui confie un vrai boulot ?
Où Opus 5.5 dépasse Opus 5 ?
Opus 5.5 dépasse Opus 5 surtout sur cinq points : le code agentique, les tâches de connaissance, le coût typique, la vitesse de génération et la clarté des réponses. Dit comme ça, ça ressemble à une fiche produit. Mais dans un vrai workflow de dev, ça veut dire autre chose : moins de friction, moins d’attente, et souvent moins de reprises derrière le modèle.
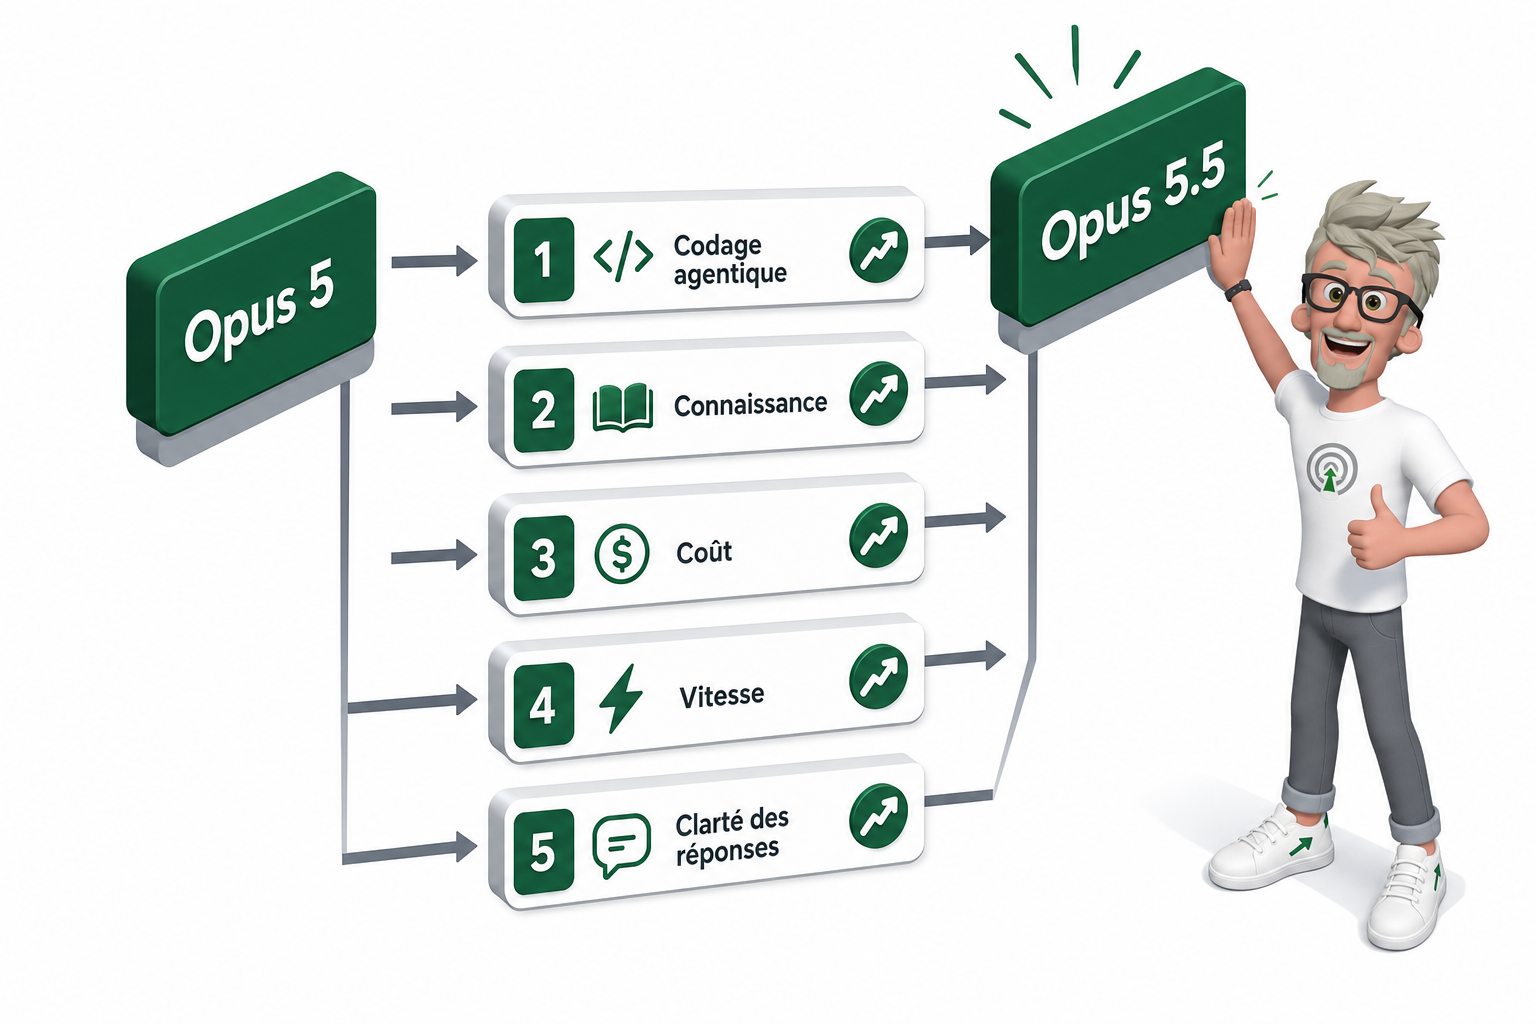
Le point le plus visible, pour moi, c’est le codage agentique. Par “agentique”, je parle de tâches où le modèle ne répond pas juste à une question, mais enchaîne plusieurs actions mentales : comprendre une base de code, modifier plusieurs fichiers, garder le contexte, repérer les effets de bord, proposer un correctif cohérent. Sur ce terrain, Opus 5.5 semble mieux tenir les tâches longues et complexes qu’Opus 5.
Sur les tâches de connaissance, le gain est aussi intéressant. Je pense aux recherches difficiles, aux synthèses où il faut croiser plusieurs infos, éviter les raccourcis, et sortir une réponse exploitable sans noyer le lecteur. Là, Opus 5.5 est annoncé comme plus performant, avec des réponses plus claires. Et franchement, la clarté compte autant que le score brut. Un modèle brillant mais confus fait perdre du temps.
| Critère | Ce qui change avec Opus 5.5 |
| Codage agentique | Meilleures performances sur des tâches longues et complexes |
| Connaissance | Meilleure réussite sur des recherches et synthèses difficiles |
| Coût | Coût typique inférieur de 40 % |
| Vitesse | Sorties plus rapides de plus de 30 % |
| Écriture | Réponses plus claires |
Le coût typique annoncé baisse de 40 %. C’est énorme si vous utilisez ces modèles en production, dans un outil interne, un agent de support dev, ou un système qui génère beaucoup de tokens. La vitesse compte aussi : des sorties plus rapides de plus de 30 %, ça change l’usage. On ose plus facilement itérer, relancer, comparer deux approches.
Je garde quand même une réserve sur les benchmarks. À ce niveau, ils deviennent moins discriminants. Quand plusieurs modèles sont déjà très hauts, un score ne raconte pas toute l’histoire. Une différence peut paraître spectaculaire sur un graphique, alors que dans un workflow réel, l’écart ressenti est plus faible. C’est exactement le point à garder en tête avec Opus 5.5 et Fable 5.1 : l’écart réel semble plus faible que certains scores peuvent le suggérer.
Que disent les benchmarks indépendants ?
Les chiffres d’Artificial Analysis donnent une lecture assez saine de Claude Opus 5.5. Oui, le modèle est très fort. Mais non, ça ne veut pas dire qu’il faut l’utiliser à fond partout, tout le temps. C’est souvent là que les budgets IA partent de travers.
Au réglage de raisonnement maximal, Opus 5.5 obtient 58 à l’Intelligence Index. Cet index agrège plusieurs évaluations pour donner une idée du niveau global du modèle. C’est utile pour situer la performance brute, surtout sur des tâches complexes comme le code, l’analyse, la résolution de problèmes ou les raisonnements longs.
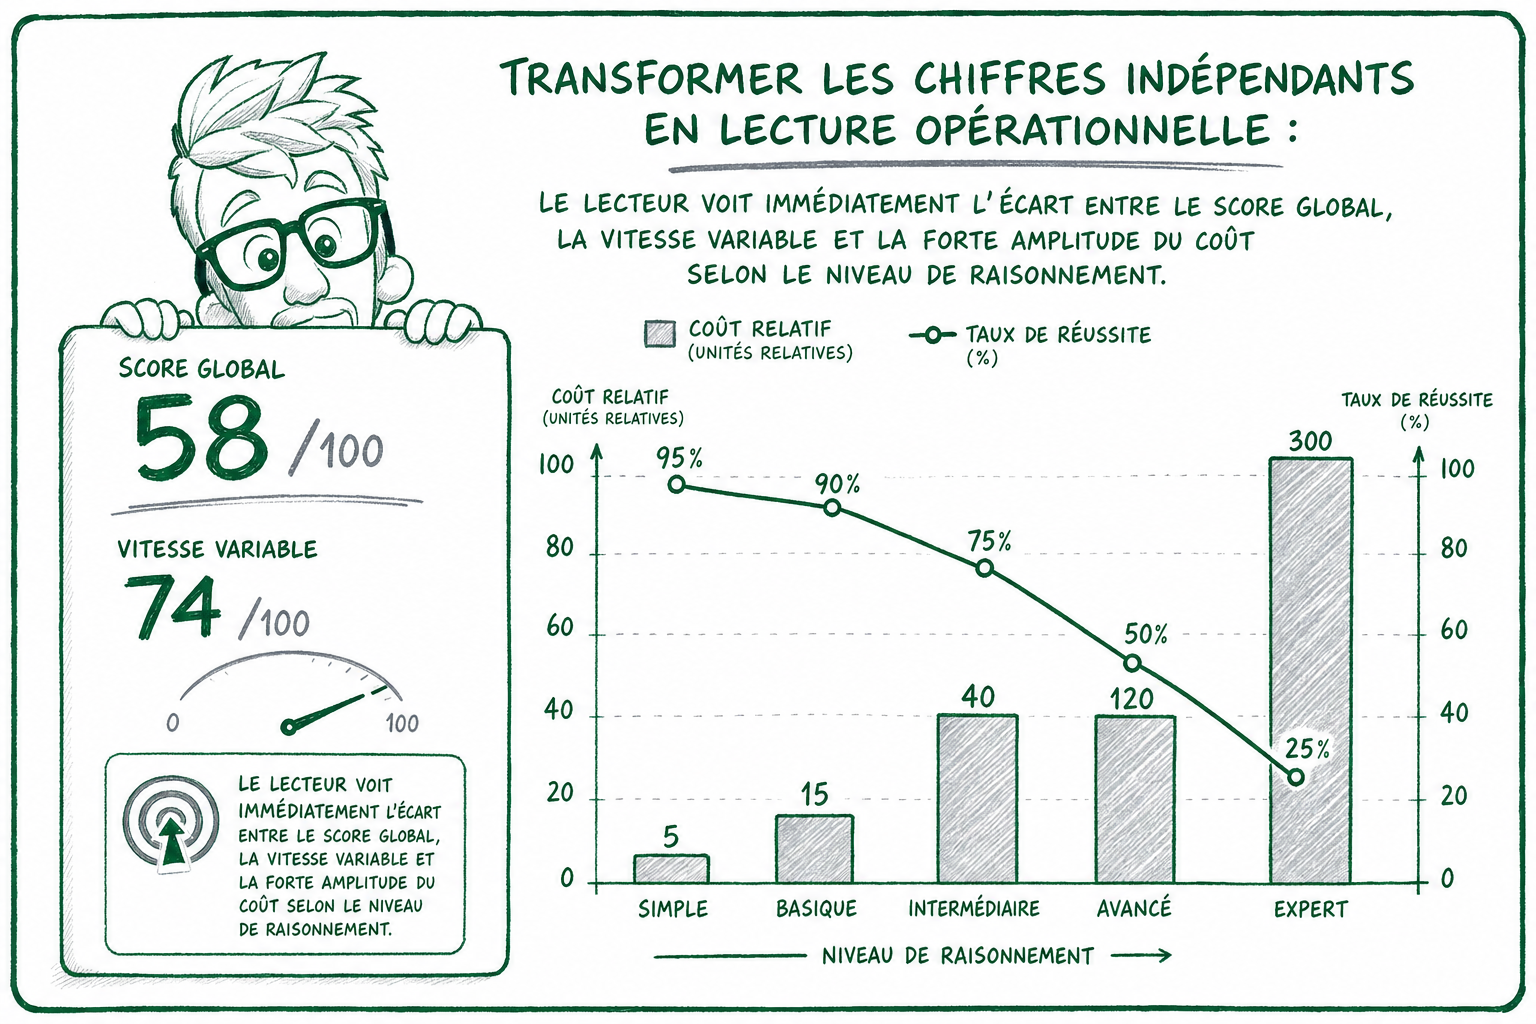
Mais le point le plus intéressant, pour moi, c’est le reste. La vitesse de sortie varie entre 74 et 86 tokens par seconde selon l’effort demandé. Un token, pour faire simple, c’est un morceau de texte traité ou généré par le modèle. Plus la sortie est rapide, plus l’expérience est fluide dans un outil interactif, un assistant de dev, un agent support ou un workflow interne.
Le coût par tâche, lui, va de 0,55 $ à 5,98 $ selon le réglage de raisonnement. Et là, ça change tout. Si vous mettez le raisonnement au maximum pour corriger une faute dans un email, classer un ticket simple ou reformuler une description produit, vous payez trop cher. Pas un peu trop cher. Vraiment trop cher.

Le bon réglage compte autant que le choix du modèle. C’est moins sexy qu’un classement global, mais c’est ce qui fait la différence en production. Une tâche simple doit tourner avec un effort faible. Une tâche risquée, longue ou coûteuse en erreur peut justifier un raisonnement plus élevé. C’est comme ça que le modèle devient intéressant opérationnellement.
J’ai souvent vu des équipes comparer des modèles avec un seul chiffre. Le meilleur benchmark, le meilleur score, le plus gros modèle. Puis en production, elles découvrent que la latence, le volume de tokens et le taux de reprise humaine comptent plus que le classement global. Si un modèle est excellent mais trop lent, trop cher, ou oblige encore un humain à reprendre 30 % des sorties, le ROI tombe vite.
| Indicateur | Donnée disponible | Lecture pratique |
| Intelligence Index | 58 au raisonnement maximal | Très haut niveau, mais pas suffisant seul |
| Vitesse de sortie | 74 à 86 tokens par seconde | Bon signal pour les workflows interactifs |
| Coût par tâche | 0,55 $ à 5,98 $ | Le paramétrage peut changer complètement le ROI |
Pourquoi le code est le gros sujet ?
Le code est le gros sujet parce qu’Opus 5.5 semble mieux tenir les tâches longues, complexes et autonomes. C’est là que je regarde en premier avec un modèle IA pour développeurs. Pas sur un petit script propre de 80 lignes. Sur une vraie base, avec de la dette, des dépendances, des conventions internes, des tests qui cassent pour de mauvaises raisons.
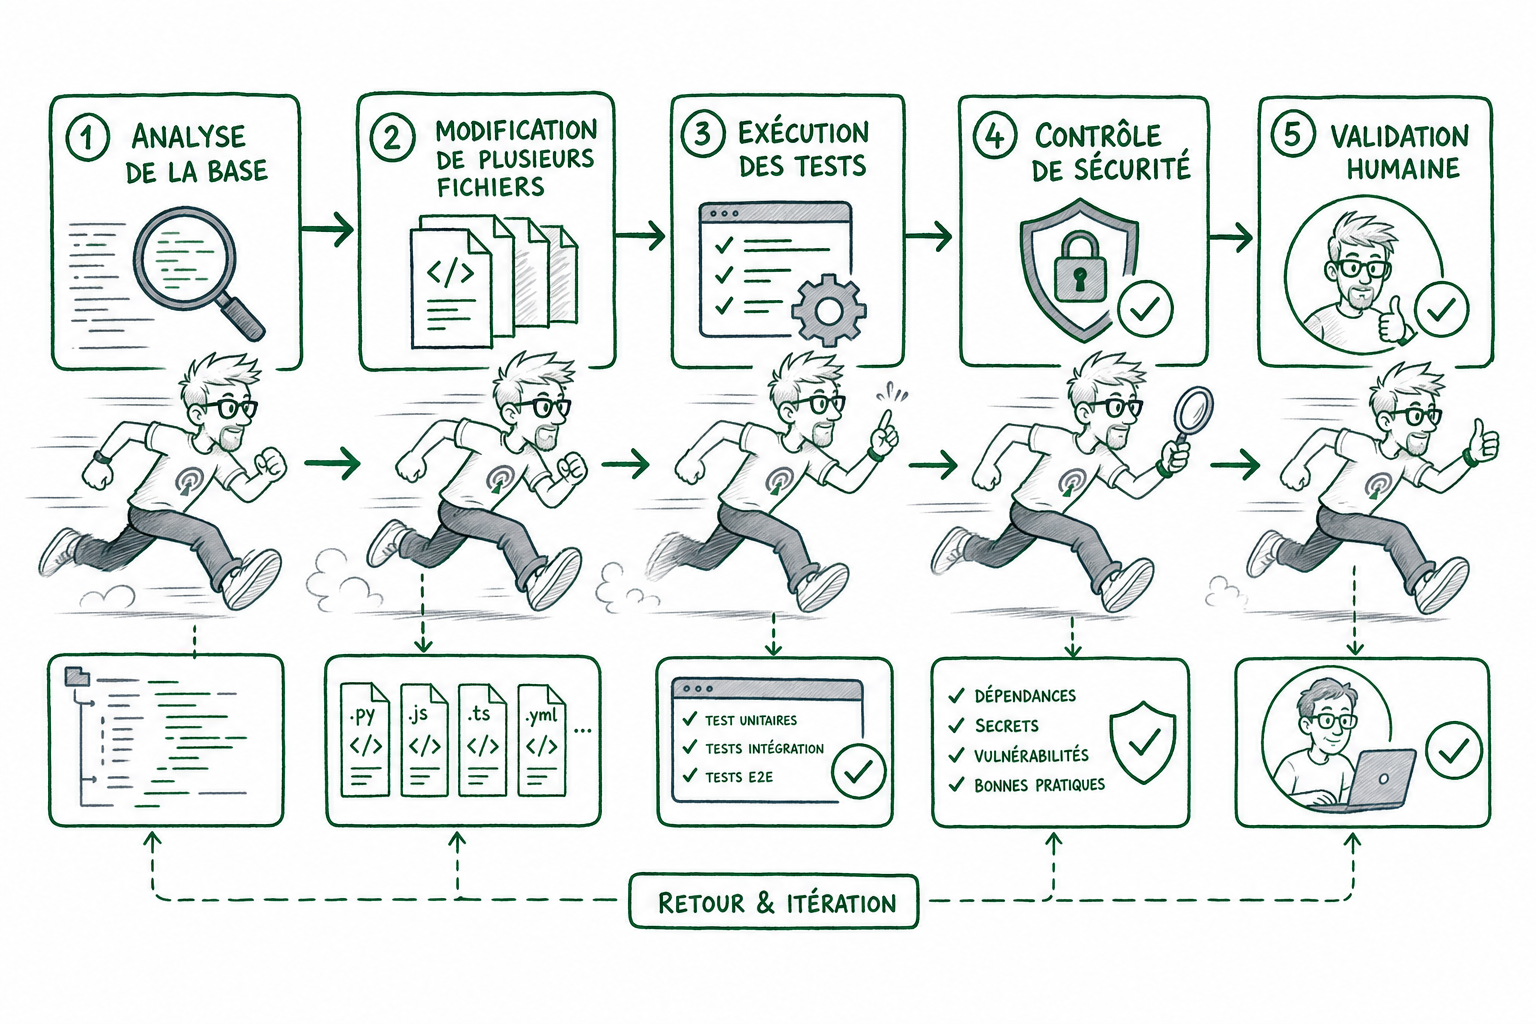
Les exemples disponibles vont clairement dans ce sens. Une migration de 680 000 lignes de code aurait été réalisée en moins d’une journée. Un audit avec correctif sur une base de 200 000 lignes aurait pris moins de trois heures. Et sur un test interne de traduction de HAProxy du C vers Rust, Opus 5.5 termine plus vite et à moindre coût que Fable 5.1. Ça ne veut pas dire que votre monorepo va se transformer tout seul vendredi soir. Mais ça donne une tendance intéressante.
| Cas testé | Signal intéressant |
| Migration de 680 000 lignes | Tâche longue tenue sur une grosse base |
| Audit et correctif de 200 000 lignes | Capacité à analyser puis modifier rapidement |
| HAProxy C vers Rust | Exécution plus rapide et moins coûteuse que Fable 5.1 |
Des gains de coût sont aussi rapportés sur plusieurs benchmarks face à GPT-6 Astra, GPT-5.6 Sol et d’autres modèles. Je reste prudent, parce qu’un benchmark n’est pas votre code, votre CI, vos règles métier, ni vos vieux choix d’architecture. Mais quand plusieurs signaux vont dans le même sens, ça mérite un vrai test.
Les retours de GitHub, Clio, Lovable, Quantium, Spotify, Optiver et Kiro pointent surtout vers des gains très concrets pour les équipes dev : moins de tokens consommés, moins d’étapes, moins d’appels, moins d’interventions humaines, ou une meilleure qualité finale. Pour moi, le vrai sujet est là. Si le modèle peut travailler plus longtemps sans qu’un développeur doive le relancer toutes les dix minutes, on change de catégorie.
Côté sécurité, Opus 5.5 ajoute trois protections dédiées au codage : un classifieur avant exécution, un sandbox open source, et une revue de code automatisée. Le sandbox, c’est l’environnement isolé qui limite les dégâts si une action part de travers. Sur les attaques par prompt injection, quand une entrée tente de manipuler le modèle, Anthropic affirme des performances au moins équivalentes à Opus 5. Gray Swan signale aussi un résultat au plus bas niveau observé, à égalité avec Fable 5.1.
Voilà la checklist que j’utiliserais avant de l’intégrer dans un workflow dev sérieux :
- Choisir une base de code représentative, pas un exemple jouet.
- Mesurer le coût par tâche avec plusieurs niveaux d’effort.
- Suivre le nombre d’appels, de tokens et d’interventions humaines.
- Contrôler les corrections avec revue humaine.
- Tester les protections face aux entrées non fiables.
Est-il meilleur sur le travail de connaissance ?
Opus 5.5 semble surtout progresser sur un truc très concret : le travail de connaissance pénible. Pas juste répondre à une question simple, mais retrouver des infos dispersées, les croiser, les remettre dans le bon ordre et produire quelque chose d’exploitable.
Le test interne le plus parlant, c’est la rédaction d’un rapport de résultats financiers. Opus 5.5 réussit 16 tentatives sur 18. Fable 5.1 et Opus 5 échouent systématiquement sur le même exercice. Pour moi, c’est intéressant parce que ce genre de tâche ressemble beaucoup à ce qu’on voit en entreprise : des chiffres à vérifier, des sources pas toujours évidentes, des passages ambigus, et une synthèse finale qui doit tenir debout.
Le point important, ce n’est pas seulement “il répond mieux”. C’est plutôt “il évite plus souvent de vous faire perdre 40 minutes derrière”. Moins d’oublis. Moins de contradictions. Moins de passages à reprendre parce que le modèle a raté une information planquée dans un document ou mal relié deux éléments.
Les autres exemples vont dans le même sens. Chez Walleye Capital, Opus 5.5 est présenté comme plus efficace pour des tâches où il faut analyser et structurer de l’information avec précision. Dans un test de fusion d’entreprise fictive, il est aussi plus rapide, moins coûteux et moins sujet aux erreurs. Je reste prudent avec ce type de benchmark, parce que le contexte exact compte toujours, mais la tendance est claire : quand le dossier est dense, Opus 5.5 semble mieux tenir la charge.
Les usages business évidents sont assez nombreux :
- Analyse financière avec plusieurs sources à réconcilier.
- Synthèse documentaire longue, par exemple sur des contrats, rapports ou notes internes.
- Due diligence, c’est-à-dire l’analyse détaillée d’une entreprise avant investissement, acquisition ou partenariat.
- Préparation de rapports où il faut éviter les trous dans la raquette.
- Recherche d’informations dispersées dans des documents peu pratiques.
Je le vois souvent chez les clients : le vrai coût n’est pas la première réponse de l’IA. Le vrai coût, c’est la reprise. C’est l’aller-retour. C’est le moment où quelqu’un doit tout relire parce qu’on ne sait plus si le modèle a oublié un élément clé.
| Cas d’usage | Intérêt d’Opus 5.5 |
| Rapport financier complexe | Fort, surtout avec sources difficiles à retrouver |
| Recherche documentaire longue | Fort si la qualité et la réduction des erreurs comptent |
| Tâche simple et répétitive | À tester seulement si le coût reste maîtrisé |
| Analyse critique à enjeu élevé | Utile, mais avec validation humaine obligatoire |
Alors, faut-il vraiment tester Claude Opus 5.5 maintenant ?
Claude Opus 5.5 n’est pas juste une mise à jour cosmétique. Les signaux les plus solides sont sur le codage agentique, les tâches de connaissance difficiles, la vitesse et le coût typique. Je retiens surtout une chose : il faut l’évaluer sur vos vrais workflows, pas sur un classement global. Les benchmarks donnent une direction, mais le ROI se voit dans les tokens consommés, les reprises humaines, le temps gagné et la qualité finale. Si vous faites du code, de l’analyse ou des rapports complexes, vous avez probablement intérêt à le tester proprement. Le bénéfice pour vous, c’est une IA plus opérationnelle, pas juste plus impressionnante.
FAQ
- Claude Opus 5.5 est-il vraiment meilleur qu’Opus 5 ?
Oui dans les faits rapportés, surtout sur le codage agentique, les tâches de connaissance, la vitesse de sortie, le coût typique et la clarté d’écriture. Je resterais quand même prudent sur une comparaison basée uniquement sur des benchmarks. - Quel est le principal avantage de Claude Opus 5.5 pour les développeurs ?
Le principal avantage, c’est sa capacité à mieux gérer des tâches de code longues et complexes. Les exemples cités parlent de migration massive, d’audit de grandes bases de code et de traduction C vers Rust avec de meilleurs résultats de temps et de coût. - Claude Opus 5.5 coûte-t-il moins cher à utiliser ?
Le coût typique est annoncé comme inférieur de 40 %, mais le coût réel dépend beaucoup du réglage de raisonnement. Les données indépendantes citées montrent un coût par tâche pouvant aller de 0,55 $ à 5,98 $ selon l’effort demandé. - Les benchmarks suffisent-ils pour choisir Claude Opus 5.5 ?
Non, pas seuls. À ce niveau de performance, les benchmarks deviennent moins discriminants. Il faut aussi regarder la vitesse, le nombre de tokens, les reprises humaines, les erreurs, le coût par tâche et la qualité sur vos vrais cas d’usage. - Claude Opus 5.5 est-il adapté aux tâches de connaissance complexes ?
Oui, les éléments disponibles vont clairement dans ce sens. Un test interne de rapport financier montre 16 réussites sur 18 pour Opus 5.5, là où Fable 5.1 et Opus 5 échouent systématiquement. C’est intéressant pour l’analyse, la synthèse et la recherche documentaire difficile.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des entreprises sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA dans les process métier et le SEO/GEO. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez tester l’IA sérieusement dans vos workflows business, avec des métriques propres et pas juste des démos sympas, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.