

Vous la contrôlez seulement si vous savez où vos données partent, qui y accède, comment elles sont traitées et ce que vous pouvez auditer. La propriété ne suffit pas. Je vous montre comment cadrer collecte, stockage, exports, accès et souveraineté sans vous raconter d’histoires.
Que veut dire gouverner ses données analytics ?
Gouverner ses données analytics, ce n’est pas juste “avoir GA4”, “avoir Matomo” ou “avoir accès aux dashboards”. C’est définir et faire appliquer des règles concrètes sur la collecte, le traitement, l’accès, le stockage, le partage, l’export et l’usage des données.
Le vrai sujet, ce n’est pas seulement de posséder les données. C’est de savoir ce que vous pouvez réellement faire avec elles. Qui peut les lire ? Qui peut les exporter ? Où sont-elles stockées ? Combien de temps ? Qui peut les croiser avec des données CRM ? Et surtout, qu’est-ce que vous pouvez prouver si quelqu’un vous audite demain matin ?
Je distingue toujours trois notions, parce qu’elles sont souvent mélangées.
- Propriété : C’est qui détient les droits ou la responsabilité des données. Exemple simple : votre entreprise est responsable des données de navigation collectées sur son site, même si l’outil analytics est fourni par un prestataire.
- Contrôle : C’est ce que vous pouvez réellement décider, modifier, limiter, exporter, supprimer ou auditer. Exemple : vous avez peut-être un accès admin à l’outil, mais pouvez-vous supprimer un utilisateur, désactiver un export automatique vers BigQuery, ou vérifier qui a consulté les données ?
- Souveraineté : C’est le cadre juridique, contractuel et organisationnel qui encadre la localisation, les traitements et les accès. Exemple : vos données analytics sont-elles hébergées dans l’Union européenne ? Un support externe peut-il y accéder ? Sous quelles conditions ?
J’ai déjà vu des équipes persuadées de maîtriser leurs données simplement parce qu’elles avaient un accès admin à l’outil analytics. En creusant un peu, personne ne savait où étaient les logs, les sauvegardes, ni les exports automatiques envoyés chaque nuit à d’autres plateformes. Là, on n’est pas dans le contrôle. On est dans la confiance un peu floue.
Le RGPD renforce cette logique. Il demande de limiter ce qu’on collecte, de collecter pour des finalités claires, de sécuriser les accès, et d’être capable de démontrer la conformité. Le mot important, c’est “démontrer”. Pas juste dire “normalement c’est bon”. Montrer qui a accès, pourquoi, depuis quand, avec quelles règles.
| Notion | Question à se poser | Risque si c’est flou |
| Propriété | Qui est responsable des données analytics ? | Personne n’assume vraiment en cas de problème. |
| Contrôle | Que peut-on limiter, supprimer, exporter ou auditer ? | Les données circulent sans maîtrise réelle. |
| Souveraineté | Où sont les données et qui peut y accéder ? | Vous découvrez trop tard un risque juridique ou contractuel. |
Où sont stockées et traitées vos données ?
Quand je regarde une configuration analytics, je ne m’arrête jamais à la région choisie dans l’interface. C’est utile, oui, mais ça ne dit pas où les données vivent vraiment, ni où elles passent, ni qui les touche au passage.
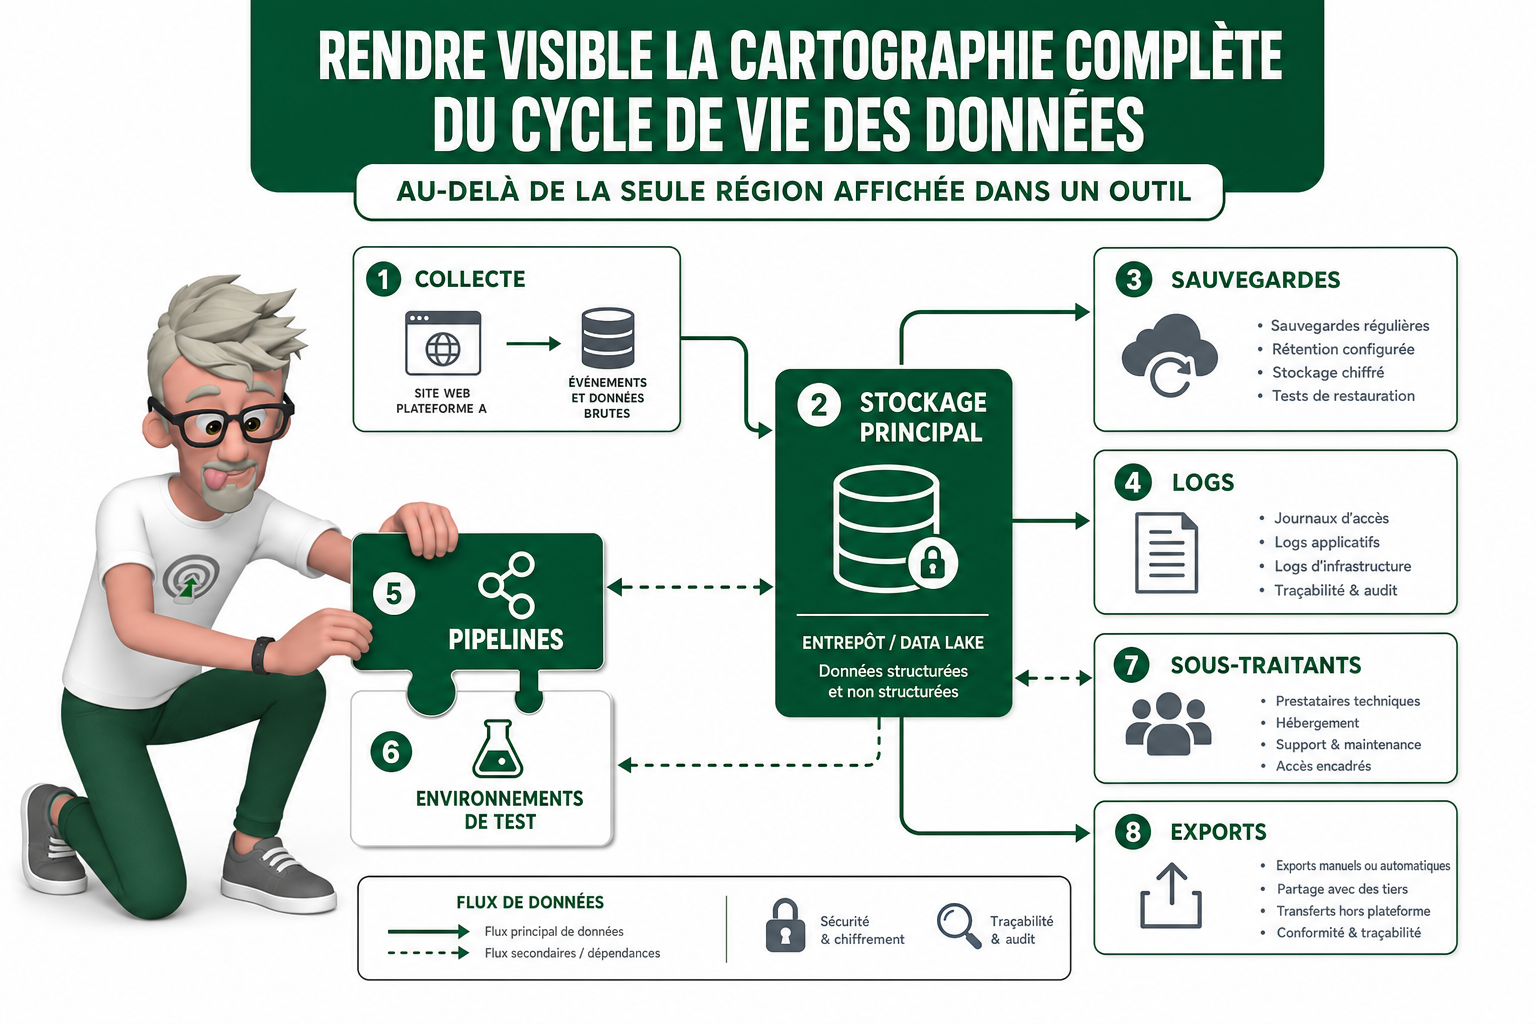
Il faut cartographier précisément les lieux de stockage et de traitement. Pas juste cocher “Europe” ou “France” dans un outil. Une donnée peut être hébergée dans une région acceptable et quand même être exposée via un export automatique, un connecteur marketing, un log technique trop bavard ou un environnement de test oublié.
Les zones à vérifier sont souvent plus nombreuses qu’on le pense :
- Bases de données principales : Là où les événements analytics, profils utilisateurs, identifiants et sessions sont stockés.
- Sauvegardes : Une sauvegarde peut partir dans une autre région, avec une durée de conservation différente.
- Logs techniques : Les logs peuvent contenir des IP, emails, IDs clients ou payloads complets si personne n’a nettoyé la configuration.
- Files d’attente ou pipelines de traitement : Kafka, Pub/Sub, ETL, reverse ETL… Tout ce qui transporte ou transforme la donnée compte.
- Environnements de test ou de recette : C’est souvent là que des données réelles traînent sans les mêmes contrôles que la production.
- Sous-traitants et services tiers : Hébergeur cloud, outil de support, enrichissement, monitoring, tag manager, CDP, tout doit être listé.
- Exports : Data warehouse, CRM, outils publicitaires, BI, automatisations no-code, fichiers CSV envoyés “temporairement”.
La résidence des données reste importante, surtout si votre contrat, votre politique interne ou une réglementation impose un territoire précis. Mais elle ne prouve pas à elle seule que vous maîtrisez votre gouvernance. Le vrai sujet, c’est le cycle complet de la donnée.

Les équipes juridiques, achats et sécurité ne peuvent pas valider sérieusement une solution si elles ne savent pas quels fournisseurs interviennent, quelles données circulent, où elles circulent, combien de temps elles sont conservées et qui peut y accéder. Sans ça, elles valident une promesse, pas un dispositif contrôlé.
Dans les audits analytics que j’ai vus, le problème vient rarement d’un seul gros outil mal choisi. Il vient plutôt des petits branchements oubliés. Un tracking ajouté vite fait, un dashboard partagé trop largement, un export CSV mensuel, un connecteur marketing branché par une équipe, puis un entrepôt de données qui récupère tout ça sans documentation claire.
Les questions simples à poser :
- Où sont stockées les données principales, les sauvegardes et les logs ?
- Quels sous-traitants interviennent dans le traitement analytics ?
- Quelles données sortent vers le CRM, la BI, la publicité ou les automatisations ?
- Combien de temps chaque copie de donnée est-elle conservée ?
- Qui peut accéder aux données, chez nous et chez les fournisseurs ?
- Les environnements de test utilisent-ils des données réelles ou anonymisées ?
- Existe-t-il une cartographie à jour des flux analytics ?
Qui peut accéder aux données analytics ?
Je peux connaître parfaitement où sont stockées mes données analytics, dans GA4, BigQuery, Power BI, Looker Studio, un CRM ou un export CSV perdu dans un Drive. Si je ne sais pas qui y accède, ce contrôle reste fragile. On contrôle vraiment ses données seulement quand les accès sont connus, justifiés, limités et revus régulièrement.
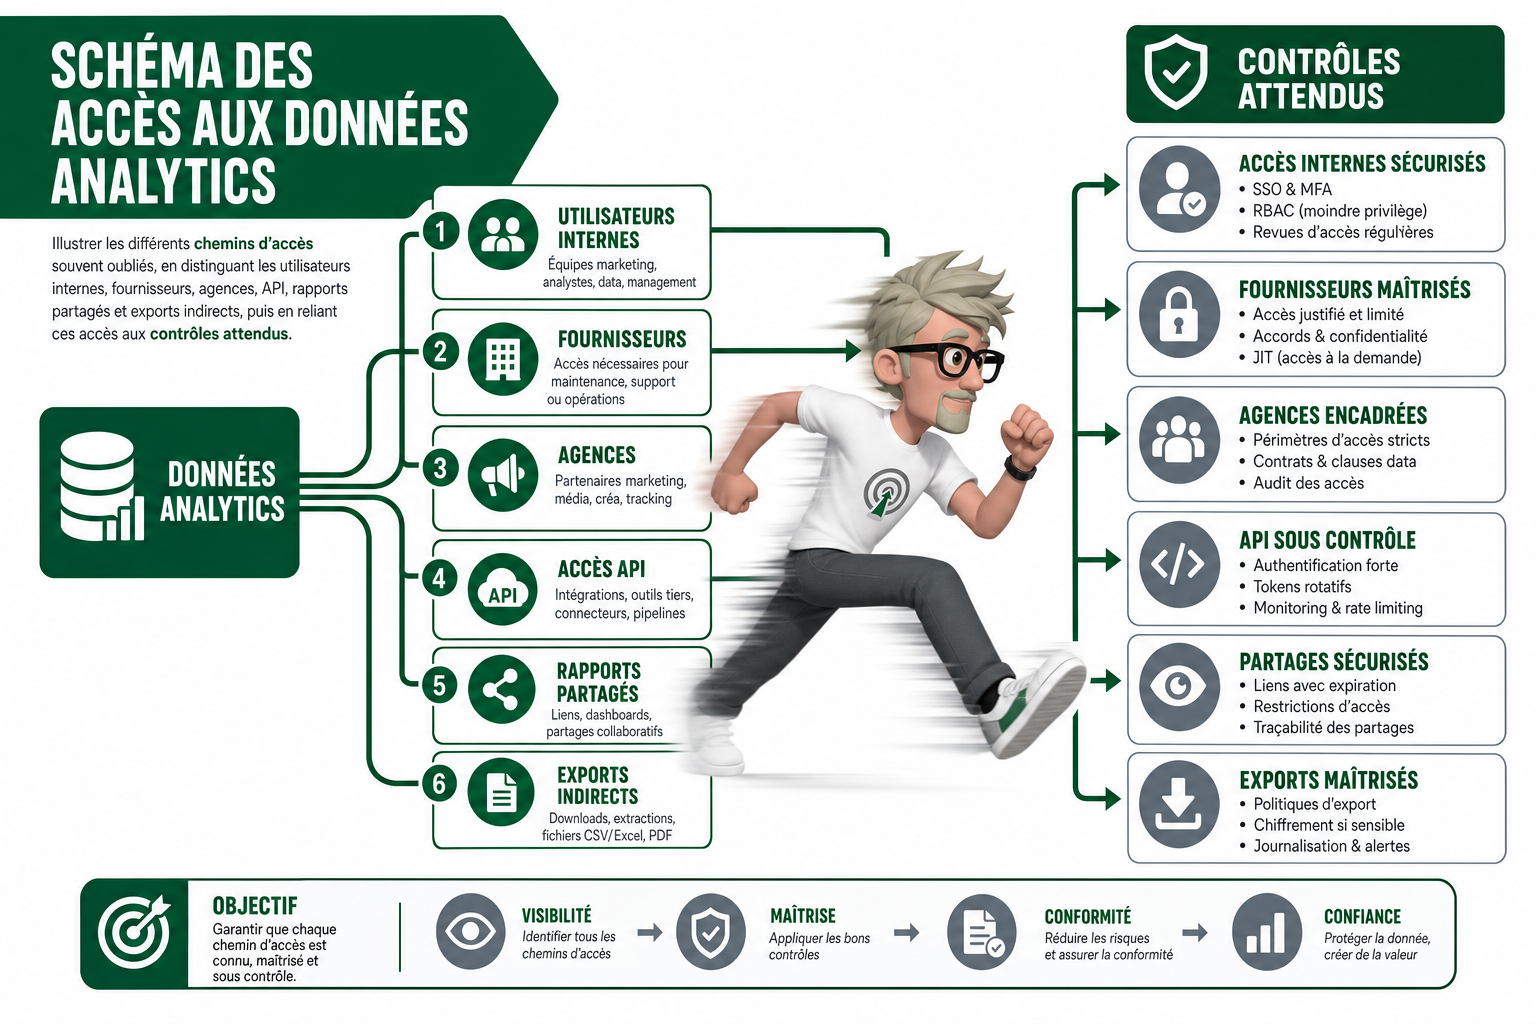
Il faut distinguer plusieurs types d’accès. L’accès interne concerne vos équipes, par exemple marketing, data, produit ou direction. L’accès fournisseur concerne un outil ou un éditeur qui traite vos données. L’accès sous-traitant concerne une agence, un freelance, un cabinet externe. L’accès API, c’est l’accès machine à machine, via une interface qui permet à deux systèmes d’échanger des données. Et il y a l’accès indirect, souvent sous-estimé, via rapports partagés, exports, emails automatisés ou tableaux de bord publics.

Un tableau de bord partagé peut exposer autant d’information qu’un accès direct à une base. J’ai déjà vu un client verrouiller BigQuery correctement, puis laisser un rapport Looker Studio ouvert à “toute personne avec le lien”. Techniquement, la base était protégée. Dans les faits, les données ne l’étaient pas.
Les contrôles à mettre en place sont simples à comprendre, mais ils demandent de la discipline :
- Définir les rôles selon le besoin réel, pas selon le confort.
- Appliquer le principe du moindre privilège, c’est-à-dire donner uniquement les droits nécessaires.
- Faire valider les accès sensibles, surtout sur les données personnelles, commerciales ou financières.
- Journaliser les connexions et les actions importantes comme les exports, suppressions ou changements de droits.
- Revoir périodiquement les comptes actifs, au moins tous les trimestres.
- Supprimer vite les accès après un départ, un changement de poste ou la fin d’une mission.
- Contrôler les accès API, les tokens et les connecteurs, parce qu’un token oublié peut rester actif pendant des mois.
L’auditabilité est le vrai test. Je dois pouvoir répondre simplement à ces questions : Qui a consulté ces données ? Qui les a modifiées ? Qui les a exportées ? Qui les a partagées ? Si personne ne peut répondre, le contrôle est surtout théorique.
| Profil | Accès utile | Risque | Contrôle recommandé |
| Admin | Configuration, droits, sécurité | Accès trop large, erreurs critiques | Validation forte, journalisation, revue fréquente |
| Analyste | Données détaillées, modèles, rapports | Exports massifs, données sensibles | Moindre privilège, traçabilité des exports |
| Marketing | Rapports de performance, audiences | Partage externe, mauvaise segmentation | Accès par rôle, rapports limités |
| Agence | Campagnes, dashboards, tags | Accès conservé après mission | Date de fin, revue mensuelle, droits limités |
| Fournisseur | Traitement technique ou logiciel | Dépendance, accès opaque | Contrat, logs, périmètre clair |
| API | Synchronisation entre outils | Token oublié, extraction silencieuse | Rotation des tokens, scopes limités, monitoring |
Comment encadrer les exports et les usages ?
Je vois souvent la gouvernance analytics très propre dans l’outil, puis complètement floue dès que la donnée sort. C’est là que ça se perd. Un export CSV envoyé à la mauvaise personne, un rapport automatique oublié, une synchro vers un entrepôt de données, et votre contrôle devient théorique.
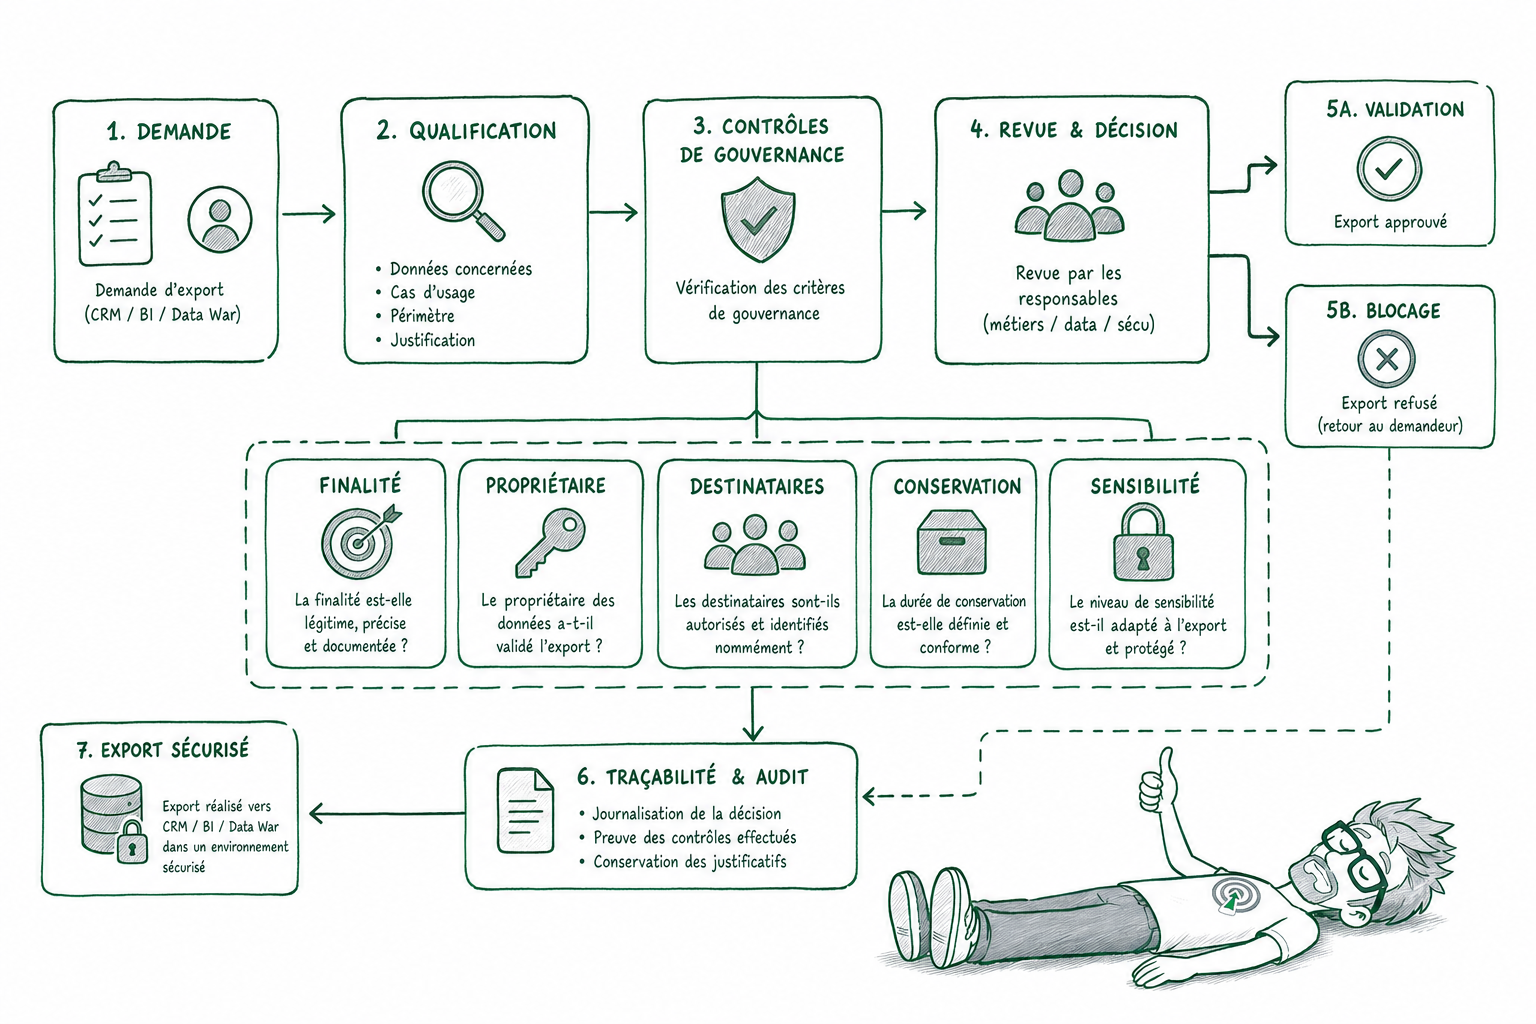
Je surveille donc toutes les sorties, pas seulement les accès à l’interface analytics. Les cas les plus fréquents sont simples à identifier :
- Exports manuels CSV ou Excel.
- Exports planifiés par email.
- Connecteurs vers des outils BI, comme Looker Studio, Power BI ou Tableau.
- Synchronisations vers un data warehouse, c’est-à-dire un entrepôt central où l’entreprise regroupe ses données.
- Envois vers des outils publicitaires ou CRM.
- Automatisations no-code ou low-code, par exemple via Make, Zapier ou n8n.
- Accès API utilisés par des scripts ou des applications internes.
Pour chaque export, je veux au minimum cinq choses. Une finalité claire, un propriétaire, une durée de conservation, une liste de destinataires, et un niveau de sensibilité. Sans ça, l’export n’est pas gouverné. Il est juste “pratique”. Et “pratique” finit souvent par devenir risqué.
La donnée analytics peut avoir l’air peu sensible. Des pages vues, des sources de trafic, des événements, des conversions. Mais dès qu’on croise ça avec un CRM, des campagnes média, des emails ou des transactions, on peut reconstituer des comportements clients beaucoup plus précis. C’est souvent là que le niveau de risque change.
Exemple simple. Une entreprise exporte automatiquement les conversions analytics vers son outil marketing ou son data warehouse. Je documente pourquoi cet export existe, qui l’a demandé, quelles conversions sont envoyées, à quelle fréquence, qui peut les lire, combien de temps elles sont conservées, et si elles contiennent ou non des identifiants utilisateur. Pas besoin d’écrire un roman technique. Il faut juste assez d’informations pour comprendre l’usage et reprendre le contrôle si quelqu’un part, si l’outil change, ou si une demande juridique tombe.
Je regarde aussi la qualité des rapports. Un rapport peut être conforme techniquement et quand même dangereux pour le business. Si les noms d’événements ne sont pas communs, si le consentement n’est pas pris en compte, si le périmètre est flou, ou si l’attribution marketing mélange plusieurs règles, vous prenez des décisions sur une base fragile. J’ai déjà vu des budgets coupés à cause d’un tableau “propre”, mais mal défini.
| Question | Décision |
| L’usage est-il clair et utile ? | Sinon, je refuse l’export. |
| Un propriétaire est-il identifié ? | Sinon, je bloque ou je limite. |
| Les destinataires sont-ils connus ? | Sinon, je refuse l’envoi automatique. |
| La durée de conservation est-elle définie ? | Sinon, je demande une règle avant activation. |
| Le niveau de sensibilité est-il évalué après croisement possible ? | Sinon, je fais revoir le risque. |
| Le rapport suit-il les règles de nommage, consentement, périmètre et attribution ? | Sinon, je ne le considère pas fiable. |
Quelle checklist utiliser avant de valider un outil ?
Avant de valider un outil analytics, je veux savoir une chose simple : est-ce qu’on comprend vraiment ce qu’il collecte, où ça part, qui y touche, et combien de temps ça reste. Si la réponse est floue, l’outil n’est pas prêt.
Ma checklist de validation est très concrète :
- Identifier les données collectées. Page vue, clic, email, identifiant client, IP, transaction, événement produit… Chaque donnée doit avoir une finalité claire. Pas de “on verra plus tard”.
- Vérifier où les données sont stockées et traitées. Pays, région cloud, serveurs, transferts hors UE. Le juridique et la sécurité doivent pouvoir répondre sans fouiller pendant trois jours.
- Lister les fournisseurs et sous-traitants. L’éditeur principal, ses sous-traitants techniques, les outils connectés. C’est souvent là que les angles morts apparaissent.
- Documenter les accès internes et externes. Qui peut voir quoi ? Marketing, data, support, agence, freelance, éditeur. Un accès admin donné “temporairement” finit souvent permanent.
- Contrôler les exports, API et connecteurs. CSV, Google Sheets, CRM, CDP, warehouse, webhook. Une API ouverte sans limite peut devenir une fuite proprement emballée.
- Vérifier les durées de conservation. Garder 25 mois, 13 mois ou 90 jours, ça change tout. Il faut une règle, pas une valeur par défaut oubliée.
- Confirmer la suppression ou l’anonymisation. Si une personne demande l’effacement, ou si la donnée n’est plus utile, on doit savoir quoi faire et le prouver.
- Auditer les logs. Les logs montrent qui s’est connecté, qui a exporté, qui a modifié une règle. Sans logs, on pilote à l’aveugle.
- Valider l’alignement avec le RGPD, la sécurité, les achats et les politiques internes. Le RGPD encadre les données personnelles. Les achats regardent le contrat. La sécurité regarde le risque. Tout le monde doit parler du même outil.
- Prévoir une revue régulière. Une configuration analytics bouge vite. Une nouvelle balise, un connecteur ajouté, un export automatique, et le périmètre change.
Cette checklist ne doit pas finir dans un dossier oublié. Elle sert à décider vraiment : accepter l’outil, demander une clause contractuelle, limiter un export, réduire une durée de conservation, bloquer un connecteur, ou revoir une configuration.
Avec les clients, je vois toujours la même chose : un bon dispositif analytics n’est pas celui qui collecte tout, c’est celui qui collecte ce qui est utile, explicable et maîtrisable.
| Sujet | Preuve attendue | Responsable | Fréquence de revue |
| Données collectées | Liste des événements, propriétés et finalités | Data / Marketing | À chaque changement de tracking |
| Stockage et traitement | Pays, région cloud, documentation fournisseur | Sécurité / Juridique | Avant achat puis annuel |
| Fournisseurs | Liste des sous-traitants et clauses contractuelles | Achats / Juridique | Avant signature puis annuel |
| Accès | Matrice des rôles et comptes actifs | Data / Sécurité | Trimestriel |
| Exports et connecteurs | Inventaire des API, exports et destinations | Data / IT | Mensuel |
| Conservation et suppression | Règles de rétention, procédure d’effacement ou anonymisation | Juridique / Data | Semestriel |
Alors, vous contrôlez vraiment vos données analytics ?
La gouvernance data analytics, ce n’est pas un document pour rassurer tout le monde. C’est une capacité réelle à savoir où vont les données, qui les touche, comment elles sont stockées, exportées, utilisées et auditées. La résidence des données compte, bien sûr, mais elle ne règle pas tout. Le contrôle se joue dans les accès, les sous-traitants, les sauvegardes, les rapports, les API et les usages business. Si vous posez ces questions tôt, vous évitez les angles morts, les mauvaises décisions et les audits douloureux. Le bénéfice est simple pour vous : des données analytics exploitables, défendables et vraiment maîtrisées.
FAQ
- Qu’est-ce que la gouvernance data analytics ?
La gouvernance data analytics regroupe les règles, contrôles et processus qui encadrent la collecte, le traitement, l’accès, le stockage, le partage, l’export et l’utilisation des données analytics. L’objectif est simple : savoir ce qu’on collecte, pourquoi, où ça va, qui y accède et comment on peut le prouver. - Quelle est la différence entre propriété et contrôle des données ?
La propriété indique qui détient les droits ou la responsabilité des données. Le contrôle indique ce que l’entreprise peut réellement faire : limiter les accès, auditer les traitements, exporter, supprimer, documenter ou bloquer certains usages. On peut être propriétaire sur le papier et avoir un contrôle très faible en pratique. - La résidence des données suffit-elle pour être conforme ?
Non. La résidence des données est importante, mais elle ne suffit pas. Il faut aussi regarder les sous-traitants, les accès, les sauvegardes, les logs, les exports, les API, les durées de conservation et les règles internes. Une donnée peut être hébergée au bon endroit, mais rester mal gouvernée. - Quels exports analytics faut-il surveiller en priorité ?
Je surveille en priorité les exports automatiques vers les outils BI, data warehouse, CRM, plateformes publicitaires, emails planifiés, fichiers CSV et connecteurs no-code. Ce sont souvent ces flux secondaires qui créent les vrais angles morts, surtout quand personne ne sait qui les a créés ni pourquoi. - Qui doit piloter la gouvernance des données analytics ?
Le pilotage doit être partagé entre data, marketing, juridique, sécurité et achats. La data comprend les flux, le marketing connaît les usages, le juridique cadre les obligations, la sécurité vérifie les risques et les achats regardent les contrats fournisseurs. Sans ce travail collectif, la gouvernance reste théorique.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, analytics engineering, automatisation no/low code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes data, marketing et digitales sur des sujets très concrets de collecte, gouvernance, qualité et activation de la donnée. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’ai travaillé pour des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez remettre à plat votre tracking, vos flux analytics ou vos automatisations data, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.