

On automatise les rapports GA4 en définissant d’abord leurs règles de mesure, puis en contrôlant les champs, les accès et les quotas de l’API. Le vrai enjeu est de produire des données cohérentes dans la durée, sans requêtes inutiles ni responsabilités floues.
Que faut-il définir avant d’automatiser un rapport GA4 ?
Je définis le contrat du rapport avant de connecter l’API Data GA4 ou un tableau de bord. Sans ce cadrage, l’automatisation risque de produire des chiffres techniquement cohérents, mais interprétés différemment selon les équipes.
Je formalise les décisions qui déterminent ce que le rapport doit restituer et dans quelles conditions :
- Objectif : quelle décision ou quel suivi le rapport doit-il servir ?
- Utilisateurs : qui consulte les résultats, et quel niveau de détail leur est utile ?
- Fréquence d’actualisation : à quelle cadence les données doivent-elles être récupérées ?
- Période analysée : quelles dates, quelle fenêtre temporelle et quel fuseau horaire faut-il appliquer ?
- Métriques et dimensions : quelles mesures et quels axes d’analyse sont nécessaires ?
- Filtres : quelles données inclure ou exclure, avec quelles conditions ?
- Règles de mesure : comment traiter les comparaisons, les données manquantes et les changements de définition ?
Un contrat court suffit, à condition qu’il soit explicite et partagé. Par exemple :
- Objectif : suivre l’évolution des indicateurs définis pour le rapport.
- Utilisateurs : équipe en charge de l’analyse.
- Fréquence : actualisation quotidienne.
- Période : les 30 derniers jours, selon le fuseau horaire du compte GA4.
- Métriques : liste des métriques validées dans GA4.
- Dimensions : liste des dimensions nécessaires à la lecture des résultats.
- Filtres : conditions documentées et identiques à chaque exécution.
- Règles : définitions des indicateurs et traitement des valeurs absentes consignés dans la documentation.
Ces définitions doivent être stabilisées et documentées avant l’automatisation. Sinon, une évolution de filtre ou une interprétation différente d’une métrique peut créer une rupture dans les séries ou des écarts entre rapports. Je limite aussi l’extraction au strict nécessaire : chaque champ supplémentaire augmente le volume de données et le risque de requête invalide.
Formez-vous à Google Analytics !
Maîtriser Google Analytics est crucial pour comprendre votre audience, optimiser vos campagnes, améliorer l'expérience utilisateur et mesurer vos conversions... Gagnez du temps avec nos formations Google Analytics.
Le contrat ne garantit pas que toutes les combinaisons de champs sont acceptées par GA4. Chaque combinaison de métriques, dimensions et filtres doit être vérifiée avant d’être utilisée dans la requête API.
Comment vérifier les champs compatibles dans GA4 ?
Vérifiez la compatibilité des dimensions et des métriques avant de construire vos requêtes GA4. Une dimension décrit une donnée — par exemple une source de trafic — tandis qu’une métrique la mesure, comme le nombre de sessions. Toutes les combinaisons ne sont pas valides : l’API peut rejeter la requête ou renvoyer un résultat qui ne répond pas à la question métier. Un rapport techniquement exploitable peut aussi être trompeur si les champs portent sur des périmètres différents.
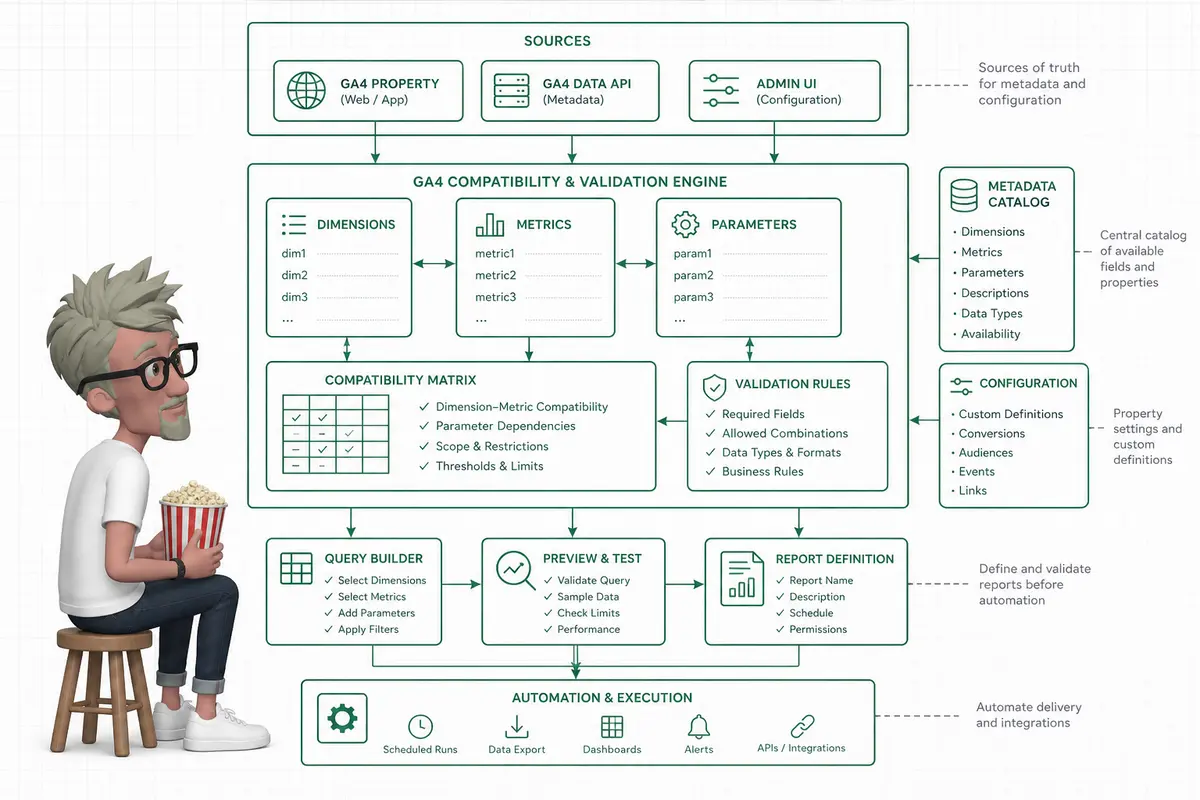
Je valide chaque rapport à partir de son contrat : la question à laquelle il doit répondre, la période, le périmètre de mesure et les champs attendus. Ensuite, je contrôle chaque champ, puis je teste leur combinaison dans une requête limitée avant de lancer l’automatisation.
La validation suit quatre contrôles :
- Partir du contrat du rapport et confirmer que chaque champ contribue à la réponse attendue.
- Vérifier la compatibilité de chaque dimension et métrique, ainsi que leur périmètre de mesure. Le périmètre correspond au niveau auquel la donnée est calculée, par exemple l’événement, la session ou l’utilisateur.
- Tester la combinaison exacte de champs avec une période et un échantillon représentatifs.
- Comparer les résultats à une référence fiable : un rapport GA4 existant, une extraction validée ou un total métier dont la définition est documentée.
Si vous vous appuyez sur une fonction ou un mécanisme précis de l’API Data GA4 pour vérifier les champs ou leur compatibilité, vérifiez son fonctionnement et ses limites dans la documentation officielle à jour. Les noms, règles et capacités de l’API peuvent évoluer.
Ne confondez pas les règles de mesure avec les choix de présentation. Le fuseau horaire, la définition d’une conversion ou le périmètre d’attribution influencent le sens du résultat. Le tri, l’ordre des colonnes et le format d’affichage organisent ce résultat sans en changer la mesure. Je fixe les premières dans le contrat du rapport et traite les seconds dans la restitution.
Une fois les champs validés, l’étape suivante consiste à sécuriser l’accès à la propriété GA4 utilisée : identité d’exécution, droits minimaux nécessaires et gestion des identifiants.
Comment sécuriser l’accès à l’API Data GA4 ?
Je limite l’accès aux personnes et aux processus qui exécutent les rapports, puis je documente qui en est responsable. Avant la mise en production, je précise la propriété GA4 concernée, l’identité utilisée par l’automatisation, son périmètre d’accès, le responsable technique et la procédure de révocation.
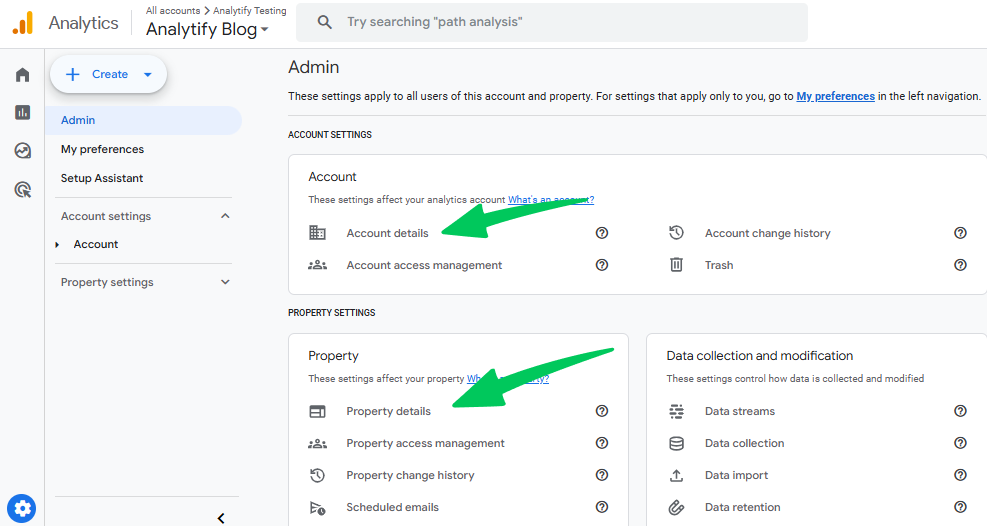
L’identité dépend de l’environnement d’exécution. Un compte de service, une identité fédérée ou un compte utilisateur peuvent convenir selon l’hébergement et le mode d’exploitation. Il n’existe pas de méthode d’authentification universelle. Dans tous les cas, l’identité doit recevoir uniquement le rôle GA4 nécessaire sur la propriété visée. Je préfère éviter les clés de compte de service persistantes quand l’environnement permet une identité fédérée.
Je valide ces éléments avant le déploiement :
- La propriété GA4 autorisée, identifiée par son ID de propriété.
- L’identité exacte utilisée par le processus, et la façon dont ses identifiants sont fournis.
- Le rôle accordé et la propriété à laquelle il s’applique.
- Le responsable technique, ainsi que la procédure pour retirer l’accès ou désactiver l’identité.
Pour un environnement où les identifiants par défaut Google sont déjà configurés, le client officiel Python peut être utilisé ainsi. Cet exemple n’impose pas ce mode d’authentification : il suppose que les identifiants ont été fournis de façon sécurisée par votre environnement. Remplacez les paramètres signalés avant exécution.
# Installer le client officiel : google-analytics-data
from google.analytics.data_v1beta import BetaAnalyticsDataClient
from google.analytics.data_v1beta.types import RunReportRequest, DateRange, Metric

# À remplacer par l'ID de la propriété GA4 autorisée.
PROPERTY_ID = "A_REMPLACER_PAR_ID_PROPRIETE"

client = BetaAnalyticsDataClient()

request = RunReportRequest(
    property=f"properties/{PROPERTY_ID}",
    date_ranges=[DateRange(start_date="7daysAgo", end_date="yesterday")],
    metrics=[Metric(name="sessions")],
)

response = client.run_report(request)
for row in response.rows:
    print(row.metric_values[0].value)
La sécurité passe aussi par la conception des rapports répétés. Je réutilise des requêtes stables, je limite les dimensions et métriques au besoin réel et j’évite de relancer inutilement les mêmes appels. Ça réduit la consommation des quotas de l’API Data GA4 et facilite le suivi des usages. Je définis aussi un propriétaire et une fréquence d’exécution pour chaque automatisation : une identité autorisée ne doit pas devenir un accès permanent sans responsable.
Comment gérer les requêtes répétées et les quotas ?
Je réduis les appels redondants, je limite les données demandées et je surveille la consommation des quotas. Les limites applicables dépendent de la configuration et du contexte du projet : je les vérifie dans la documentation officielle de l’API Google Analytics Data et dans Google Cloud, sans supposer de seuil universel.
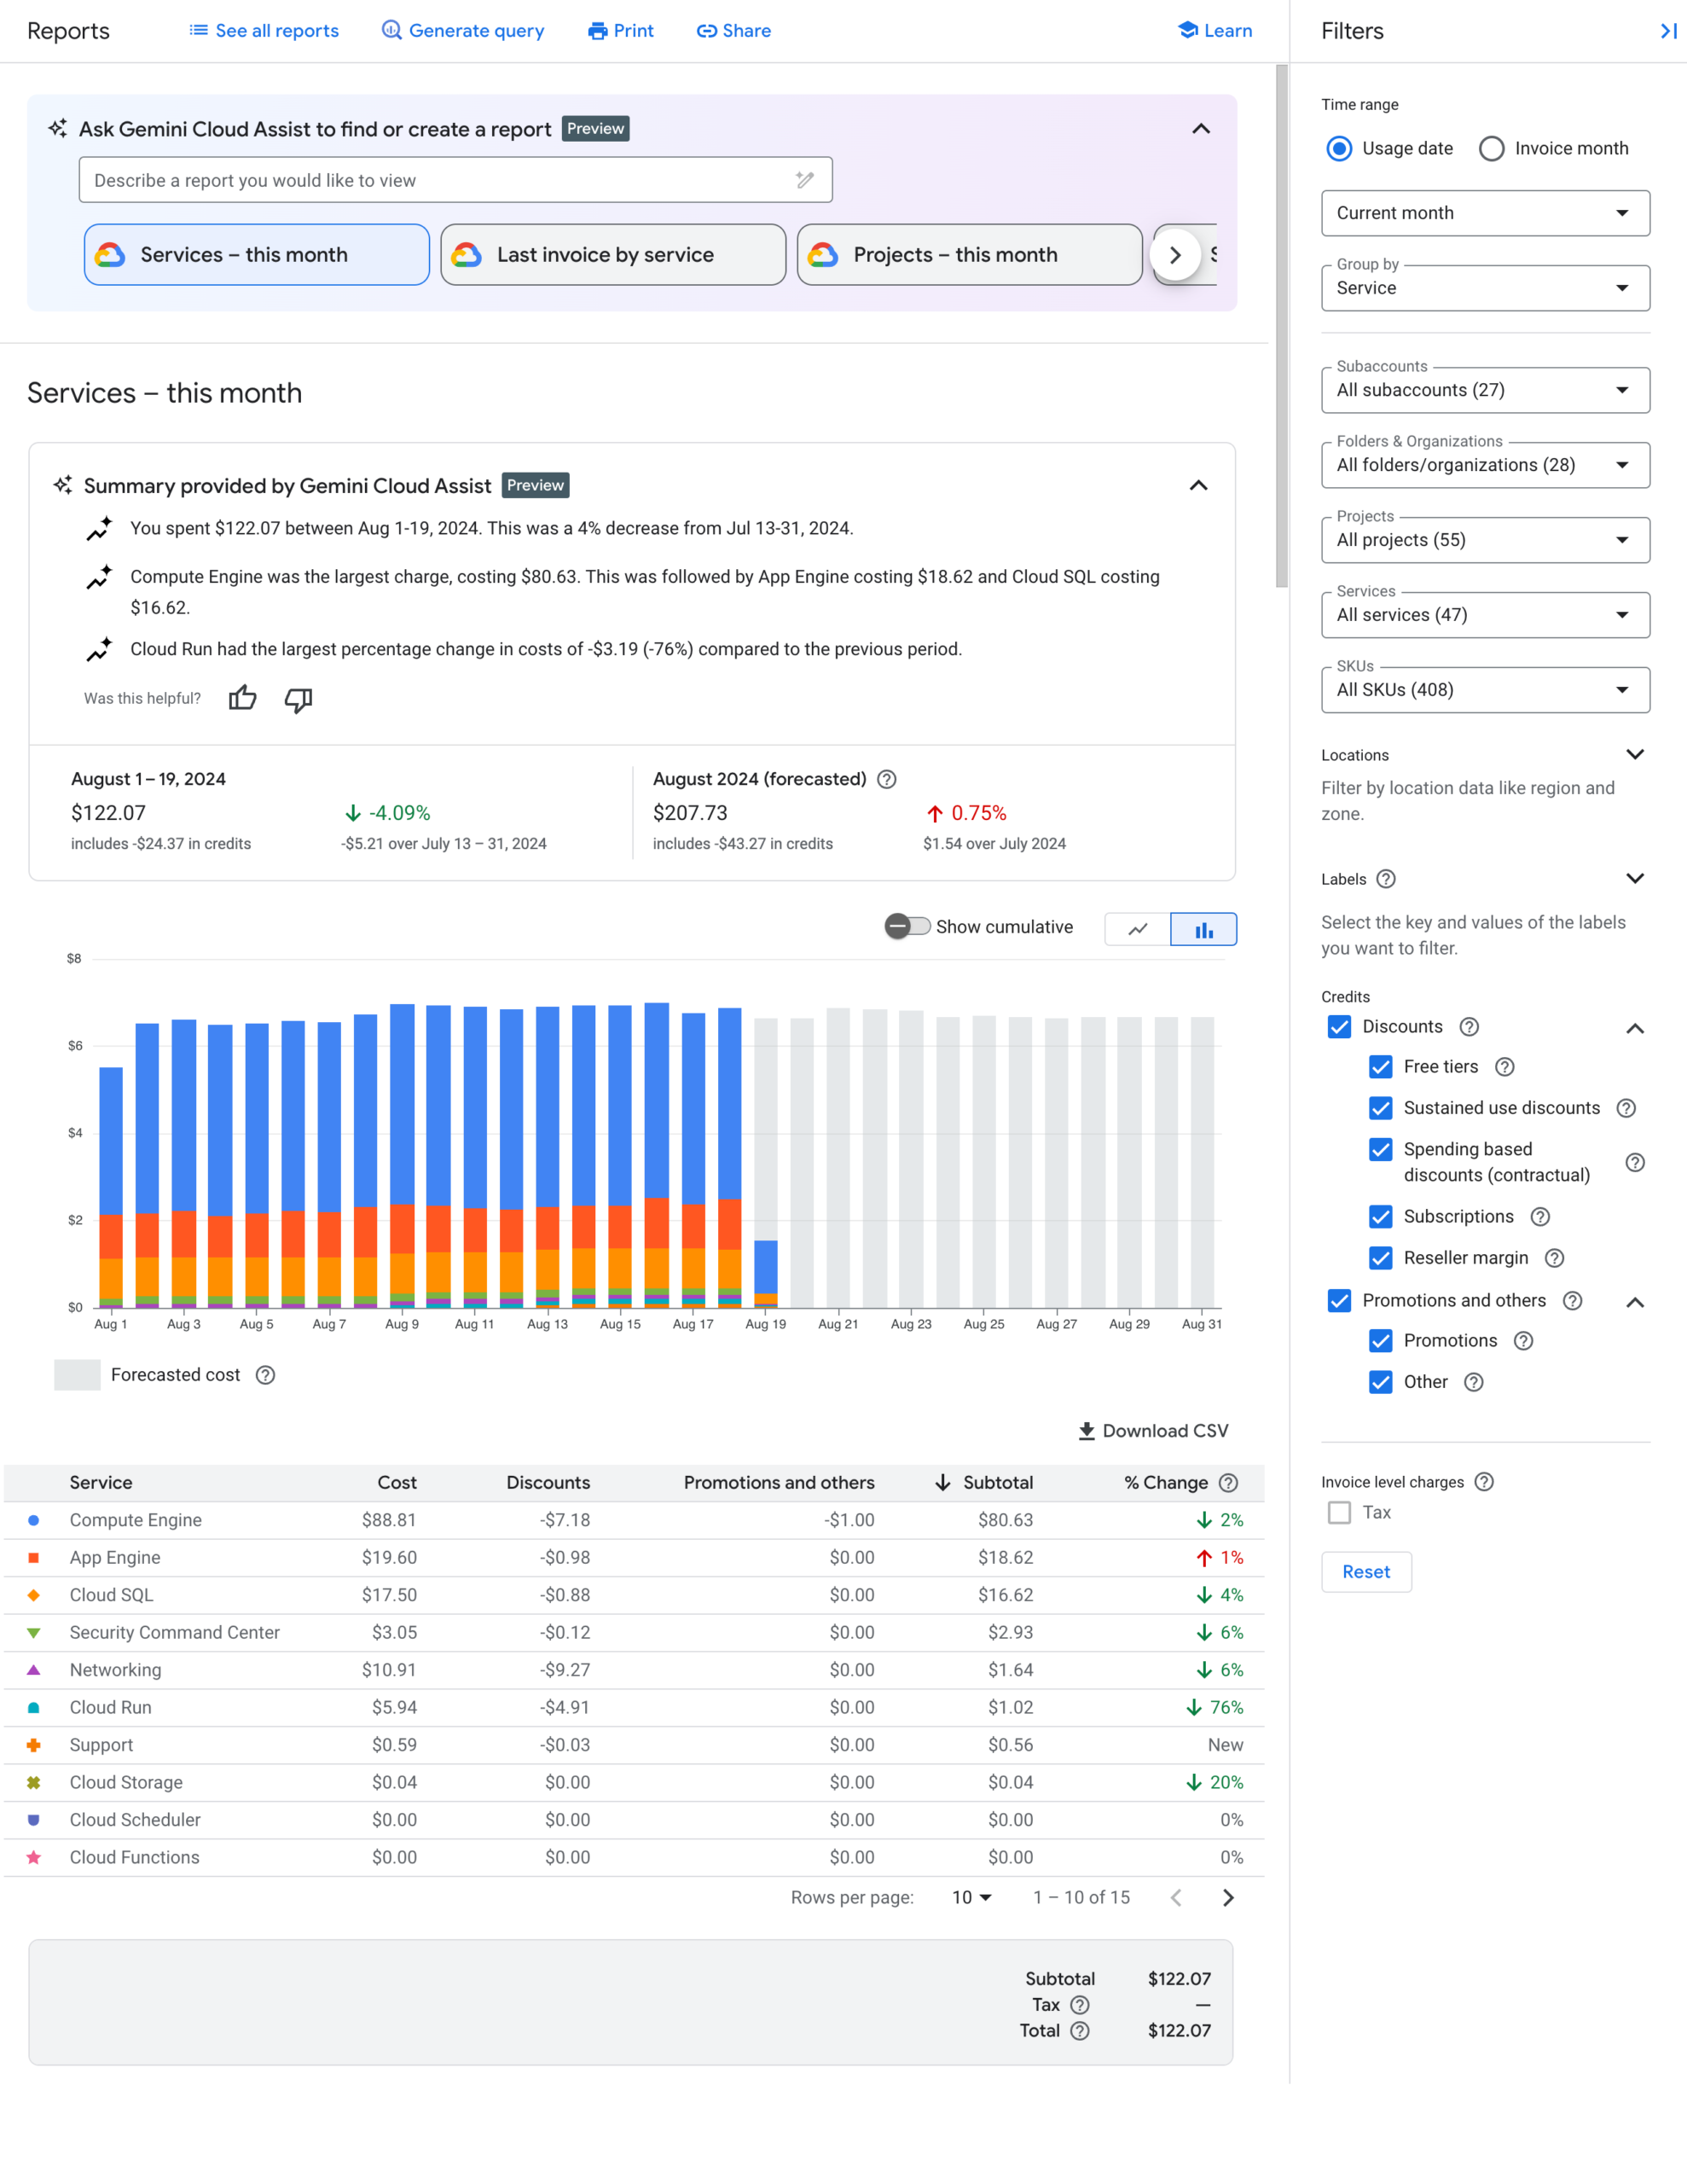
À la conception, je ne demande que les dimensions et métriques réellement utilisées. Je supprime les relances automatiques inutiles, notamment après une erreur permanente, et j’adapte la fréquence d’exécution au besoin métier. Une relance temporaire doit être contrôlée et espacée, pas déclenchée en boucle. Je suis les réponses de l’API, les erreurs et le volume de rapports traités. Je ne journalise ni jeton, ni clé, ni identifiant d’accès.
Ce modèle Python construit un rapport GA4, l’exécute avec les identifiants configurés dans l’environnement, puis journalise un résumé ou le type d’erreur. Il faut l’adapter aux dimensions, métriques et identifiants de propriété du projet. Ce n’est pas une garantie de compatibilité avec toute configuration GA4.
import logging
import os

from google.analytics.data_v1beta import (
    BetaAnalyticsDataClient,
    DateRange,
    Dimension,
    Metric,
    RunReportRequest,
)

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

property_id = os.environ["GA4_PROPERTY_ID"]

request = RunReportRequest(
    property=f"properties/{property_id}",
    date_ranges=[DateRange(start_date="7daysAgo", end_date="yesterday")],
    dimensions=[Dimension(name="date")],
    metrics=[Metric(name="sessions")],
)

try:
    # Le client utilise les identifiants configurés par Google Cloud.
    response = BetaAnalyticsDataClient().run_report(request)
    logger.info("Rapport exécuté : %d lignes", len(response.rows))
except Exception as exc:
    # Ne pas journaliser le message brut, qui peut contenir des données sensibles.
    logger.error("Échec du rapport GA4 : type=%s", type(exc).__name__)
Je teste les requêtes sur des périodes et des propriétés représentatives, puis je vérifie les erreurs, les coûts opérationnels et les volumes produits. La gestion des quotas ne se règle pas une fois pour toutes : elle s’intègre aux tests, au suivi en production et à la gouvernance des accès, des données et des fréquences d’exécution.
Comment tester et gouverner un rapport automatisé ?
Je teste les résultats et les chemins d’erreur contre une référence fiable, puis j’attribue clairement le suivi à des responsables identifiés. Un rapport automatisé n’est pas prêt en production parce qu’il s’exécute sans erreur : ses chiffres, ses règles de mesure et ses mécanismes de reprise doivent aussi être maîtrisés.
Avant la mise en production, je vérifie les points suivants :
- La cohérence des valeurs avec un rapport de référence validé, sur une même période et avec les mêmes filtres, dimensions, métriques et fuseau horaire.
- La stabilité des règles de mesure : définitions des événements, périmètre des données et transformations appliquées. Toute modification susceptible de changer les résultats doit être tracée et revue.
- Le comportement en cas d’échec : journalisation, alerte, reprise éventuelle et prévention des rapports incomplets ou dupliqués.
- Les changements de configuration, notamment les paramètres de requête, les accès, les versions utilisées et les destinataires du rapport.
Je couvre au minimum trois scénarios. Pour une réponse valide, je compare les valeurs et la structure obtenues à la référence. Pour une erreur de requête, je vérifie que l’échec est visible, attribuable et qu’il ne produit pas un rapport présenté comme complet. Pour une indisponibilité temporaire, je vérifie le comportement prévu par mon système, par exemple une reprise contrôlée ou une alerte, sans supposer la réponse exacte de l’API.
Les détails de réponse, les codes d’erreur, les limites et les recommandations de reprise doivent être vérifiés dans la documentation officielle de l’API Data GA4, à jour. Je désigne un responsable métier pour valider les chiffres, un responsable technique pour l’exécution et les incidents, et un propriétaire pour les accès et les quotas. Ces responsabilités doivent être explicites, pas implicites.
Synthèse : Le contrat du rapport fixe les champs et les règles attendus ; la compatibilité protège ses consommateurs ; les accès et les quotas encadrent son exécution. Les tests valident les résultats et les échecs, tandis que la documentation officielle confirme les comportements techniques à maintenir.
Votre processus de reporting est-il prêt à durer ?
Automatiser un rapport GA4 ne consiste pas à lancer une requête à intervalles réguliers. Il faut d’abord fixer un contrat de mesure, vérifier la compatibilité des champs et sécuriser les accès. Ensuite, on limite les données demandées, on maîtrise les appels répétés et on teste les résultats comme les erreurs à partir d’une référence fiable. Enfin, les responsabilités et les règles doivent rester documentées pour que les changements soient détectables et contrôlables. Cette discipline évite les rapports incohérents et les automatisations fragiles. Vous obtenez ainsi des rapports plus fiables, plus faciles à maintenir et réellement adaptés à vos décisions.
FAQ
À quoi sert l’API Data de GA4 ?
Elle permet de demander des données de reporting GA4 par requête, afin de les intégrer dans des rapports ou des processus automatisés.
Que faut-il définir avant de créer un rapport automatisé ?
Il faut préciser l’objectif, les utilisateurs, la fréquence, les périodes, les métriques, les dimensions, les filtres et les règles de mesure.
Pourquoi vérifier la compatibilité des dimensions et métriques ?
Parce qu’une combinaison de champs inadaptée peut empêcher la requête de fonctionner ou rendre les résultats difficiles à interpréter.
Comment éviter de dépasser les quotas de l’API ?
Limitez les champs et les données demandés, évitez les appels redondants et vérifiez les quotas applicables dans la documentation officielle à jour.
Quels tests prévoir avant la mise en production ?
Comparez les résultats à une référence fiable et testez les réponses valides ainsi que les principaux chemins d’erreur, en documentant les responsabilités de suivi.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la conception de flux de données et de reportings fiables, gouvernés et maintenables.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.