

L’optimisation de prompt améliore un prompt existant sans changer de modèle. Le vrai sujet, c’est de réduire l’ambiguïté, imposer une sortie exploitable et itérer proprement. Je vous montre les leviers qui changent vraiment la qualité des réponses LLM.
C’est quoi l’optimisation de prompt ?
L’optimisation de prompt consiste à améliorer un prompt déjà existant pour obtenir une sortie plus fiable, plus structurée et plus utile, sans changer le modèle LLM utilisé. Un LLM, c’est un grand modèle de langage, comme GPT, Claude ou Mistral. On ne touche pas au moteur. On améliore la façon de lui demander les choses.
Je fais une différence simple avec l’ingénierie de prompt. L’ingénierie de prompt conçoit la demande. Elle pose le cadre, le rôle, l’objectif, le format attendu. L’optimisation de prompt, elle, prend cette demande et la rend meilleure par précision, structure et itérations. On teste, on observe ce qui casse, puis on ajuste.
Prenons un cas très courant. Vous avez une transcription de réunion, un peu brouillonne, et vous voulez générer une liste d’actions. Le prompt générique ressemble souvent à ça : “Résume cette réunion et donne-moi les actions à faire”. Ça marche parfois. Puis le lendemain, le modèle mélange les décisions, invente une échéance, oublie un responsable, ou sort un paragraphe impossible à traiter dans Make, n8n ou votre CRM.
Formez-vous à l'IA Générative !
Exploiter l'IA générative et le prompt engineering est désormais indispensable pour automatiser vos tâches, accélérer votre création de contenu et booster votre productivité au quotidien... Passez à la vitesse supérieure avec nos formations IA Générative.
Le problème ne vient pas forcément du modèle. Souvent, la demande est trop vague. Qui fait quoi ? Pour quand ? Avec quel niveau de confiance ? Que doit faire le modèle si l’information manque ? Est-ce qu’il doit écrire “Non précisé” ou deviner ? C’est là que l’optimisation change tout.
- Je précise le format de sortie attendu.
- Je force la distinction entre fait confirmé et hypothèse.
- Je demande un niveau de confiance par action.
- Je prévois le cas où une date, un responsable ou une décision est absent.
Dans les projets IA et automatisation, je le vois tout le temps chez les clients. Les prompts qui partent en production ne peuvent pas juste être lisibles. Ils doivent être testables, répétables et exploitables par un workflow. Sinon, l’automatisation devient fragile, et quelqu’un finit par vérifier à la main.
| Approche | Objectif | Résultat attendu |
| Prompt générique | Obtenir une réponse lisible | Sortie variable et difficile à automatiser |
| Prompt optimisé | Obtenir une réponse contrôlée | Sortie plus stable, validable et réutilisable |
Pourquoi structurer la sortie ?
Structurer la sortie permet de transformer une réponse LLM en donnée exploitable, validable et automatisable. C’est vraiment le point clé. Une belle réponse en langage naturel, c’est agréable à lire. Mais dès qu’on veut l’envoyer dans un CRM, un outil de ticketing, une base de données, n8n, Make ou une API interne, ça devient vite fragile.
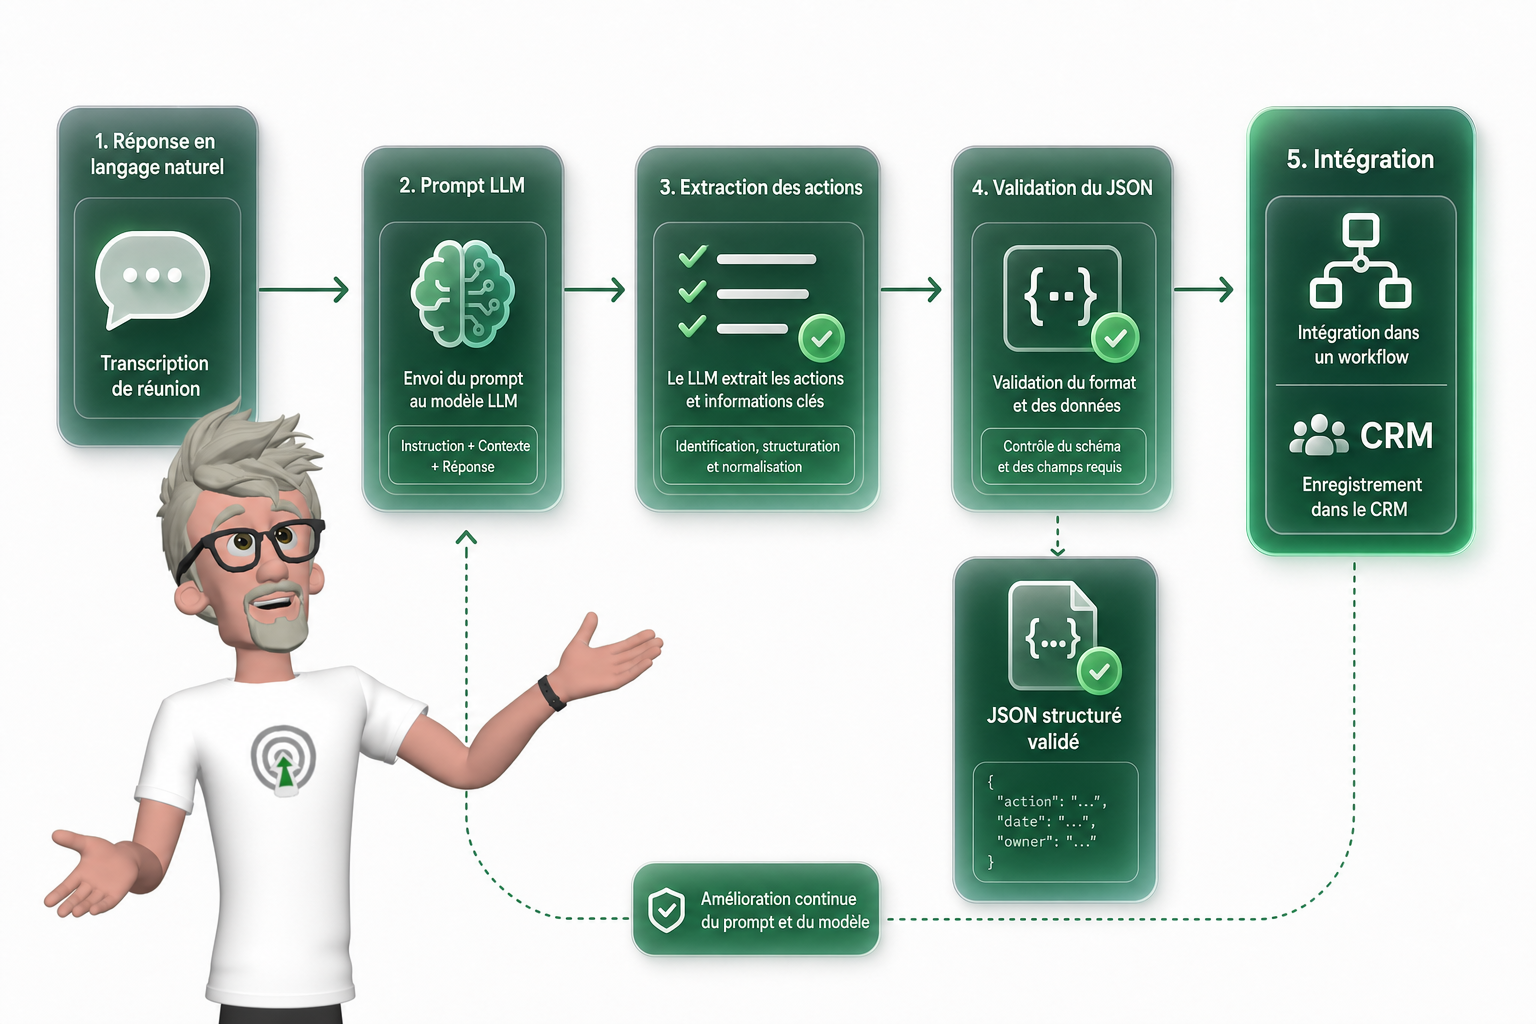
J’ai déjà vu des automatisations casser pour un détail idiot. Le modèle répondait “À faire rapidement” au lieu de “priorité: haute”. Humainement, on comprend. Une machine, elle, ne devine pas. Elle parse, elle valide, elle exécute. Si le format change, si un champ manque, si la date passe de “vendredi prochain” à “fin de semaine”, le workflow peut partir de travers.
La stratégie simple, c’est de demander explicitement un schéma de sortie. Pas juste “résume-moi la réunion”. Plutôt “retourne-moi un JSON avec ces champs précis”. JSON, c’est un format de données très utilisé par les API. Il est facile à lire pour une machine et facile à contrôler.
Pour une transcription de réunion, je demande souvent ces champs :
- Action : Ce qui doit être fait, uniquement si c’est explicite.
- Responsable : La personne chargée de l’action.
- Échéance : La date ou le délai annoncé.
- Priorité : Basse, moyenne, haute, si elle est mentionnée ou clairement déduite.
- Source : La phrase ou l’extrait qui justifie l’action.
- Niveau_de_confiance : Un score simple, par exemple entre 0 et 1.
- Information_manquante : Ce qui manque pour exécuter correctement l’action.
Le point important, c’est de dire quoi faire quand l’information n’existe pas. Je préfère un champ à null ou “inconnu” plutôt qu’une invention proprement présentée. Le modèle doit savoir qu’il a le droit de ne pas savoir.
Tu analyses une transcription de réunion.

Objectif :
Extraire uniquement les actions explicites mentionnées dans la transcription.

Règles :
Retourne uniquement un JSON valide.
N’ajoute aucun texte avant ou après le JSON.
N’invente jamais une action, un responsable ou une échéance.
Si une information n’est pas disponible, mets null.
Si une clarification est nécessaire, renseigne le champ "information_manquante".

Format attendu :
{
  "actions": [
    {
      "action": "Description courte de l’action explicite",
      "responsable": "Nom de la personne ou null",
      "echeance": "Date ou délai ou null",
      "priorite": "basse, moyenne, haute ou null",
      "source": "Phrase exacte qui justifie l’action",
      "niveau_de_confiance": 0.0,
      "information_manquante": "Information manquante ou null"
    }
  ]
}

Transcription :
{{TRANSCRIPTION_REUNION}}| Langage libre | Sortie structurée |
| Agréable à lire, mais difficile à parser. | Facile à lire par une machine et à intégrer. |
| Format variable selon les réponses. | Format stable, champs attendus, règles claires. |
| Risque de champs manquants ou ambigus. | Valeurs null, inconnu ou clarification quand l’information manque. |
| Automatisations fragiles. | Workflows plus fiables dans CRM, n8n, Make ou API. |
Quel rôle donner au modèle ?
Il faut donner au modèle un rôle précis quand ce rôle améliore le jugement, le tri et la forme de la réponse. Si le rôle ne change pas sa manière de décider, il ne sert presque à rien.
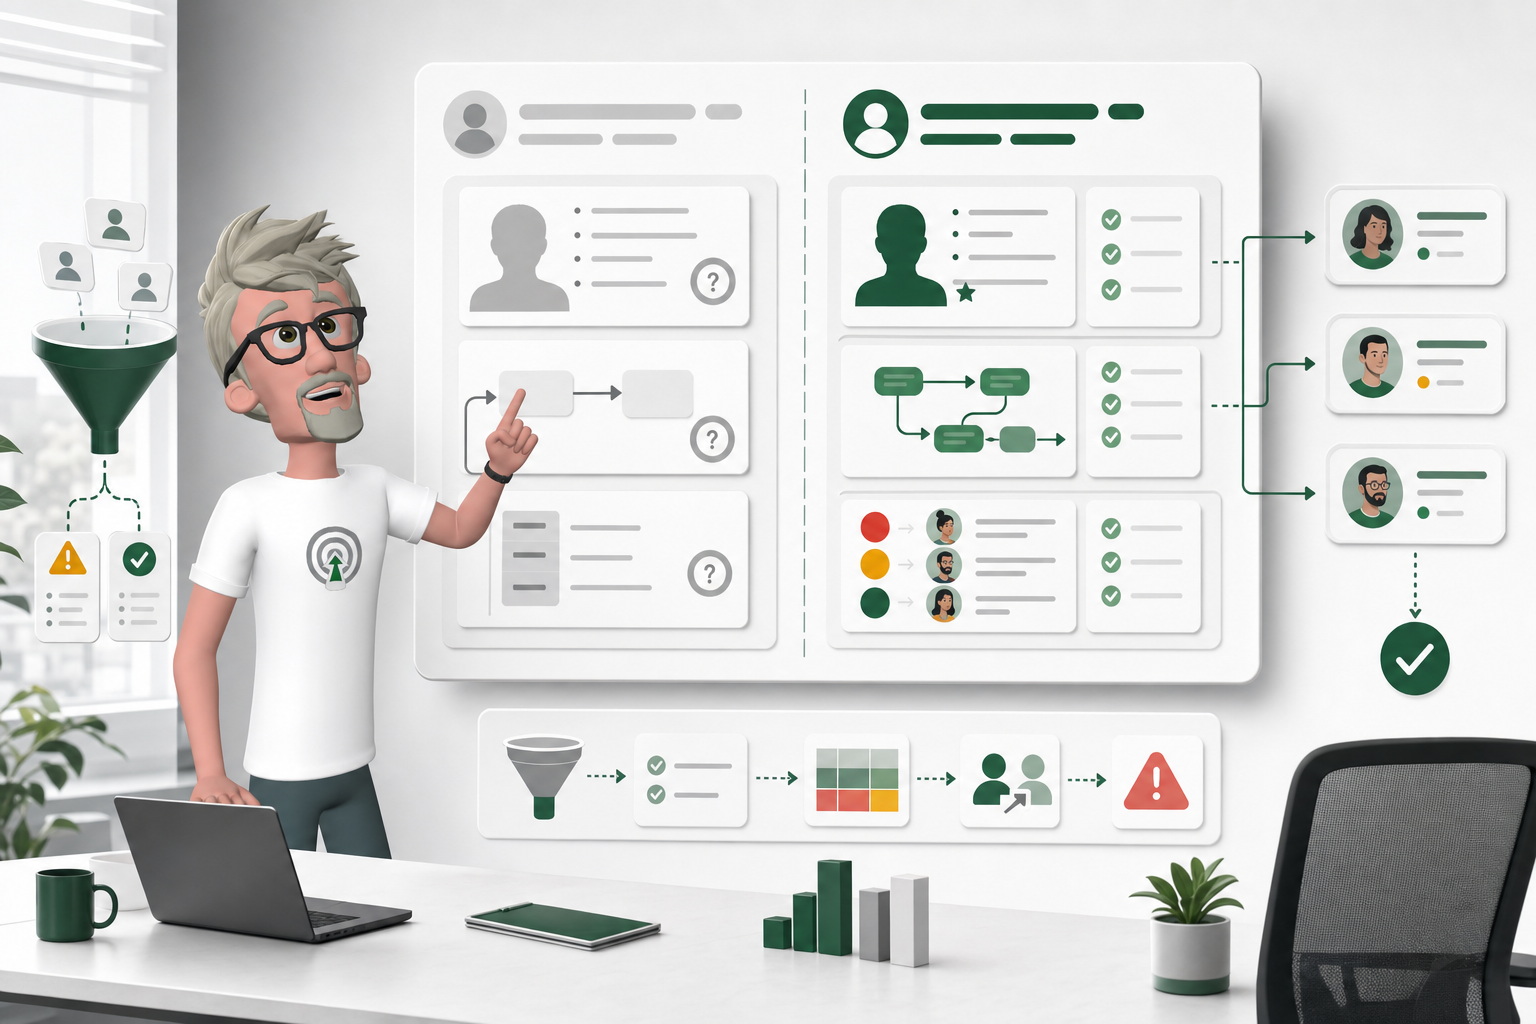
Un rôle vague du type “Tu es un assistant IA” apporte peu. C’est propre, mais ça ne guide pas vraiment le modèle. Un rôle utile décrit une compétence et un comportement attendu. Par exemple, “assistant exécutif méticuleux” peut être utile, mais seulement si je précise ce que ça veut dire dans le travail demandé.
Un bon assistant exécutif ne se contente pas de résumer une réunion. Il repère les décisions prises, les responsabilités, les délais, les points flous et les engagements implicites à vérifier. Il fait attention à ce qui est confirmé, à ce qui est supposé, et à ce qui manque. C’est là que le rôle devient opérationnel.
J’ai souvent vu des équipes ajouter des personas comme du vernis. Ça sonne mieux, ça donne l’impression d’un prompt plus travaillé, mais la sortie ne change pas vraiment. Ce qui change la sortie, c’est quand le rôle impose des critères de décision. Par exemple : privilégier les actions confirmées, signaler les ambiguïtés, ne pas inventer d’échéance, classer les actions par urgence.
Voici un mauvais prompt, avec un rôle trop large :
Tu es un assistant IA.
Résume cette réunion et donne les actions à faire.
Le modèle peut produire quelque chose de correct, mais il va deviner beaucoup de choses. Il n’a pas de règle claire pour trier, prioriser ou signaler les zones incertaines.
Voici une version plus utile, parce que le rôle influence vraiment le traitement :
Tu es un assistant exécutif méticuleux, spécialisé dans le suivi de réunions opérationnelles.

À partir de la transcription, identifie uniquement :
- Les décisions confirmées
- Les actions à réaliser
- Le responsable de chaque action, si mentionné
- L’échéance, uniquement si elle est explicitement donnée
- Les points flous à clarifier

Comportement attendu :
- Ne déduis pas une échéance absente
- Signale les responsabilités ambiguës
- Classe les actions par urgence quand l’urgence est explicite
- Sépare les faits confirmés des suppositions
Quand je définis un rôle, je vérifie toujours ces cinq éléments :
- Métier : Quelle expertise le modèle doit-il simuler ?
- Objectif : Quel résultat concret doit-il produire ?
- Critères : Comment doit-il arbitrer, trier ou prioriser ?
- Limites : Qu’est-ce qu’il ne doit pas inventer ou supposer ?
- Format de sortie : Comment la réponse doit-elle être structurée pour être exploitable ?
Comment réduire l’ambiguïté ?
On réduit l’ambiguïté en ajoutant du contexte utile, des règles de décision et des contraintes explicites.
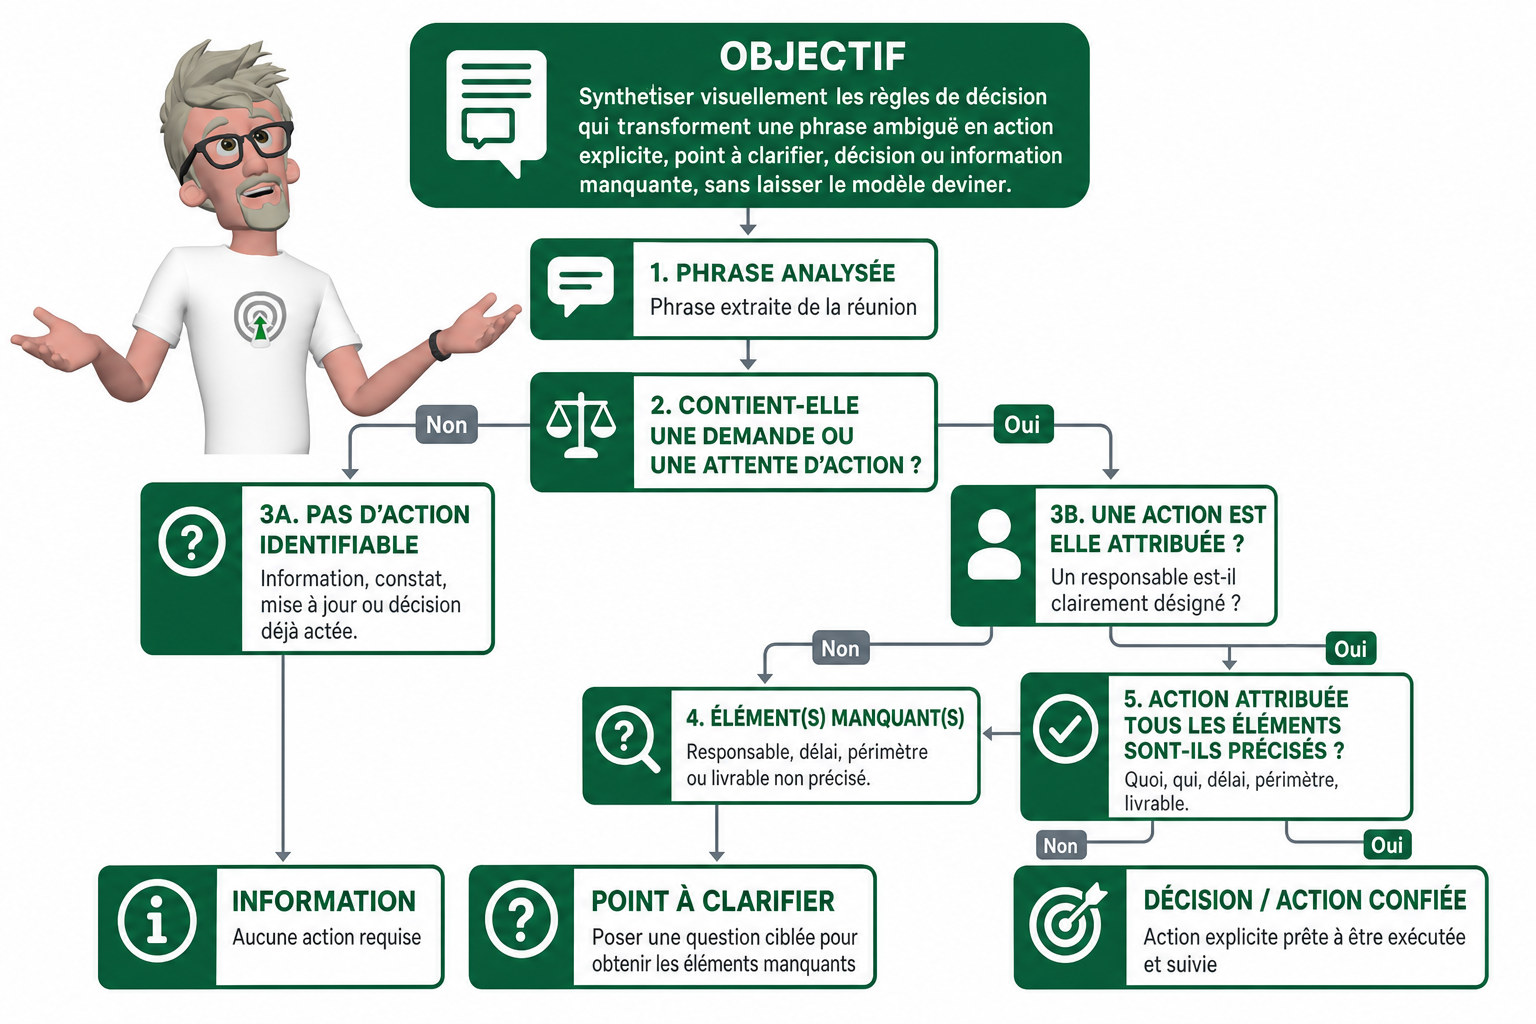
Dans l’exemple de transcription de réunion, le problème est simple : tout se ressemble. Quelqu’un dit “Il faudrait revoir le tunnel d’inscription”, un autre répond “Oui, l’équipe produit peut regarder”, puis quelqu’un ajoute “On vise fin du mois si possible”. Pour un humain, c’est déjà un peu flou. Pour un LLM, ça peut devenir une action, une décision, une intention ou juste une idée discutée.
C’est là que le prompt doit arrêter de demander “résume les actions” et commencer à cadrer ce qu’on accepte comme action. Une vraie action, pour moi, c’est une tâche attribuée à une personne ou une équipe. S’il n’y a pas de responsable clair, je préfère que le modèle dise “point à clarifier” plutôt qu’il invente. J’ai vu ça chez un client sur des comptes rendus commerciaux : le modèle assignait des relances à la mauvaise personne juste parce qu’elle parlait le plus dans la réunion. Ça a l’air malin, mais opérationnellement c’est dangereux.
Dans un prompt optimisé, j’ajoute généralement ces éléments :
- Le contexte business : Pourquoi on extrait ces informations, pour quel usage derrière.
- L’objectif final : Créer une liste d’actions exploitable, pas un résumé joli.
- La définition d’une action : Une tâche concrète avec un responsable explicite.
- Les exclusions : Ne pas transformer une idée, une hypothèse ou une discussion en tâche.
- Le niveau de prudence attendu : Mieux vaut signaler une incertitude que deviner.
- Le traitement des infos manquantes : Responsable absent, échéance vague, décision implicite.
Voici un bloc de règles que j’intègre souvent dans le prompt, surtout quand la sortie doit alimenter un outil comme Notion, Airtable ou un CRM :
Règle 1 : Extraire seulement les actions attribuées explicitement à une personne ou à une équipe.
Règle 2 : Si la phrase contient une intention sans responsable, classer en point à clarifier.
Règle 3 : Distinguer une décision d’une tâche. Une décision décrit un choix acté, une tâche décrit un travail à faire.
Règle 4 : Si l’échéance est vague, conserver le texte original sans l’interpréter.
Règle 5 : Si plusieurs responsables sont possibles, ne pas trancher sans preuve.
Règle 6 : Ne jamais déduire un responsable si personne n’est nommé.
Règle 7 : Signaler les informations manquantes dans un champ dédié.
Le but n’est pas de rendre le modèle plus créatif. C’est même l’inverse. On veut le rendre fiable dans un cas d’usage précis, avec moins de place pour l’interprétation et moins de décisions prises à notre place.
Pourquoi itérer et tester le prompt ?
Il faut itérer parce qu’un prompt ne devient fiable qu’après confrontation à plusieurs exemples réels, pas après un seul test qui marche. J’ai vu ça souvent chez des clients : le prompt paraît parfait sur une transcription propre, puis il casse dès qu’une réunion est plus floue, plus longue, ou que deux personnes parlent de la même tâche.
L’optimisation de prompt, c’est un cycle simple : tester, observer les erreurs, corriger le prompt, retester. Le but n’est pas d’ajouter des kilomètres d’instructions à chaque version. Le but, c’est d’être plus précis là où le modèle se trompe. Si le modèle invente une action, je renforce la règle sur les informations explicitement présentes. S’il sort un JSON invalide, je verrouille le format. S’il confond une discussion avec une décision, je définis clairement ce qu’est une décision.
Sur un cas de transcription de réunion, je vérifie surtout ces erreurs-là :
- Action inventée alors qu’elle n’a jamais été décidée.
- Responsable mal attribué, souvent parce qu’une personne a juste commenté le sujet.
- Échéance déduite au lieu d’être clairement mentionnée.
- Format JSON invalide, avec une virgule en trop ou une clé manquante.
- Oubli d’une action importante noyée dans la discussion.
- Confusion entre une idée discutée et une décision actée.
La méthode la plus simple, c’est de créer un petit jeu de transcriptions avec les sorties attendues. Pas besoin de 200 exemples au début. Cinq à dix cas bien choisis suffisent déjà à voir les faiblesses. Je compare les résultats, je note les erreurs, puis je modifie une seule partie du prompt à la fois. Sinon, on ne sait plus ce qui a amélioré ou dégradé le résultat.
| Test | Erreur observée | Correction du prompt | Résultat |
| Transcription réunion projet | Échéance inventée | Ajouter : “Ne jamais déduire une date si elle n’est pas explicitement donnée.” | Meilleure fiabilité sur les dates |
| Réunion commerciale | Responsable mal attribué | Préciser que le responsable doit être nommé comme propriétaire de l’action | Moins d’attributions abusives |
| Compte rendu long | JSON invalide | Imposer uniquement une sortie JSON, sans texte autour | Sortie exploitable par l’automatisation |
Et là, il y a un point important. Si la sortie alimente un workflow, par exemple dans Make, Zapier ou n8n, je valide le format avant de déclencher l’étape suivante. Un JSON cassé peut bloquer tout le scénario. Une action inventée peut créer une tâche inutile. Un bon prompt optimisé, ce n’est pas une phrase jetée dans une interface de chat. C’est un actif de production.
Alors, votre prompt est-il prêt pour la production ?
L’optimisation de prompt, ce n’est pas de la magie ni une collection de formules. C’est un travail de précision. Je pars d’un prompt existant, je clarifie l’objectif, je structure la sortie, je donne un rôle utile au modèle, je réduis les ambiguïtés et je teste sur plusieurs cas réels. Pour une transcription de réunion, ça change tout : on passe d’un résumé sympa à une vraie liste d’actions exploitable. Et si derrière vous branchez ça dans un workflow, un CRM ou une base de données, le bénéfice est clair : moins d’erreurs, moins de reprises manuelles, plus de fiabilité.
FAQ
- Quelle est la différence entre optimisation de prompt et ingénierie de prompt ?
L’ingénierie de prompt sert à concevoir une bonne demande. L’optimisation de prompt sert à améliorer une demande existante. Je garde le même modèle, mais je rends le prompt plus précis, plus structuré et plus fiable grâce aux tests et aux itérations. - Pourquoi demander une sortie JSON à un LLM ?
Parce qu’une sortie JSON peut être validée, parsée et réutilisée dans une automatisation. Une réponse en texte libre peut être lisible, mais elle est beaucoup plus fragile si vous devez l’envoyer dans un CRM, une base de données ou un scénario n8n. - Est-ce qu’une persona améliore vraiment les réponses ?
Une persona améliore les réponses seulement si elle guide le comportement du modèle. Dire sois un expert ne suffit pas. Dire agis comme un assistant exécutif méticuleux, extrais uniquement les actions confirmées et signale les ambiguïtés donne une vraie direction au modèle. - Comment éviter que le modèle invente des actions ?
Il faut poser des règles explicites. Par exemple : extraire seulement les actions présentes dans la transcription, ne pas deviner le responsable, mettre une valeur neutre si l’échéance manque, et signaler les points à clarifier. Le modèle doit savoir quoi faire quand l’information n’existe pas. - Combien de tests faut-il pour optimiser un prompt ?
Il n’y a pas de nombre magique. Un seul test ne suffit presque jamais. Je préfère tester sur plusieurs exemples réels, noter les erreurs, modifier une seule partie du prompt, puis retester. C’est comme ça qu’on transforme un prompt correct en prompt fiable pour un usage business.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Avec webAnalyste et Formations Analytics, j’accompagne des équipes qui veulent rendre leurs données, leurs automatisations et leurs usages IA vraiment opérationnels. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez fiabiliser vos prompts, vos workflows IA ou vos automatisations business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.