

Je suivrais ces cours GitHub IA Microsoft dans cet ordre : data science, machine learning, IA, IA générative, agents IA. C’est le chemin le plus propre pour comprendre les bases, coder des modèles, puis construire des systèmes IA utiles sans brûler les étapes.
Par quoi commencer en data science ?
Je commencerais par Data Science for Beginners, parce qu’il donne la vue d’ensemble qu’on oublie trop souvent quand on fonce directement sur les modèles.
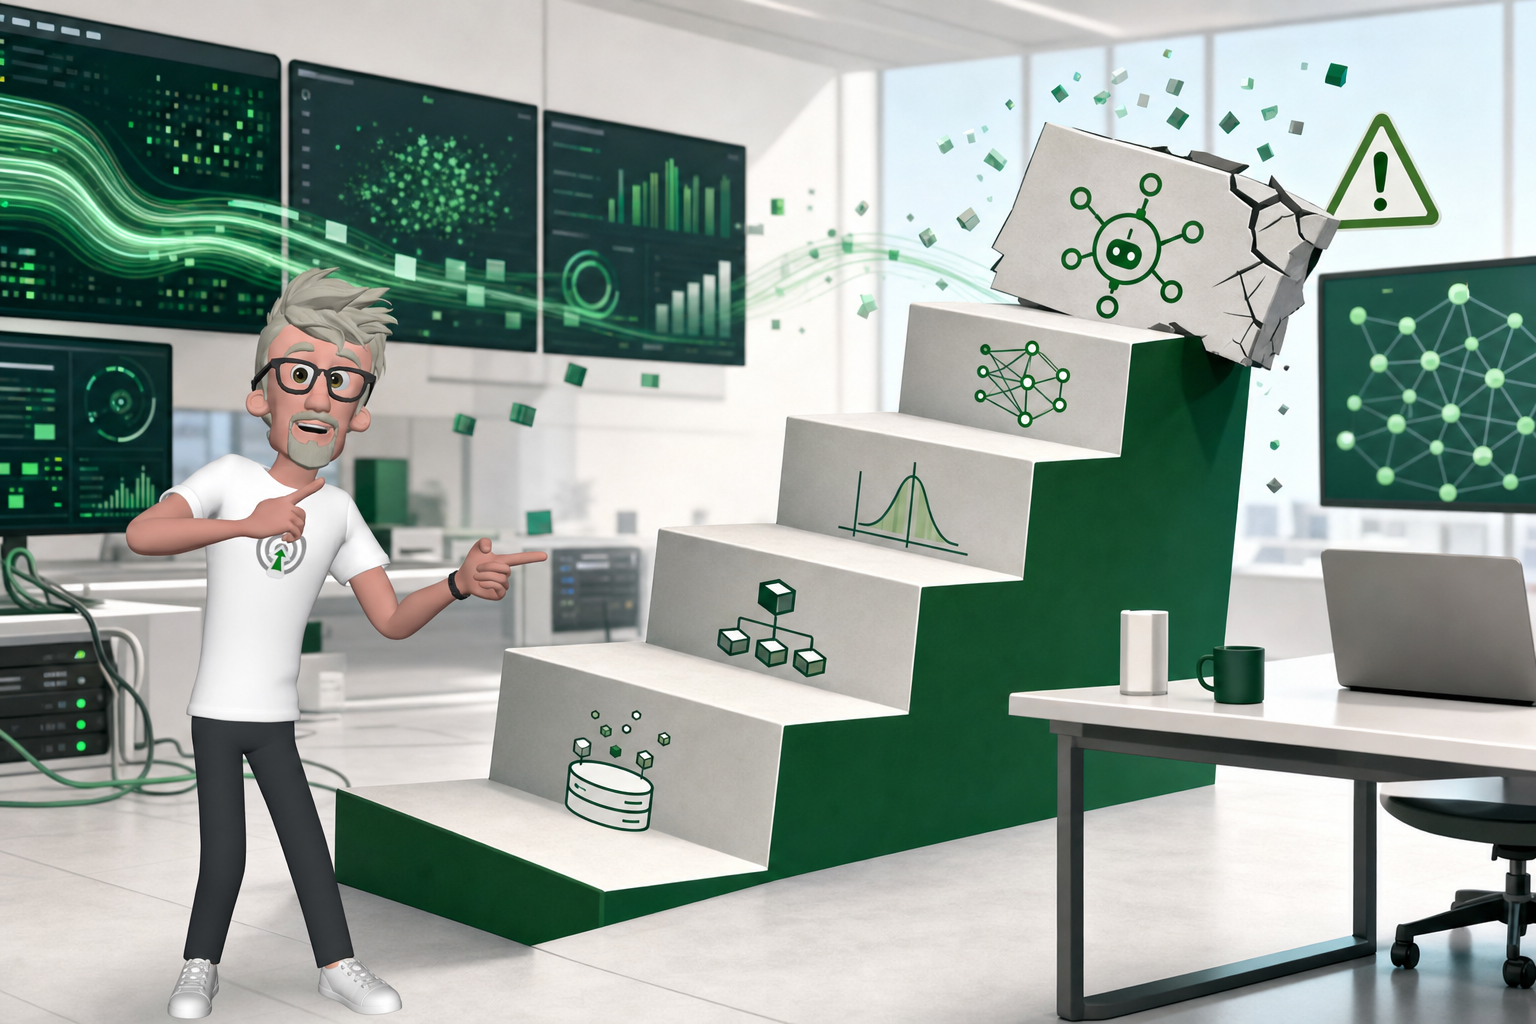
Ce cursus gratuit Microsoft sur GitHub dure environ 10 semaines, avec 20 leçons. Il couvre les bases qui font vraiment la différence : l’éthique des données, les statistiques, les probabilités, les bases de données relationnelles et non relationnelles, la préparation des données, la visualisation et l’analyse.
Ce que j’aime bien, c’est qu’on n’apprend pas juste un outil isolé. On apprend le flux de travail complet de la data science. On part d’un problème, on regarde les données, on les comprend, on les nettoie, on les explore, puis seulement après on commence à tirer des conclusions.
Développez vos compétences avec nos formations expertes en Analytics, Data, IA et automatisation No Code !
Les données sont partout, mais encore faut-il savoir les exploiter. Nos formations vous donnent les clés pour maîtriser Google Analytics, Google Tag Manager, Looker Studio, BigQuery, Prompt Engineering, ChatGPT, Make ou n8n pour créer des agents IA et bien d’autres outils essentiels.
Chez des clients, je vois souvent la même scène. Les équipes veulent faire de l’IA, parfois très vite, avec des modèles, des agents, de l’automatisation. Mais la donnée n’est pas propre, pas comprise, pas documentée. Et là, tout devient fragile. Ce cours règle une partie du problème, parce qu’il oblige à repartir du terrain : comprendre les données, les nettoyer, les visualiser, poser les bonnes questions.
Il s’adresse aux débutants, aux profils métier, aux analystes, et aux développeurs qui veulent comprendre le cycle data avant de passer au machine learning. Il y a des quiz, des exercices pratiques, et des jeux de données réels. C’est parfait pour apprendre sans rester dans la théorie.
import pandas as pd
import matplotlib.pyplot as plt

# Charger un fichier CSV dans un DataFrame
# Un DataFrame, c'est simplement un tableau de données manipulable avec Python
df = pd.read_csv("donnees.csv")

# Afficher les premières lignes pour comprendre la forme du jeu de données
print(df.head())

# Inspecter les colonnes disponibles
print(df.columns)

# Vérifier le type des données et les valeurs non nulles
print(df.info())

# Détecter les valeurs manquantes par colonne
print(df.isnull().sum())

# Créer une visualisation simple sur une colonne numérique
# Remplacez "age" par une colonne numérique de votre fichier
df["age"].hist(bins=20)

# Ajouter un titre lisible au graphique
plt.title("Distribution des âges")

# Afficher le graphique
plt.show()| Objectif | Comprendre le cycle complet de la data science, de la donnée brute à l’analyse. |
| Durée | Environ 10 semaines, avec 20 leçons. |
| Niveau | Débutant, accessible aux profils métier, analystes et développeurs. |
| Compétences | Éthique, statistiques, probabilités, bases de données, nettoyage, visualisation, analyse. |
| Pourquoi le suivre avant le reste | Parce qu’il évite de construire de l’IA sur des données mal comprises. Et ça, c’est souvent là que les projets dérapent. |
Quand passer au machine learning ?
Je passerais au machine learning une fois que je sais lire, nettoyer et expliquer un jeu de données. La data science prépare le terrain : comprendre les colonnes, repérer les valeurs bizarres, formuler une hypothèse. Le machine learning arrive juste après, quand on veut entraîner un modèle, le tester proprement, puis décider s’il mérite d’aller plus loin.
Machine Learning for Beginners est un bon cursus intermédiaire gratuit de Microsoft sur GitHub. Il dure environ 12 semaines, avec 26 leçons. On y voit la régression, la classification, le clustering, le NLP, c’est-à-dire le traitement automatique du langage, la prévision de séries temporelles et l’apprentissage par renforcement.
Python et Scikit-learn sont au centre des exercices. Scikit-learn, c’est la bibliothèque classique pour entraîner des modèles de machine learning sans réinventer toute la plomberie. Le cours insiste sur l’entraînement, l’évaluation, le choix des caractéristiques, qu’on appelle aussi variables, et les métriques de performance.
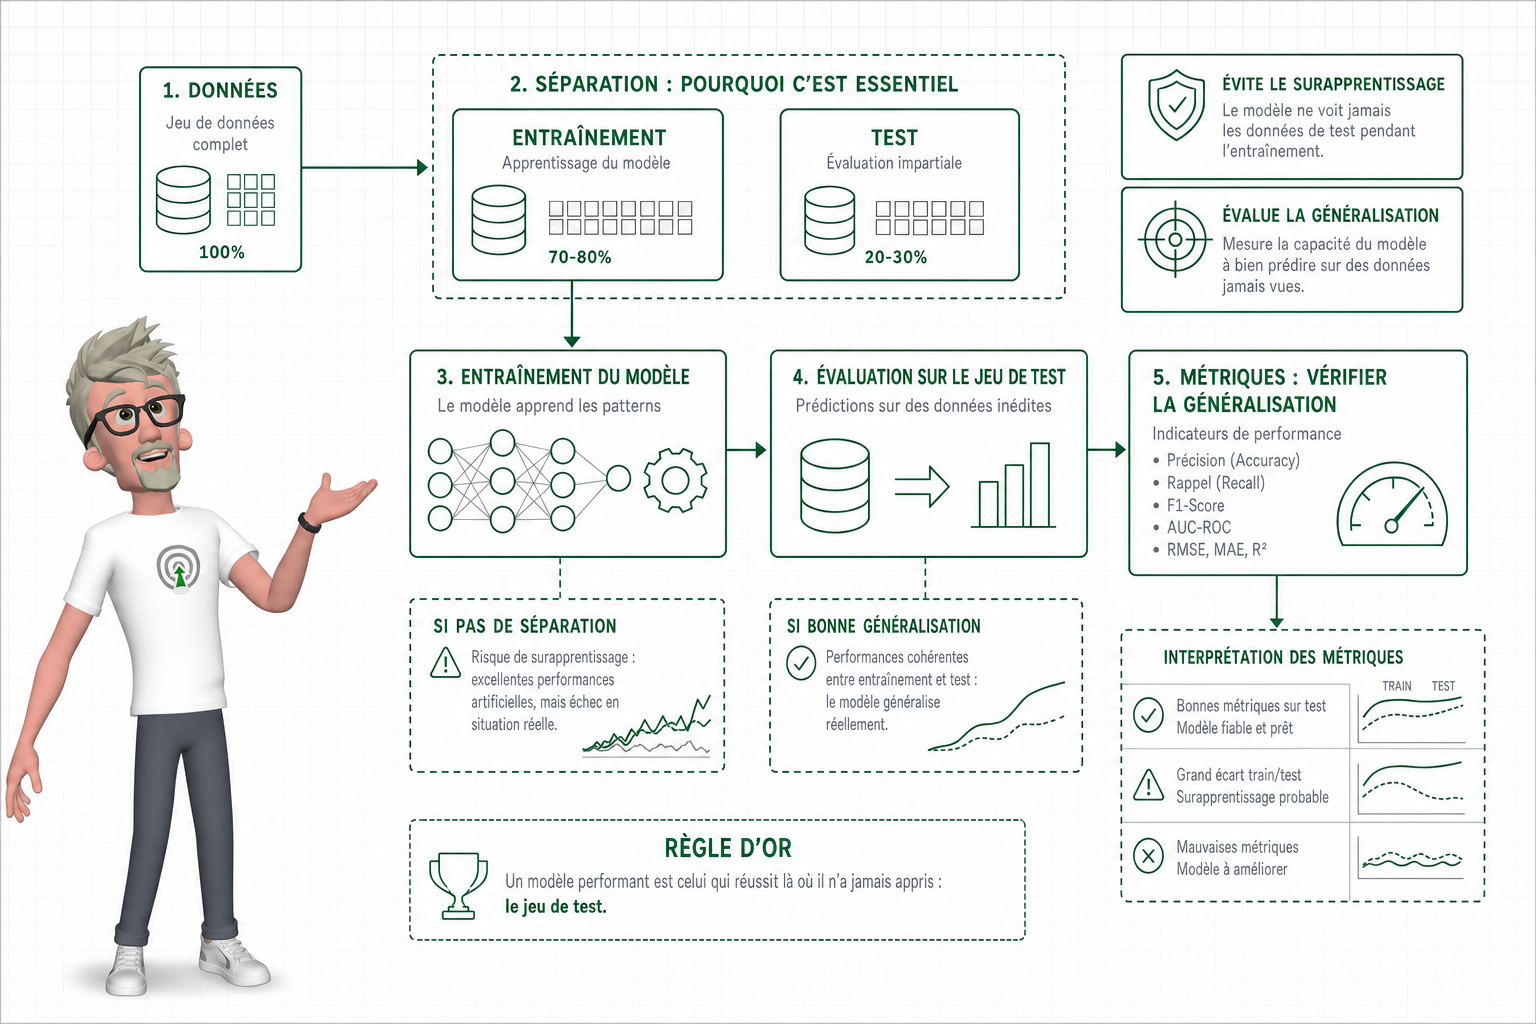
Les méthodes classiques restent indispensables, même avec les LLMs. Si je ne comprends pas une séparation train/test, une métrique, le surapprentissage ou l’importance des variables, je traite vite l’IA comme une boîte magique. Et en production, ça finit souvent mal. J’ai déjà vu des équipes avoir un modèle “génial” en démo, puis catastrophique sur de vraies données client, juste parce qu’il avait été testé sur les mêmes données que celles utilisées pour l’entraîner.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report

# Charger un dataset de classification
data = load_breast_cancer()
X = data.data
y = data.target

# Séparer les données d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# Entraîner un modèle simple
model = LogisticRegression(max_iter=5000)
model.fit(X_train, y_train)

# Prédire sur des données jamais vues par le modèle
y_pred = model.predict(X_test)

# Afficher les métriques principales
print("Accuracy :", accuracy_score(y_test, y_pred))
print("Matrice de confusion :")
print(confusion_matrix(y_test, y_pred))
print("Rapport de classification :")
print(classification_report(y_test, y_pred))
L’accuracy indique la part de bonnes prédictions. La matrice de confusion montre où le modèle se trompe. Le rapport de classification ajoute la précision et le rappel, utiles quand une erreur coûte plus cher qu’une autre.
Les erreurs fréquentes sont simples, mais très coûteuses :
- Tester sur les données d’entraînement.
- Choisir la mauvaise métrique.
- Oublier la qualité des variables.
- Confondre corrélation et causalité.
| Approche | Cas d’usage business |
| Régression | Prévoir un chiffre d’affaires ou un prix. |
| Classification | Détecter un client à risque de churn. |
| Clustering | Segmenter une base clients. |
| NLP | Classer des tickets support ou analyser des avis. |
| Séries temporelles | Prévoir la demande ou les stocks. |
| Renforcement | Optimiser une recommandation ou une stratégie de pricing. |
Comment comprendre les modèles d’IA ?
Pour comprendre ce qui se passe sous le capot, je passerais ensuite à Artificial Intelligence for Beginners. C’est le cours gratuit Microsoft sur GitHub que je recommande quand vous avez déjà touché un peu au machine learning classique et que vous voulez comprendre la suite logique. On ne remplace pas les bases, on les prolonge avec les réseaux de neurones, la vision, le langage et le deep learning.
Le parcours dure environ 12 semaines, avec 24 leçons. Il couvre les réseaux de neurones, la vision par ordinateur, le NLP, c’est-à-dire le traitement automatique du langage, le deep learning et même des techniques symboliques, plus proches des systèmes à règles.
On y croise les briques importantes :
- PyTorch et TensorFlow, deux bibliothèques pour entraîner des modèles.
- CNN, les réseaux adaptés aux images.
- RNN, les réseaux pensés pour les séquences.
- Embeddings, des représentations numériques du sens.
- Transformers, la famille de modèles derrière une grosse partie de l’IA moderne.
- Transfert d’apprentissage, autoencodeurs et GANs.

Ce cours aide surtout à comprendre pourquoi un modèle apprend. Une couche transforme l’information, puis une autre la transforme encore, jusqu’à produire une prédiction. Les embeddings sont centraux en NLP parce qu’ils permettent de comparer des mots, des phrases ou des documents par proximité de sens. Les transformers ont changé le traitement du langage parce qu’ils regardent les relations entre les mots à grande échelle. Le transfert d’apprentissage évite de repartir de zéro : on part d’un modèle déjà entraîné, puis on l’adapte à son cas.
Je vois beaucoup de gens utiliser des outils IA sans jamais se demander ce qu’est un embedding ou pourquoi un modèle hallucine. Pas besoin de devenir chercheur, vraiment. Mais comprendre les mécanismes évite de croire n’importe quoi.
import torch
import torch.nn as nn
import torch.optim as optim

# Je crée des données factices : 2 variables en entrée, 1 résultat à prédire
X = torch.tensor([[0., 0.], [0., 1.], [1., 0.], [1., 1.]])
y = torch.tensor([[0.], [1.], [1.], [0.]])

# Je définis un petit réseau de neurones
model = nn.Sequential(
    nn.Linear(2, 4),   # Couche qui transforme 2 valeurs en 4 signaux
    nn.ReLU(),        # Activation non linéaire
    nn.Linear(4, 1),  # Couche de sortie
    nn.Sigmoid()      # Sortie entre 0 et 1
)

# Je définis la perte et l’optimiseur
loss_fn = nn.BCELoss()
optimizer = optim.Adam(model.parameters(), lr=0.05)

# Je lance une boucle d’entraînement simple
for epoch in range(100):
    prediction = model(X)
    loss = loss_fn(prediction, y)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    if epoch % 20 == 0:
print(f"Epoch {epoch} - Perte : {loss.item():.4f}")| Concept | Application |
| CNN | Images, détection d’objets, classification visuelle |
| RNN | Séquences, séries temporelles, texte ancien format |
| Transformers | Langage, assistants IA, résumé, traduction |
| Embeddings | Recherche sémantique, recommandation, similarité |
| GANs | Génération d’images ou de données synthétiques |
| Autoencodeurs | Compression, nettoyage, détection d’anomalies |
Comment apprendre l’IA générative ?
J’aborderais l’IA générative après les bases du machine learning et du deep learning, sinon on finit vite par copier des prompts sans comprendre ce qu’on construit. Les modèles modernes reposent sur des concepts déjà vus, réseaux de neurones, embeddings, entraînement, inférence, mais les usages changent complètement.
Generative AI for Beginners est un cursus gratuit Microsoft sur GitHub, avec environ 21 leçons, centré sur les applications modernes de l’IA générative. On y trouve du prompt engineering, de la sélection de modèles, de l’IA responsable, du function calling, du RAG, des bases de données vectorielles, des agents IA, du fine-tuning, de la sécurité, des petits modèles et des modèles open-source. Les exemples pratiques existent en Python et en TypeScript, ce qui est pratique si vous venez plutôt du backend ou du monde web.
Les notions sont assez simples quand on enlève le jargon. Le prompt engineering sert à mieux cadrer la réponse du modèle. Le RAG, pour Retrieval Augmented Generation, sert à connecter un modèle à vos documents ou à vos données métiers. Le function calling permet au modèle d’appeler des outils, par exemple une API interne. Le fine-tuning adapte un modèle à un besoin plus spécifique. Les bases vectorielles servent à retrouver du contenu par similarité sémantique, pas juste par mots-clés.
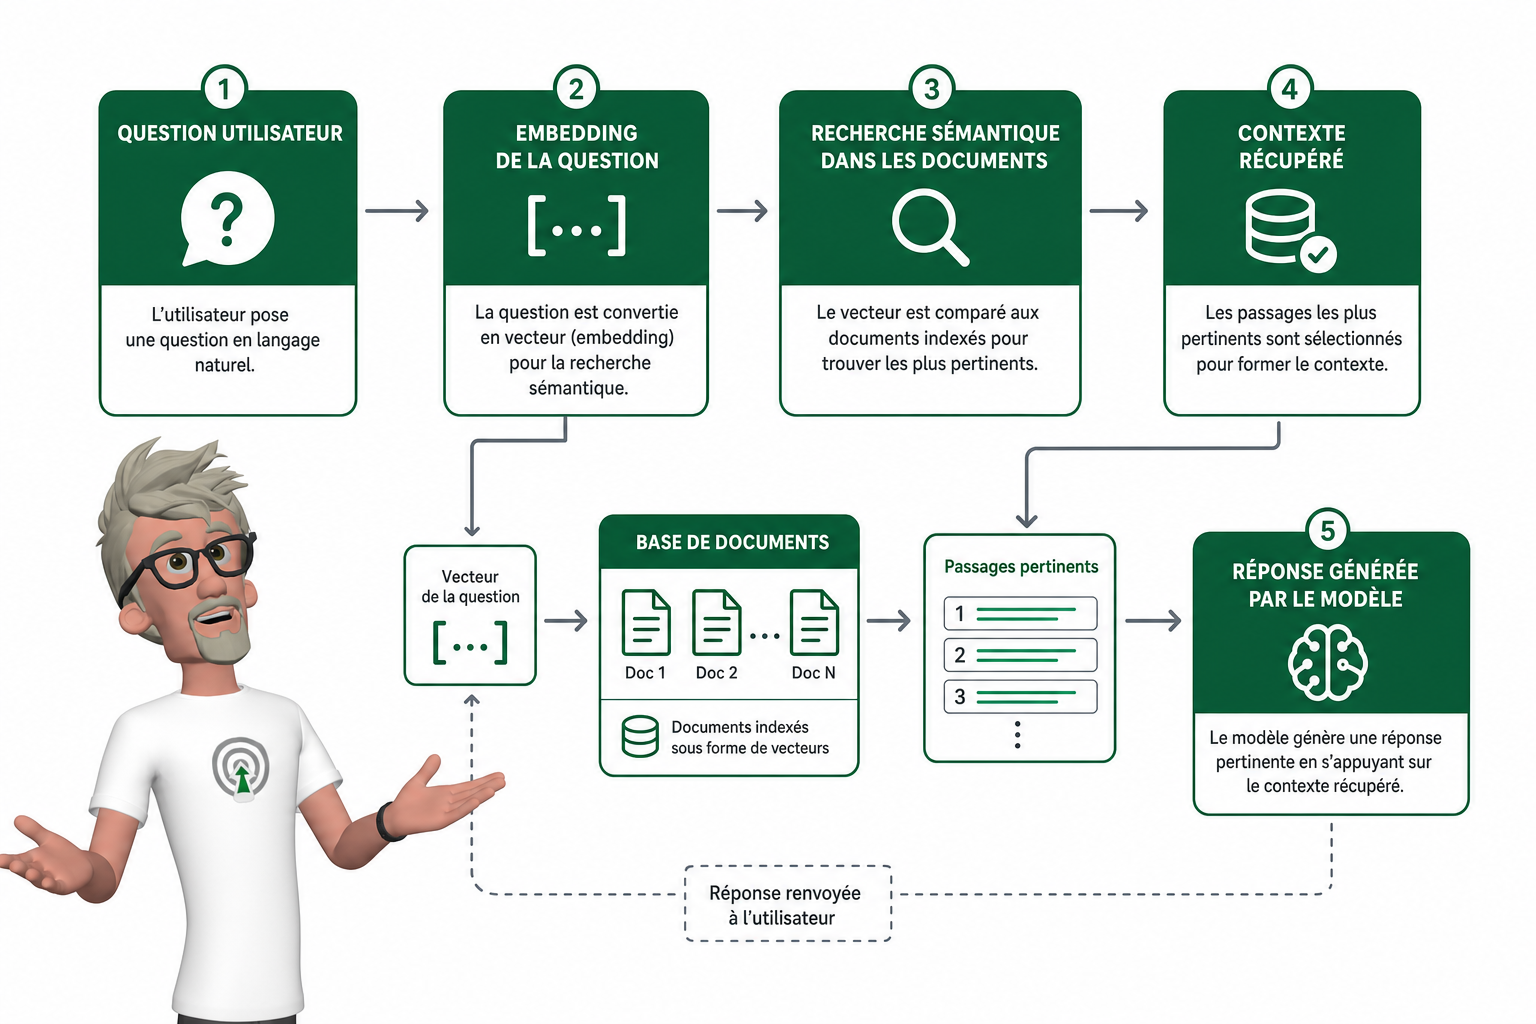
Voici une version très simplifiée d’un RAG en Python. Dans un vrai projet, je remplacerais l’embedding jouet par un modèle d’embeddings et la recherche par une base vectorielle.
# Exemple pédagogique : structure simple d'un RAG

documents = [
    "La garantie standard dure 2 ans.",
    "Les retours sont possibles sous 30 jours.",
    "La livraison express prend 24 à 48 heures."
]

def embed(text):
    # Embedding simplifié : on transforme le texte en ensemble de mots
    return set(text.lower().replace(".", "").split())

def score(query_vec, doc_vec):
    # Similarité simple : mots communs / mots uniques
    return len(query_vec & doc_vec) / len(query_vec | doc_vec)

question = "Combien de temps dure la garantie ?"
query_vec = embed(question)

index = [(doc, embed(doc)) for doc in documents]
best_doc = max(index, key=lambda item: score(query_vec, item[1]))[0]

prompt = f"Réponds uniquement avec ce contexte : {best_doc}nQuestion : {question}"

# Ici, on enverrait le prompt au modèle
answer = "La garantie standard dure 2 ans."
print(answer)
Et voici le principe du function calling en TypeScript. Le modèle choisit une fonction, votre code l’exécute, puis le modèle peut formuler la réponse finale.
// Exemple pédagogique : appel d'une fonction métier

type OrderStatus = {
  orderId: string;
  status: string;
};

function getOrderStatus(orderId: string): OrderStatus {
  // Dans un vrai cas, on appellerait une API ou une base de données
  return { orderId, status: "Expédiée" };
}

const toolCall = {
  name: "getOrderStatus",
  arguments: { orderId: "CMD-123" }
};

if (toolCall.name === "getOrderStatus") {
  const result = getOrderStatus(toolCall.arguments.orderId);
  console.log(`La commande ${result.orderId} est ${result.status}.`);
}
Petite note pratique. Certains exercices peuvent demander un accès à des API d’IA ou à Microsoft Foundry. Une partie peut aussi être testée localement avec Foundry Local quand le modèle et la machine s’y prêtent. C’est factuel, mais mieux vaut le savoir avant de lancer le cours.
| Besoin | Option | Coût | Confidentialité | Complexité |
| Mieux cadrer les réponses | Prompt | Faible | Moyenne | Faible |
| Répondre avec vos documents | RAG | Moyen | Bonne si bien maîtrisé | Moyenne |
| Adapter le style ou un cas précis | Fine-tuning | Plus élevé | Variable | Élevée |
| Déclencher une action métier | Function calling | Moyen | Bonne côté système | Moyenne |
| Tester sans envoyer les données dehors | Modèle local | Faible à moyen | Très bonne | Moyenne à élevée |
Pourquoi finir par les agents IA ?
Je finirais par les agents IA parce que c’est le niveau où le modèle ne se contente plus de répondre. Il planifie, utilise des outils, garde du contexte, corrige sa trajectoire. Sans une vraie compréhension des LLMs, les grands modèles de langage, du RAG, qui consiste à aller chercher des infos dans vos documents, et du function calling, l’appel contrôlé de fonctions, les agents deviennent vite une usine à bugs.
AI Agents for Beginners est pour moi le cursus avancé gratuit Microsoft à suivre sur GitHub. Il tourne autour d’environ 18 leçons, avec les vrais sujets du terrain : utilisation d’outils, RAG agentique, planification, mémoire, ingénierie du contexte, systèmes multi-agents, agents capables d’utiliser un ordinateur, sécurité et déploiement en production. On y voit aussi des exemples avec Microsoft Agent Framework et Microsoft Foundry Agent Service, ce qui aide à passer du concept au système exploitable.
Un agent IA, c’est simple à comprendre. Il reçoit un objectif, raisonne sur les étapes, appelle des outils, lit ou écrit dans une mémoire, puis ajuste son action. Un chatbot répond. Un agent agit dans un cadre donné. Et c’est là que ça devient sérieux.
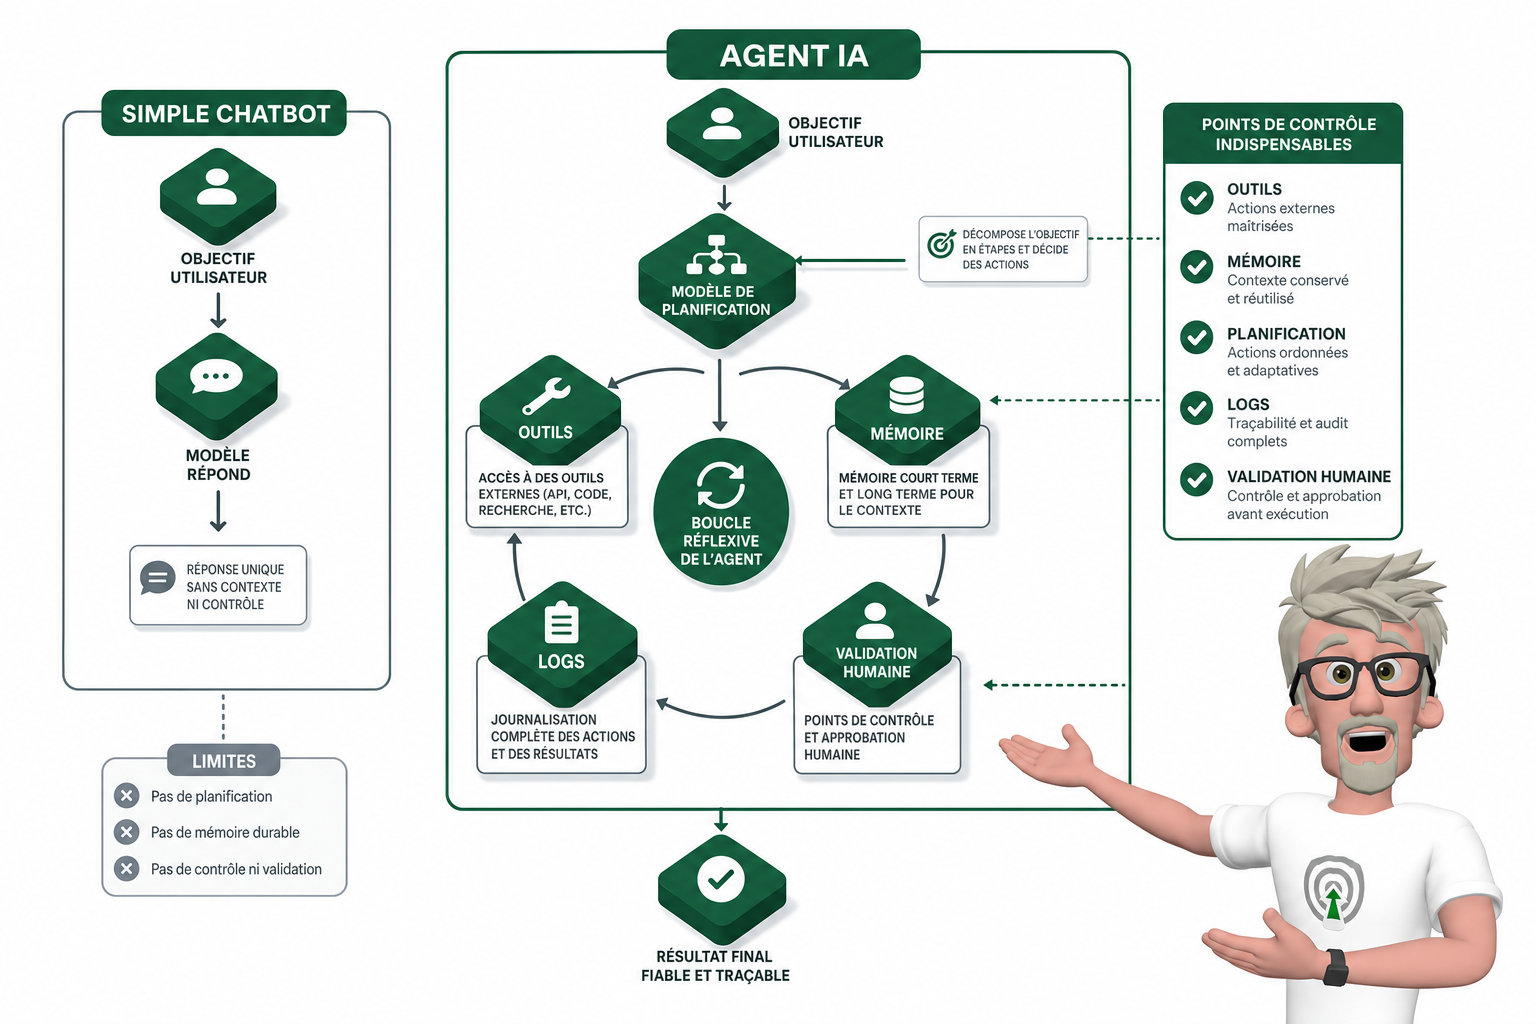
Dans les projets d’automatisation que je vois, le vrai sujet n’est presque jamais “brancher un LLM à un outil”. Ça, c’est la démo. Le dur, c’est les permissions, les erreurs, les logs, les limites, la sécurité, et le moment où l’humain doit reprendre la main.
# Boucle agent très simple

objectif = "Préparer un résumé des ventes du mois"
memoire = []

def choisir_action(objectif, memoire):
    # Le modèle décide quoi faire ensuite selon l'objectif et le contexte
    return "lire_ventes"

def appeler_outil(action):
    # Ici, l'agent utilise un outil externe
    if action == "lire_ventes":
        return "Ventes: 120k€, panier moyen: 48€, hausse: 12%"
    return "Action inconnue"

action = choisir_action(objectif, memoire)
resultat = appeler_outil(action)

memoire.append({
    "objectif": objectif,
    "action": action,
    "resultat": resultat
})

reponse_finale = f"Résumé prêt: {resultat}"
print(reponse_finale)
# Garde-fou simple avant une action sensible
action = "envoyer_email_client"
validation_humaine = False
actions_sensibles = ["envoyer_email_client", "supprimer_fichier", "payer_facture"]
if action in actions_sensibles and not validation_humaine:
raise Exception("Validation humaine requise avant exécution")
print("Action autorisée")| Composant agentique | Rôle | Risque | Garde-fou recommandé |
| Outils | Agir sur des systèmes externes | Action incorrecte | Permissions strictes et validation |
| Mémoire | Conserver le contexte | Donnée obsolète ou sensible | Expiration et chiffrement |
| Planification | Découper l’objectif | Mauvais enchaînement | Étapes vérifiables |
| RAG | Retrouver la bonne information | Source non fiable | Traçabilité des documents |
| Multi-agent | Répartir les tâches | Conflits entre agents | Rôles clairs et arbitre |
| Déploiement production | Exécuter à grande échelle | Coûts, erreurs, dérives | Logs, quotas, supervision humaine |
Alors je commence par quel cours ?
Je commencerais simple : data science, puis machine learning, puis IA, puis IA générative, puis agents. Cet ordre évite le piège classique : vouloir construire un agent avant de comprendre les données, les modèles, les métriques et le RAG. Ces cours GitHub IA gratuits de Microsoft ont un vrai intérêt parce qu’ils couvrent le chemin complet, avec des leçons, des quiz, des exercices et des projets. Vous pouvez avancer à votre rythme, tester du Python, du TypeScript, Scikit-learn, PyTorch, TensorFlow, Foundry et les briques modernes des agents. Le bénéfice est clair : vous apprenez à construire, pas juste à consommer de l’IA.
FAQ
- Quels sont les cours GitHub IA gratuits de Microsoft à suivre ?
Je suivrais ces cinq parcours dans l’ordre : Data Science for Beginners, Machine Learning for Beginners, Artificial Intelligence for Beginners, Generative AI for Beginners, puis AI Agents for Beginners. Ça donne une progression logique, des bases data jusqu’aux systèmes agentiques. - Faut-il savoir coder avant de commencer ?
Pas forcément pour le premier cours, mais il faut accepter de pratiquer. Les parcours utilisent surtout Python, puis aussi TypeScript pour certains exemples d’IA générative. Si vous débutez, commencez par les notebooks simples, les exercices et les quiz. - Pourquoi ne pas commencer directement par l’IA générative ?
Vous pouvez, mais je ne le conseille pas si vous voulez construire sérieusement. Sans bases en données, métriques, machine learning et embeddings, on finit vite par empiler des prompts sans comprendre les limites du système. - Les exercices demandent-ils des outils payants ?
Une partie des exercices peut se faire gratuitement, surtout sur les parcours de data science, machine learning et IA classique. Pour l’IA générative et les agents, certains exemples peuvent demander des API d’IA ou Microsoft Foundry. Certains modèles peuvent aussi être testés localement avec Foundry Local selon les cas. - Quel cours choisir si mon objectif est business ?
Si votre objectif est de créer de la valeur rapidement, je partirais sur Data Science for Beginners puis Generative AI for Beginners. Mais pour fiabiliser vos cas d’usage business, ajoutez Machine Learning for Beginners. Vous comprendrez mieux les données, les métriques, les erreurs et les limites des modèles.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent passer de la donnée dispersée à des systèmes vraiment exploitables, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez structurer vos usages data, IA ou automatisation sans bullshit, contactez-moi, je peux vous aider.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.