

Je suivrais une progression simple : comprendre les réseaux, construire un mini GPT, apprendre la production LLM, creuser la théorie, puis pratiquer le fine-tuning avec Hugging Face. Le piège, c’est de sauter trop vite aux outils sans comprendre ce qu’ils cachent.
Par quoi commencer les LLM ?
Je commencerais par Neural Networks: Zero to Hero d’Andrej Karpathy, parce que ce cours force à reconstruire les briques internes au lieu de seulement appeler une API.
C’est gratuit, public, et surtout très concret. Karpathy met les vidéos et le code à disposition, donc je peux coder en même temps que lui, casser des trucs, relancer, comprendre pourquoi ça marche. C’est très différent d’un cours qu’on regarde en x1.5 en se disant qu’on a “compris”.
Le cours part des fondations des réseaux de neurones, puis il monte progressivement vers des sujets qui touchent directement aux LLM. Il y a micrograd, qui aide à comprendre l’autograd, c’est-à-dire le calcul automatique des gradients. Les gradients, en gros, disent au modèle comment ajuster ses paramètres pendant l’entraînement. Ensuite, il y a makemore, qui modélise du langage caractère par caractère. Puis un GPT simplifié, pour comprendre la génération autoregressive, donc le fait de prédire le prochain token encore et encore. Et enfin un tokenizer BPE, une méthode de découpage du texte en morceaux appelés tokens.
Pour quelqu’un de pressé, l’intérêt est simple. Vous ne devenez pas chercheur en deux jours. Mais vous arrêtez de traiter les LLM comme une boîte noire magique. Et franchement, ça change tout quand vous devez choisir un modèle, lire une facture API, comprendre une réponse bizarre ou expliquer pourquoi un prompt ne donne pas le résultat attendu.
Développez vos compétences avec nos formations expertes en Analytics, Data, IA et automatisation No Code !
Les données sont partout, mais encore faut-il savoir les exploiter. Nos formations vous donnent les clés pour maîtriser Google Analytics, Google Tag Manager, Looker Studio, BigQuery, Prompt Engineering, ChatGPT, Make ou n8n pour créer des agents IA et bien d’autres outils essentiels.
J’ai vu des équipes business vouloir fine-tuner avant même de comprendre la tokenisation. Ça finit souvent en coûts inutiles, ou en mauvais diagnostic. Le problème ne venait pas du modèle, mais du découpage du texte, du contexte trop long, d’un prompt instable, ou d’une mauvaise attente sur ce que le modèle peut générer.
Comprendre les embeddings, c’est comprendre comment du texte devient des vecteurs numériques. Comprendre la tokenisation, c’est mieux anticiper les coûts et les limites de contexte. Comprendre la génération autoregressive, c’est mieux saisir pourquoi un modèle peut partir dans une direction cohérente mais fausse.
| Brique apprise | Pourquoi c’est utile en LLM |
| Gradients | Comprendre comment un modèle apprend et pourquoi l’entraînement coûte cher. |
| Embeddings | Voir comment le texte devient manipulable par un modèle. |
| Tokenisation BPE | Mieux prévoir les coûts, les limites de contexte et certains bugs de prompts. |
| Génération autoregressive | Comprendre pourquoi un LLM génère mot après mot, avec parfois des dérives. |
Comment passer du modèle à la production ?
Je passerais ensuite au LLM Bootcamp de Full Stack Deep Learning, parce qu’il parle de ce qui casse vraiment quand on met une application LLM devant des utilisateurs.
Une démo LLM, c’est souvent assez simple. On branche une API, on écrit un bon prompt, on ajoute une interface propre, et tout le monde trouve ça bluffant en réunion. Mais la production, c’est autre chose. Là, il faut gérer les volumes, les erreurs bizarres, les temps de réponse, les coûts qui montent sans prévenir, les utilisateurs qui posent des questions imprévues, et les métiers qui veulent comprendre pourquoi le système a répondu n’importe quoi mardi à 14h12.
Ce bootcamp gratuit est intéressant parce qu’il est orienté architecture de production. Il parle du choix du modèle, du design d’application, de l’orchestration, de l’évaluation, de la latence, des coûts, de la fiabilité, de l’observabilité et du déploiement. Bref, tout ce qu’on évite souvent au début, mais qui devient central dès qu’on sort du POC. Un POC, c’est une preuve de concept. Ça sert à montrer que l’idée peut marcher. Ça ne prouve pas que le système tiendra dans la vraie vie.

La partie LLMOps est clé ici. LLMOps, c’est simplement la manière d’exploiter un produit basé sur des LLM proprement. On garde des logs, donc des traces de ce qui entre et sort. On versionne les prompts, comme on versionne du code. On construit des jeux d’évaluation, c’est-à-dire des exemples de questions avec les réponses attendues ou les critères de qualité. On suit les réponses, on fait des tests de non-régression pour vérifier qu’une amélioration ne casse pas autre chose, et on mesure le coût par requête.
L’évaluation est vraiment le cœur du sujet. Un LLM ne se teste pas comme une fonction classique qui renvoie toujours le même résultat. La réponse peut varier, être partiellement bonne, ou correcte sur le fond mais dangereuse dans la forme. C’est pour ça qu’il faut mesurer la qualité avec méthode, pas juste relire trois réponses à la main en se disant que ça a l’air bon.
Sur des projets IA en entreprise, je l’ai vu plusieurs fois. Le vrai sujet arrive rarement au moment du POC. Il arrive quand il faut expliquer pourquoi une réponse est mauvaise, combien elle coûte, et comment éviter qu’elle revienne. C’est là qu’on voit si on a construit une démo sympa ou un vrai système.
- Cadrer un cas d’usage LLM avec des contraintes réelles.
- Choisir une architecture adaptée entre API externe et modèle open source.
- Mesurer la qualité des réponses avec des évaluations fiables.
- Surveiller les coûts par requête et éviter les mauvaises surprises.
- Déployer proprement une application LLM devant des utilisateurs.
Quel cours pour comprendre la théorie ?
Pour solidifier la théorie, je prendrais Stanford CS336 Language Modeling from Scratch, parce qu’il remet de la rigueur sur des sujets souvent survolés.
Ce cours ne vous apprend pas juste à appeler une API ou à brancher un modèle dans une app. Il repart de la base, avec une vraie logique d’ingénierie : collecte des données, nettoyage, préparation, tokenisation, architecture Transformer, entraînement, optimisation, lois d’échelle, évaluation, limites des modèles de langage.

C’est un format académique, donc oui, c’est plus dense. Il faut accepter de ralentir un peu. Mais si vous voulez comprendre pourquoi un grand modèle coûte cher, pourquoi il hallucine, pourquoi il répond lentement, ou pourquoi deux modèles de même taille peuvent avoir des performances très différentes, CS336 est précieux.
Le point qui m’a toujours frappé avec les LLM, c’est que la taille du modèle ne sauve pas de mauvaises données. Un modèle entraîné sur des données bruitées, redondantes ou mal filtrées apprend aussi ce bruit. La qualité des données compte autant que le volume, parfois plus. J’ai vu ce problème chez un client qui voulait “juste fine-tuner” un modèle, alors que 80 % du gain venait du nettoyage des documents internes.
L’architecture Transformer mérite aussi d’être comprise. C’est elle qui a changé le traitement du langage, notamment grâce au mécanisme d’attention. L’attention permet au modèle de pondérer les mots importants dans un contexte, au lieu de lire le texte comme une simple suite rigide. Dit simplement, le modèle apprend mieux les relations entre les morceaux de texte.
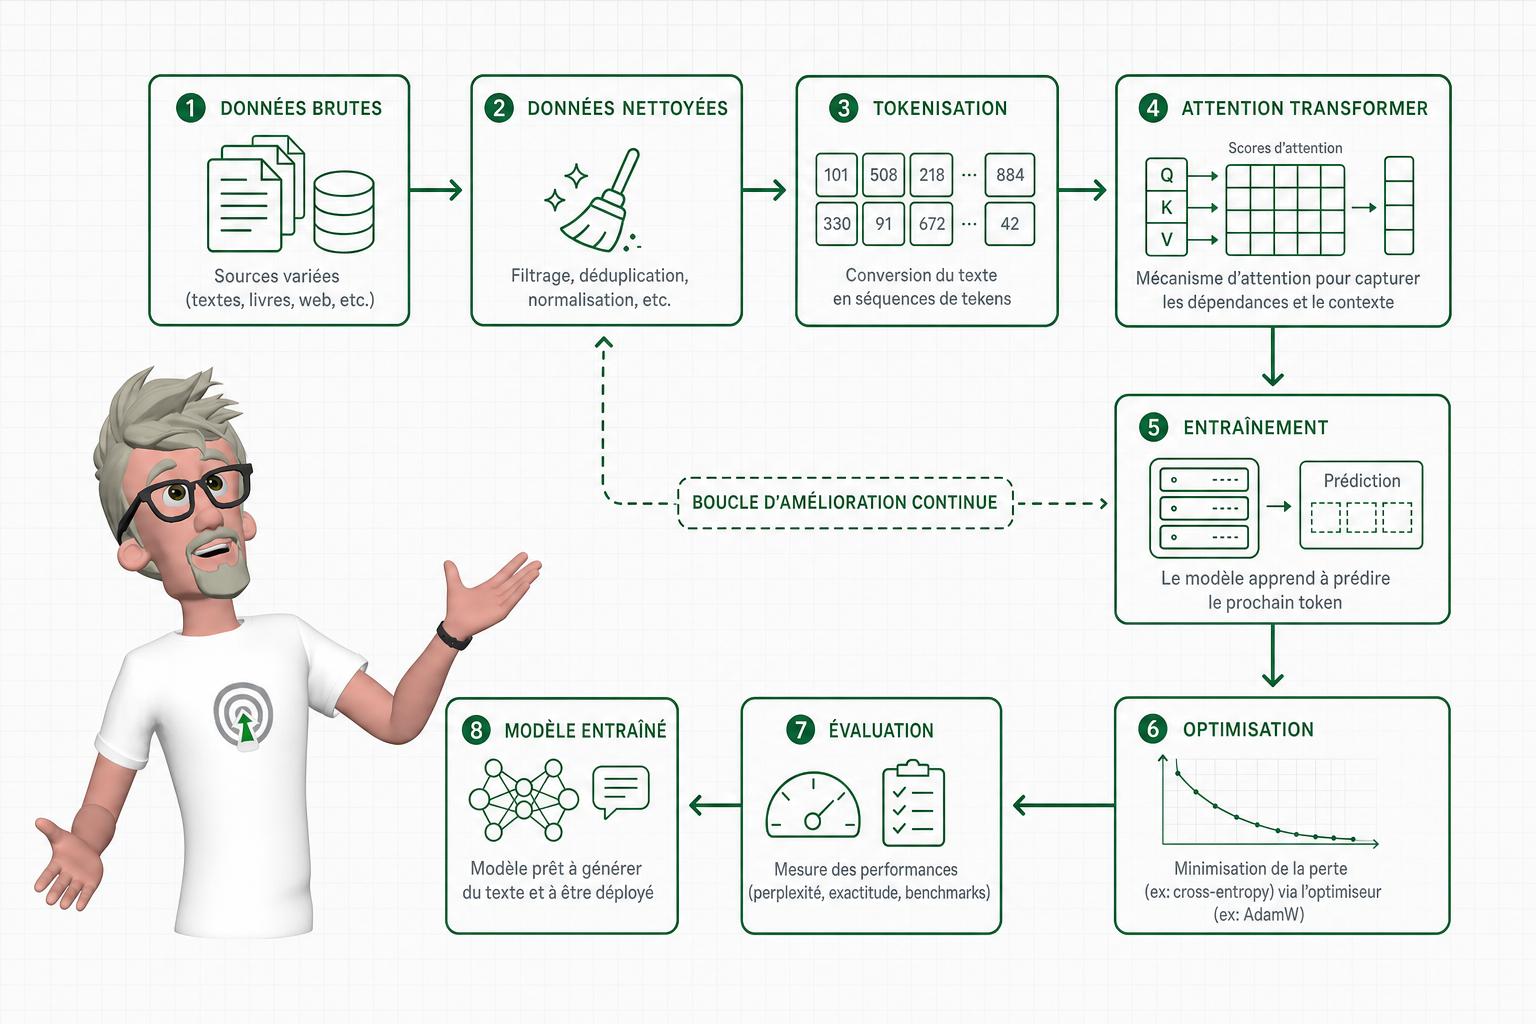
L’entraînement demande aussi une vraie discipline. Taux d’apprentissage, taille des batchs, stabilité numérique, choix du matériel, suivi des métriques… Ce n’est pas magique. Une mauvaise optimisation peut gaspiller des milliers d’euros de calcul pour un modèle médiocre.
Les lois d’échelle aident à raisonner proprement. Elles donnent des repères sur le compromis entre données, calcul et performance. Après le bootcamp orienté production, CS336 permet de relier les choix théoriques aux impacts terrain : latence, coûts, précision, erreurs. La théorie et la production ne sont pas deux mondes séparés. C’est le même système, vu à deux profondeurs différentes.
| Sujet | Ce que ça clarifie | Impact concret |
| Données | Pourquoi la qualité, le filtrage et la diversité comptent autant que le volume. | Moins d’erreurs, moins de biais grossiers, meilleure précision métier. |
| Transformer | Comment l’attention aide le modèle à gérer le contexte et les relations entre tokens. | Meilleure compréhension des limites de contexte, de latence et de mémoire. |
| Optimisation | Pourquoi l’entraînement doit être piloté avec méthode, pas au feeling. | Moins de coûts gaspillés, modèles plus stables, résultats plus reproductibles. |
| Lois d’échelle | Comment arbitrer entre taille du modèle, quantité de données et puissance de calcul. | Meilleures décisions sur budget, performance attendue et choix d’architecture. |
Comment apprendre le fine-tuning LLM ?
Pour apprendre le fine-tuning LLM, je m’appuierais sur la formation gratuite Hugging Face, parce qu’elle connecte directement la théorie aux outils utilisés par les praticiens.
Hugging Face est devenu un passage assez naturel quand on veut manipuler des modèles de langage sans rester dans la théorie. On y retrouve les briques qu’on croise partout dans les vrais projets : les modèles, les datasets, les tokenizers et les pipelines. Un tokenizer, pour faire simple, c’est l’outil qui découpe le texte en morceaux compréhensibles par le modèle. Ce n’est pas un détail technique, c’est souvent là qu’on commence à voir pourquoi un modèle comprend bien certains textes et galère sur d’autres.
Ce que j’aime dans ce cours, c’est qu’il pousse à apprendre par les outils. On ne parle pas juste de “fine-tuner un LLM” comme si c’était magique. On apprend à charger un modèle, comprendre son tokenizer, préparer un dataset, lancer un entraînement ou une adaptation, évaluer le résultat, puis publier ou réutiliser le modèle. C’est exactement le chemin qu’on retrouve dans un projet réel.
Mais je le dis franchement, le fine-tuning n’est pas une baguette magique. Il devient intéressant quand vous avez des données spécifiques, une tâche assez stable et une vraie méthode d’évaluation. Sinon, un bon prompt, du RAG, c’est-à-dire une recherche dans vos documents avant de générer une réponse, ou un pipeline mieux pensé peuvent suffire. J’ai déjà vu des équipes vouloir fine-tuner trop tôt, alors que leur problème venait surtout de données mal rangées ou de consignes trop floues.
Prenons un cas simple. Une entreprise veut adapter un modèle à son vocabulaire support client. Le vrai travail n’est pas seulement de lancer l’entraînement. Il faut sélectionner de bons exemples, nettoyer les conversations, supprimer les cas ambigus, définir ce qu’est une bonne réponse, tester sur des cas jamais vus, puis surveiller le modèle après déploiement. Le fine-tuning commence avant l’entraînement et continue après.
- Ai-je assez de données fiables ?
- Est-ce que la tâche est stable dans le temps ?
- Ai-je un benchmark clair pour comparer les résultats ?
- Ai-je comparé avec du prompting ou du RAG ?
- Puis-je mesurer le gain réel avant et après fine-tuning ?
Comment organiser son parcours LLM ?
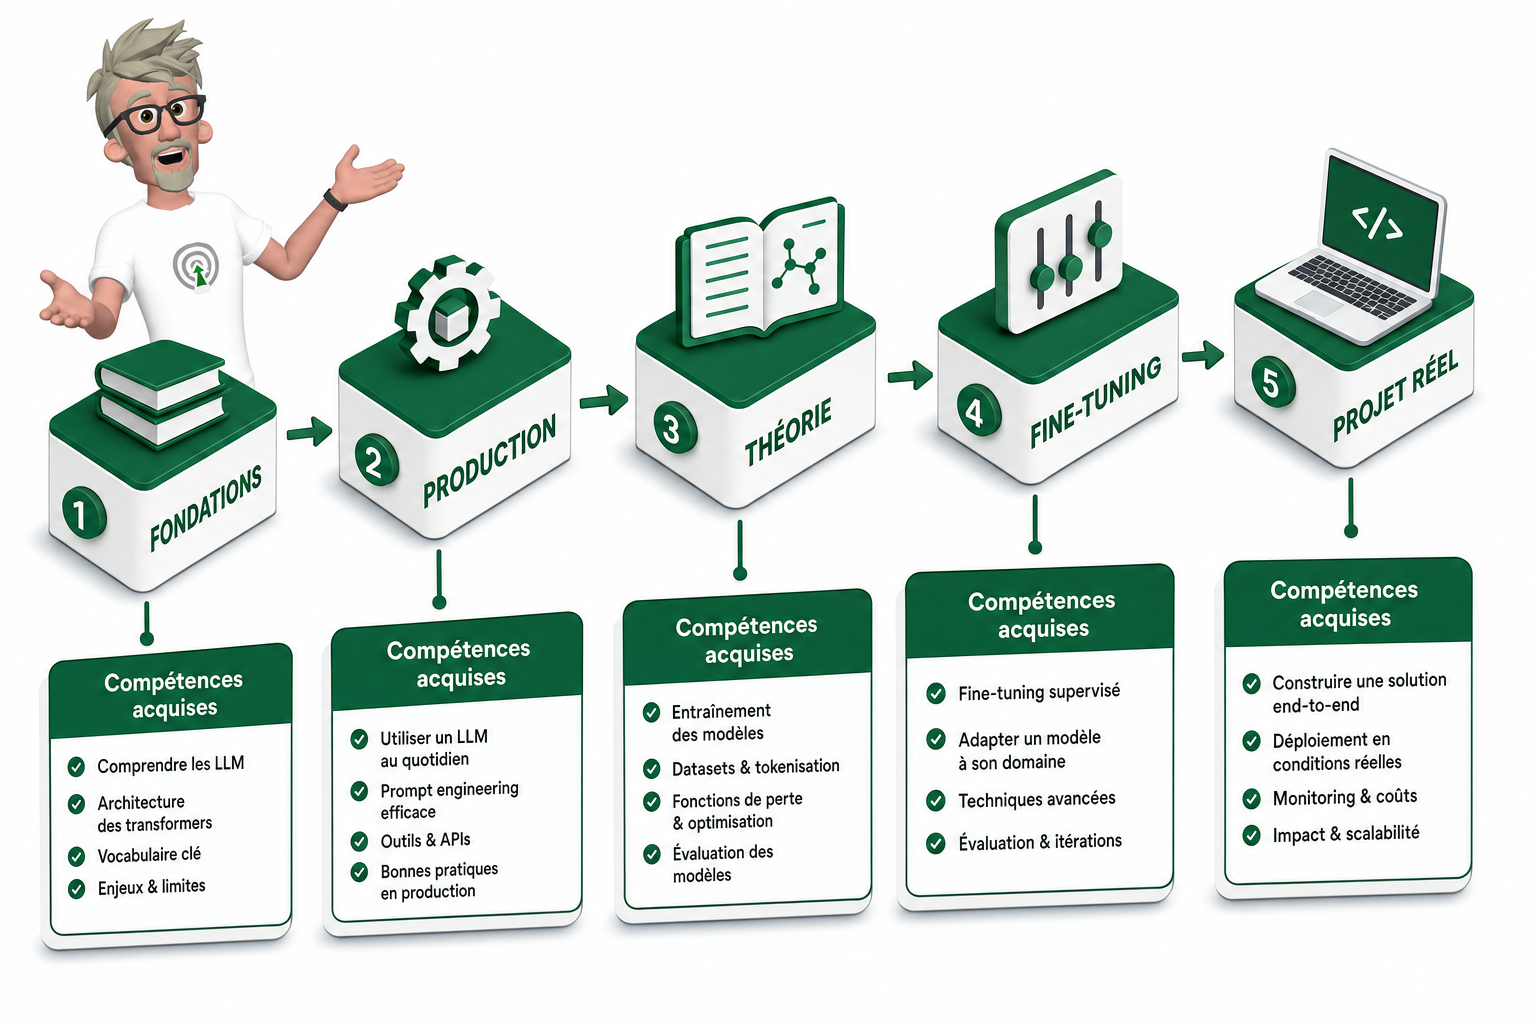
J’organiserais le parcours LLM en suivant l’ordre fondations, production, théorie, fine-tuning, puis projet réel, parce que c’est ce qui évite d’accumuler des cours sans compétence exploitable.
Karpathy donne les bases internes. On comprend ce qu’est un modèle de langage, comment il apprend, pourquoi les tokens comptent, et ce qui se passe vraiment derrière une génération de texte. C’est le socle. Sans ça, on répète des mots comme “attention”, “transformer” ou “embedding” sans vraiment savoir ce qu’on manipule.
Full Stack Deep Learning remet les pieds dans le produit. Là, on parle LLMOps, c’est-à-dire tout ce qui permet de faire tourner un système LLM en vrai : déploiement, monitoring, évaluation, coût, latence, qualité des réponses. C’est souvent là que les illusions tombent. J’ai vu des équipes avec un très bon prompt en démo, mais impossible à maintenir dès qu’il y avait plus d’utilisateurs, plus de documents, ou plus de cas tordus.
Stanford CS336 apporte la profondeur académique. C’est plus dense, mais ça aide à comprendre les compromis sérieux : entraînement, données, scaling, architecture, performance. Hugging Face, lui, transforme tout ça en gestes concrets. On charge un modèle, on teste, on fine-tune, on évalue, on comprend ce que veut dire “faire tourner un modèle” autrement qu’en regardant une vidéo.
Pour avancer vite, je ferais simple :
- Coder les notebooks ou les exemples, même imparfaitement.
- Noter les concepts qui reviennent partout : tokens, contexte, embeddings, RAG, évaluation, latence, coût.
- Construire une mini application LLM utile, pas un jouet trop abstrait.
- Ajouter une évaluation simple avec quelques cas attendus et des cas limites.
- Mesurer le temps de réponse et le coût par requête.
- Tester le fine-tuning seulement si le besoin est clair, pas parce que ça sonne avancé.
La différence entre débutant avancé et praticien, ce n’est pas le nombre de vidéos vues. C’est la capacité à diagnostiquer pourquoi un système LLM répond mal, coûte trop cher ou ne tient pas en production.
| Fondations | Karpathy | Comprendre les mécanismes internes d’un LLM et parler le bon langage technique. |
| Production | Full Stack Deep Learning | Savoir penser produit, LLMOps, évaluation, coût, latence et fiabilité. |
| Théorie | Stanford CS336 | Gagner en profondeur sur l’entraînement, les données, les architectures et les compromis. |
| Fine-tuning | Hugging Face | Manipuler des modèles, tester des adaptations et comprendre quand le fine-tuning est utile. |
Alors, vous commencez par quel cours LLM ?
Pour apprendre les LLM sérieusement, je ne commencerais pas par empiler des outils. Je partirais des bases avec Karpathy, je passerais vite à la production avec Full Stack Deep Learning, je consoliderais avec Stanford CS336, puis je pratiquerais le fine-tuning avec Hugging Face. Ce parcours évite deux pièges classiques : rester bloqué dans la théorie ou bricoler des démos impossibles à maintenir. Le bon objectif, c’est de comprendre assez pour choisir, évaluer, déployer et améliorer. Le bénéfice pour vous est simple : gagner du temps et construire des systèmes LLM plus fiables.
FAQ
- Quel est le meilleur cours gratuit pour débuter en LLM ?
Je commencerais par Neural Networks: Zero to Hero d’Andrej Karpathy. Il oblige à comprendre les briques internes : autograd, génération de texte, mini GPT, tokenisation. C’est plus exigeant qu’un cours d’initiation classique, mais c’est justement ce qui permet de ne pas rester dépendant des abstractions. - Faut-il connaître les maths pour apprendre les LLM ?
Il faut surtout comprendre les idées clés : gradients, probabilités, embeddings, attention, optimisation. Pas besoin de refaire un master de maths pour démarrer, mais ignorer complètement ces notions limite vite la compréhension. Les cours comme Karpathy et Stanford CS336 aident à monter progressivement. - Quelle différence entre apprendre les LLM et faire du prompt engineering ?
Le prompt engineering aide à mieux utiliser un modèle existant. Apprendre les LLM va plus loin : comprendre comment les modèles sont entraînés, évalués, déployés, surveillés et parfois fine-tunés. Pour un usage professionnel, les deux sont utiles, mais le prompt seul ne suffit pas pour construire un système fiable. - Quand faut-il apprendre le fine-tuning LLM ?
Je le ferais après avoir compris les bases et la production. Le fine-tuning devient pertinent quand vous avez des données propres, une tâche stable et une méthode d’évaluation. Sinon, vous risquez de dépenser du temps et du budget alors qu’un meilleur prompt, un RAG ou une architecture plus propre aurait suffi. - Comment savoir si je suis praticien LLM et plus débutant ?
Vous commencez à devenir praticien quand vous savez diagnostiquer un problème : mauvaise donnée, prompt fragile, modèle mal choisi, coût trop élevé, latence trop forte, évaluation insuffisante. Regarder des cours ne suffit pas. Il faut construire une application, la mesurer, la casser un peu, puis l’améliorer.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des équipes sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA en entreprise et le SEO/GEO. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez structurer un vrai projet IA ou LLM dans votre business, contactez-moi, je peux vous aider à cadrer proprement et à passer du test à l’usage réel.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.