

La détection des hallucinations d’un agent IA repose sur plusieurs contrôles complémentaires, pas sur un score unique. Je détaille les types d’erreurs à repérer, les vérifications de fidélité, de cohérence et d’incertitude, puis le rôle de la validation des sources et du contrôle humain.
Quels types d’hallucinations faut-il détecter ?
Il faut détecter quatre types d’erreurs : les hallucinations factuelles, les hallucinations contextuelles, les confabulations et les auto-contradictions. Elles ne se repèrent pas avec les mêmes contrôles, car elles ne signalent pas le même mode d’échec.
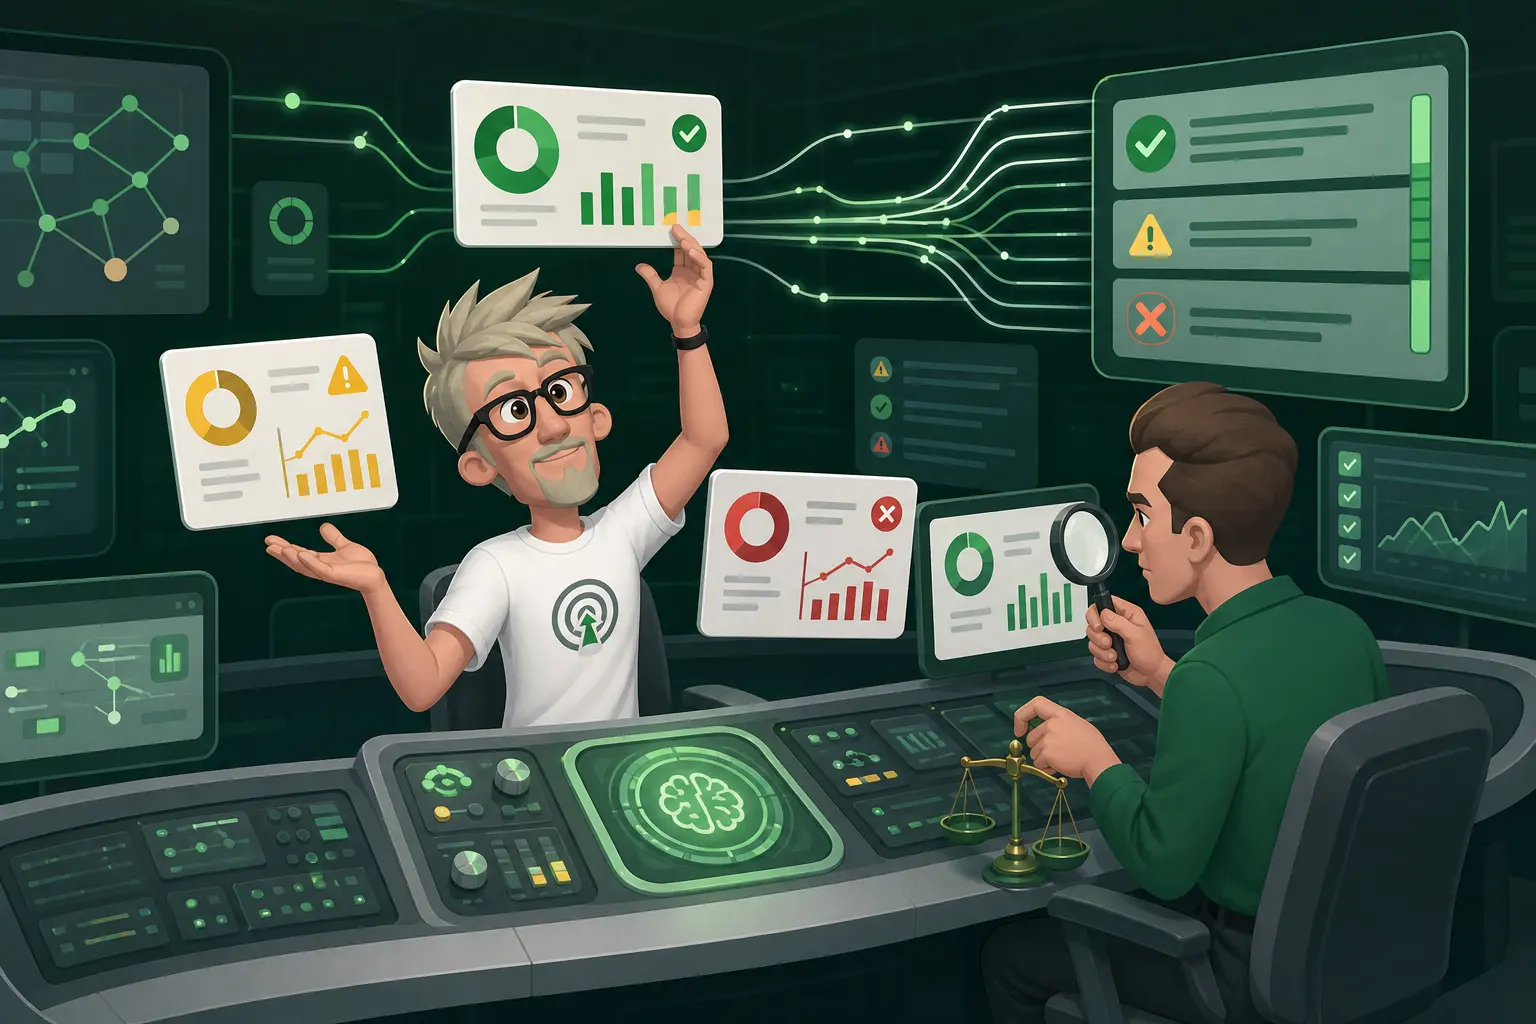
- Hallucinations factuelles. L’agent présente comme vraie une affirmation qui est fausse ou qui n’est pas étayée par les sources disponibles. Exemple générique et fictif : il attribue une date précise à un événement alors qu’aucune source consultée ne permet de la confirmer. Une affirmation peut être plausible sans être établie.
- Hallucinations contextuelles. L’agent déforme, ignore ou interprète mal les informations fournies dans la conversation, un document ou une base de connaissances. Exemple générique et fictif : le contexte indique qu’une demande concerne le produit A, mais l’agent répond en appliquant une règle associée au produit B. Une réponse ancrée dans le contexte n’est pas nécessairement factuellement exacte : le contexte lui-même peut être incomplet ou erroné.
- Confabulations. L’agent comble un manque d’information en inventant des détails, souvent formulés avec assurance. Ce n’est pas seulement une erreur sur un fait isolé : il construit une explication, une référence ou une étape qui n’est pas justifiée par les éléments disponibles. Exemple générique et fictif : à une question sur une procédure non documentée, il décrit des étapes précises comme si elles étaient confirmées.
- Auto-contradictions. L’agent produit des affirmations incompatibles dans une même réponse ou entre plusieurs échanges, sans signaler de changement de périmètre ou de correction. Exemple générique et fictif : il indique d’abord qu’une option est activée, puis affirme qu’elle ne l’est pas, pour le même cas.
La distinction compte en production. Une vérification de cohérence interne peut repérer une contradiction, mais pas confirmer un fait. Une comparaison avec les sources peut détecter un défaut d’ancrage, mais ne suffit pas toujours à valider leur exactitude. Le choix des contrôles doit donc partir du type d’erreur à détecter : c’est ce qui permet d’associer à chaque risque un test pertinent.
Comment combiner les contrôles en production ?
Une détection robuste combine plusieurs vérifications choisies selon le mode d’échec à prévenir. Aucun signal isolé ne suffit : une réponse peut être cohérente tout en étant fausse, ou correctement formulée sans être étayée par les sources disponibles.
Agents IA n8n : une formation pratique pour accélerer votre productivité avec le No Code !
Les formations n8n vous ouvrent les portes d’une automatisation intelligente, fluide et évolutive. Vous y apprendrez à construire des workflows sur mesure, à interconnecter vos outils métiers, à transformer vos données, et même à intégrer des agents IA ou des systèmes RAG dans vos scénarios.
En production, j’organise les contrôles par couches. Chaque couche cible un risque différent et ajoute un indice exploitable, sans prétendre prouver à elle seule qu’une réponse est fiable.
- Ancrage dans le contexte. Je vérifie si les affirmations importantes sont soutenues par les documents fournis ou récupérés. Une affirmation sans source identifiable peut signaler une hallucination, mais l’absence de citation ne démontre pas automatiquement qu’elle est fausse.
- Comparaison entre réponses. Je compare plusieurs réponses produites pour la même demande, ou je confronte la réponse à une reformulation indépendante. Des divergences sur un fait critique constituent un signal de risque. Des réponses concordantes ne garantissent pas leur exactitude : les mêmes biais peuvent se répéter.
- Estimation de l’incertitude. J’examine les réserves exprimées par l’agent, les informations manquantes et les contradictions détectées. Une formulation assurée n’est pas une preuve de justesse. À l’inverse, une incertitude déclarée doit déclencher une vérification adaptée, pas un rejet automatique.
- Validation humaine. Je la réserve aux cas où l’erreur aurait un impact important, où les sources se contredisent ou où le système ne peut pas justifier sa réponse. L’agent peut alors s’abstenir, demander une précision ou transmettre le cas à une personne.
Je traite donc chaque signal comme un indice, jamais comme une preuve absolue. Un score unique masque les différences entre erreurs factuelles, réponses non étayées et contradictions. Plusieurs signaux complémentaires couvrent mieux ces risques, à condition de les interpréter selon le contexte métier et le coût d’une erreur.
La suite porte sur les contrôles de fidélité, qui vérifient si la réponse respecte les sources, et les contrôles d’ancrage, qui relient ses affirmations au contexte disponible.
Comment vérifier l’ancrage d’une réponse ?
Je vérifie l’ancrage en découpant la réponse en affirmations, puis en comparant chacune aux documents récupérés par le workflow RAG. Une réponse peut être globalement pertinente tout en contenant une phrase non étayée : le contrôle doit donc porter sur chaque affirmation, pas seulement sur le texte dans son ensemble.
Pour chaque affirmation, je cherche dans le contexte une preuve qui la soutient directement. Je distingue trois cas : l’affirmation est étayée, elle est contredite, ou les documents ne permettent pas de trancher. Ce contrôle repère notamment les détails ajoutés par le modèle, les conclusions qui dépassent les éléments disponibles et les réponses qui présentent une information absente des sources comme un fait établi.
Cette vérification mesure le soutien apporté par le contexte, pas l’exactitude des documents eux-mêmes. Si une source contient une erreur, l’agent peut produire une réponse parfaitement ancrée dans cette erreur. L’ancrage n’est donc pas une validation de la vérité : il indique si la réponse respecte les éléments fournis.
Des outils comme DeepEval peuvent automatiser ce type d’évaluation sur des jeux de test, des jeux de données d’évaluation et des sorties en production. Je les utilise pour suivre les résultats dans le temps et repérer les cas qui nécessitent une revue humaine, pas comme preuve que les sources sont fiables.
Enfin, une réponse ancrée peut rester instable. Pour le détecter, je compare les réponses produites à partir de formulations équivalentes, de contextes légèrement différents ou de plusieurs exécutions. Des écarts importants sur les faits, les sources citées ou le niveau de certitude signalent un autre risque : l’agent ne répond pas de façon robuste.
Que révèlent la cohérence et l’entropie sémantique ?
La cohérence et l’entropie sémantique signalent l’instabilité ou l’incertitude d’une réponse. Elles ne prouvent pas qu’elle est exacte. Je les utilise comme des indicateurs pour décider quand approfondir le contrôle, pas comme des preuves de fiabilité.
La vérification de cohérence interne consiste à poser plusieurs fois la même question, dans des conditions comparables, puis à confronter les réponses. Je regarde surtout les divergences qui changent le sens, les faits avancés ou la conclusion. Une variation de formulation n’est pas forcément problématique ; une date, un chiffre ou une recommandation qui change mérite une vérification.
Cette méthode a une limite importante : un agent peut répéter la même erreur avec constance. Des réponses cohérentes peuvent donc être fausses, notamment si elles reposent toutes sur une source erronée ou une information absente de son contexte. La stabilité mesure ici la répétabilité, pas la vérité.
L’entropie sémantique examine la diversité de sens entre plusieurs réponses générées à la même question. On regroupe les réponses qui expriment une idée équivalente, même si leurs mots diffèrent, puis on observe leur répartition entre ces groupes. Si les réponses se concentrent autour d’un même sens, l’agent semble plus stable sur cette question. Si elles se répartissent entre plusieurs interprétations incompatibles, l’incertitude est plus élevée et peut justifier un contrôle supplémentaire.
Ce signal dépend toutefois de la qualité des réponses générées et de leur regroupement sémantique. Il ne faut pas lui attribuer de seuil universel ni en déduire une garantie : plusieurs réponses peuvent converger vers la même affirmation fausse.
Dans un système de production, je relie donc ces signaux à la vérification des sources. Une réponse instable, ou une réponse à fort enjeu, doit être confrontée à des documents fiables et traçables. La cohérence aide à repérer le doute ; les sources permettent d’évaluer les faits.
Pourquoi vérifier les sources récupérées ?
Je vérifie les sources parce qu’une réponse peut reprendre fidèlement le contexte fourni tout en restant erronée. Le document récupéré peut être obsolète, hors sujet ou inexact. La fidélité de la réponse ne garantit donc pas la fiabilité de l’information qui l’a alimentée.
La vérification des sources consiste à confronter les affirmations de l’agent à des références faisant autorité. Selon le sujet, il peut s’agir d’une base de données, d’une API ou de la documentation officielle. L’objectif est de confirmer que l’information récupérée est correcte, et pas seulement que l’agent l’a bien reformulée.
Ce contrôle complète les vérifications de fidélité. Celles-ci évaluent si la réponse reste ancrée dans le contenu fourni, sans ajouter d’éléments absents. La vérification des sources examine la fiabilité de ce contenu. Les deux contrôles répondent à des questions différentes : « La réponse reflète-t-elle les éléments récupérés ? » et « Ces éléments sont-ils fiables ? »
Cette vérification n’est pas infaillible. Une référence peut elle-même contenir une erreur, être dépassée ou ne pas couvrir précisément l’affirmation examinée. Elle réduit donc certains risques, mais ne garantit pas à elle seule l’absence d’hallucination. Quand les sources se contredisent ou que l’information reste incertaine, l’agent ne devrait pas présenter une conclusion non vérifiée comme un fait établi.
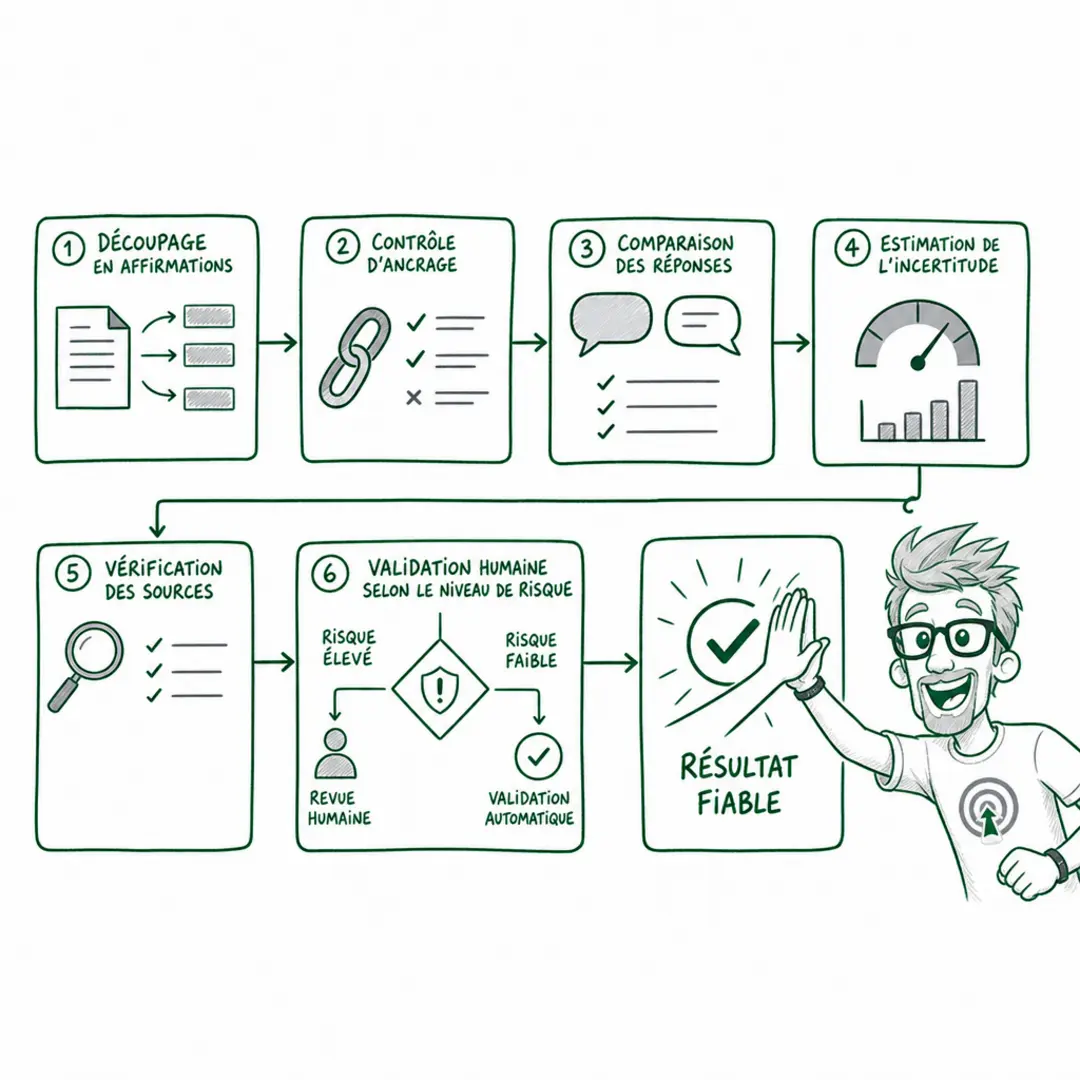
Pour évaluer une réponse, je combine les contrôles suivants :
- Ancrage : la réponse s’appuie sur les éléments récupérés.
- Cohérence : ses affirmations ne se contredisent pas.
- Incertitude : les limites ou les informations manquantes sont signalées.
- Vérification des sources : les affirmations sont confrontées à des références faisant autorité.
- Examen humain : il intervient lorsque le risque le justifie.
Comment fiabiliser durablement un workflow d’agent IA ?
Détecter les hallucinations d’un agent IA exige de distinguer les erreurs factuelles, les réponses non étayées, les confabulations et les contradictions internes. Les contrôles d’ancrage vérifient le lien entre les affirmations et le contexte ; les comparaisons de réponses et l’entropie sémantique révèlent l’instabilité, sans certifier l’exactitude. La vérification des sources complète ces méthodes, car un document récupéré peut lui-même être obsolète ou incorrect. En production, je combine donc plusieurs signaux et prévois une validation humaine selon le risque. Vous obtenez une détection plus large et des décisions de contrôle mieux adaptées à vos workflows.
FAQ
-
Qu’est-ce qu’une hallucination dans un workflow d’agent IA ?
C’est une réponse qui contient une erreur factuelle, une affirmation non étayée par le contexte, des détails plausibles mais non établis, ou une contradiction avec ses propres affirmations. -
Un contrôle d’ancrage garantit-il une réponse exacte ?
Non. Il vérifie si les affirmations sont soutenues par le contexte fourni. Si un document récupéré est inexact, obsolète ou hors sujet, la réponse peut rester erronée tout en étant fidèle à ce document. -
Comment fonctionne la vérification de cohérence interne ?
La même question est posée plusieurs fois, puis les réponses sont comparées. Des divergences importantes signalent qu’une vérification supplémentaire peut être utile, mais des réponses cohérentes peuvent aussi être fausses. -
Que signifie une entropie sémantique élevée ?
Les réponses générées se répartissent entre plusieurs groupes de sens. Une entropie élevée indique une incertitude ou une instabilité et peut justifier une validation supplémentaire, sans établir que la réponse est fausse. -
Pourquoi combiner plusieurs méthodes de détection ?
Chaque méthode cible des modes d’échec différents. Combiner les contrôles de contexte, les comparaisons de réponses, les signaux d’incertitude et la vérification des sources offre une couverture plus large qu’un score unique. Une validation humaine peut compléter ces contrôles selon le risque.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. Je conçois des workflows agentiques et des applications métier intelligentes, avec une attention particulière à la fiabilité des données et des réponses générées.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.