

Un conteneur GTM se gouverne avec des accès maîtrisés, des responsabilités explicites et des changements testés, documentés et réversibles. Voici comment cadrer l’audit, sécuriser les rôles, organiser le conteneur et vérifier la qualité des mesures sans corriger les rapports à l’aveugle.
Comment cadrer l’audit du conteneur GTM ?
Un audit GTM utile part d’un périmètre de test restreint, d’un état de référence daté et des parcours et indicateurs qui influencent les décisions. Sans cette base, les écarts sont difficiles à attribuer et les résultats à comparer.
Cadrez l’audit autour de quatre éléments :
Formez-vous à Google Tag Manager !
Apprenez grâce à nos formations Google Tag Manager une compétence précieuse pour tout professionnel du web. Cet outil permet de simplifier la gestion des balises, de gagner du temps, d'améliorer la précision des données et de personnaliser le suivi des événements. En maîtrisant GTM, vous pouvez optimiser vos campagnes marketing, améliorer les performances de votre site et prendre des décisions basées sur des données fiables et précises.
- Relevez le comportement actuel du conteneur sur les parcours retenus, avec la date de référence.
- Définissez les résultats observables et les critères d’acceptation. Un critère doit permettre de décider si le résultat attendu est atteint, sans interprétation implicite.
- Identifiez les dépendances et les personnes habilitées à valider la signification des paramètres. Un nom de variable ne suffit pas à établir son sens métier.
- Rendez accessibles les diagnostics de mise en œuvre, de destination, de systèmes sources et de consentement. Il faut pouvoir relier ce qui est déclenché, où la donnée est envoyée, d’où elle provient et dans quelles conditions de consentement.
Construisez ensuite une matrice de tests reliée aux parcours et aux critères. Elle doit couvrir les cas positifs, négatifs et limites. Les cas positifs vérifient le comportement attendu. Les cas négatifs contrôlent l’absence d’envoi ou de déclenchement lorsqu’une condition n’est pas remplie. Les cas limites examinent les frontières définies par le périmètre, par exemple une valeur absente ou un consentement modifié.
Pour chaque test, consignez la preuve observée, le résultat attendu et le résultat obtenu. Ajoutez les constats, les décisions prises, le responsable de chaque action et le résultat des nouveaux tests. Cette traçabilité permet de distinguer une correction validée d’un point encore à arbitrer.
Checklist de cadrage :
- Le périmètre, les parcours et l’état de référence daté sont consignés.
- Les résultats observables et critères d’acceptation sont définis.
- Les dépendances et les personnes habilitées à valider les paramètres sont identifiées.
- Les diagnostics de mise en œuvre, destination, systèmes sources et consentement sont accessibles.
- Les cas positifs, négatifs et limites sont testés, avec preuves, responsables et résultats des nouveaux tests.
Qui peut accéder au conteneur et publier ?
Les accès doivent suivre le principe du moindre privilège : chacun dispose uniquement des droits nécessaires à son travail. Je définis explicitement qui crée, qui approuve et qui publie, sans confondre ces responsabilités avec des rôles natifs de GTM.
Je passe régulièrement en revue les utilisateurs du conteneur. Pour chaque compte, je vérifie l’identité, le besoin d’accès, les droits accordés et l’activité récente. Je fais confirmer les comptes sans activité par leur responsable, puis je supprime ceux qui ne sont plus nécessaires et je conserve une trace de la décision. Un accès non réexaminé finit souvent par rester actif après un départ ou un changement de mission.
Chaque changement doit avoir un responsable identifié, de sa demande à son suivi. La fiche de changement précise le résultat observable attendu, les dépendances, l’état initial daté, les paramètres attendus et la procédure de retour arrière. L’état initial daté permet de savoir précisément à quelle configuration revenir. Les paramètres doivent aussi être définis sans ambiguïté : leur nom ne suffit pas à établir leur signification métier.
La validation de cette signification revient aux personnes habilitées, par exemple aux responsables métier ou aux propriétaires de la donnée. Une personne technique peut vérifier qu’un paramètre est transmis comme prévu, mais elle ne peut pas décider seule ce que sa valeur signifie pour le consentement, la mesure ou le pilotage. Cette validation évite qu’une implémentation techniquement correcte produise une interprétation erronée.
Je documente les responsabilités de façon distincte. La répartition ci-dessous relève de l’organisation interne ; elle ne décrit pas des rôles ou réglages spécifiques de GTM.
| Création | Prépare le changement, documente son objectif, ses dépendances et son retour arrière. |
| Approbation | Vérifie le besoin, les paramètres attendus et leur signification auprès des personnes habilitées. |
| Publication | Publie le changement approuvé et consigne le résultat observé. |
Comment organiser les changements et le conteneur ?
Je limite chaque changement : il doit être progressif, attribué à un responsable et réversible. J’interviens dans l’environnement le plus sûr, sur le périmètre le plus restreint possible, une couche logique à la fois. Les dossiers et les conventions de nommage restent cohérents ; sinon, le conteneur devient difficile à auditer et les risques de doublons augmentent.
Avant toute modification, je vérifie les dépendances en amont et en aval. Une balise peut dépendre d’un événement applicatif, d’un état de consentement, d’un identifiant, d’un connecteur ou de champs sources. Je contrôle aussi les consommateurs de la donnée : une variable renommée peut casser plusieurs tags, même si le changement semble local.
Je conserve les preuves de référence avant d’intervenir : version publiée, aperçu du conteneur, traces réseau et données observées dans l’outil destinataire. Je documente la raison de la correction, son périmètre et son responsable. Puis je teste les dépendances avant et après le changement, dans Preview et dans les outils de validation concernés. Chez un client, une correction de nommage dans GTM a modifié le déclenchement d’un événement utilisé par plusieurs tags : le contrôle des dépendances a évité une régression en production.
Le bon objectif n’est pas de masquer un défaut dans un rapport avec une correction ponctuelle. C’est d’améliorer le contrat de mesure partagé entre l’application, GTM et les outils de destination : noms d’événements, paramètres, identifiants et règles de consentement doivent rester explicites et stables.
| Changement | Contrôle | Preuve | Retour arrière |
| Modifier une balise ou un déclencheur | Tester événements, consentement et tags dépendants | Version de référence, Preview et traces réseau | Restaurer la version précédente du conteneur |
| Renommer une variable ou un champ source | Vérifier les références en amont et en aval | Inventaire des dépendances et résultats des tests | Réappliquer le nom et la configuration précédents |
| Modifier un connecteur ou un identifiant | Valider le format et la réception côté destination | Événement de test et réponse de la plateforme | Rétablir la configuration documentée |
Comment vérifier les données et le code utilisé ?
Je vérifie les valeurs importantes depuis leur source faisant autorité jusqu’à leur destination, puis j’examine tout modèle communautaire ou code personnalisé avant de l’utiliser. Une donnée présente dans GTM n’est pas nécessairement correcte, nécessaire ou autorisée à être transmise.
Pour chaque valeur, je compare les éléments qui conditionnent son interprétation et son usage :
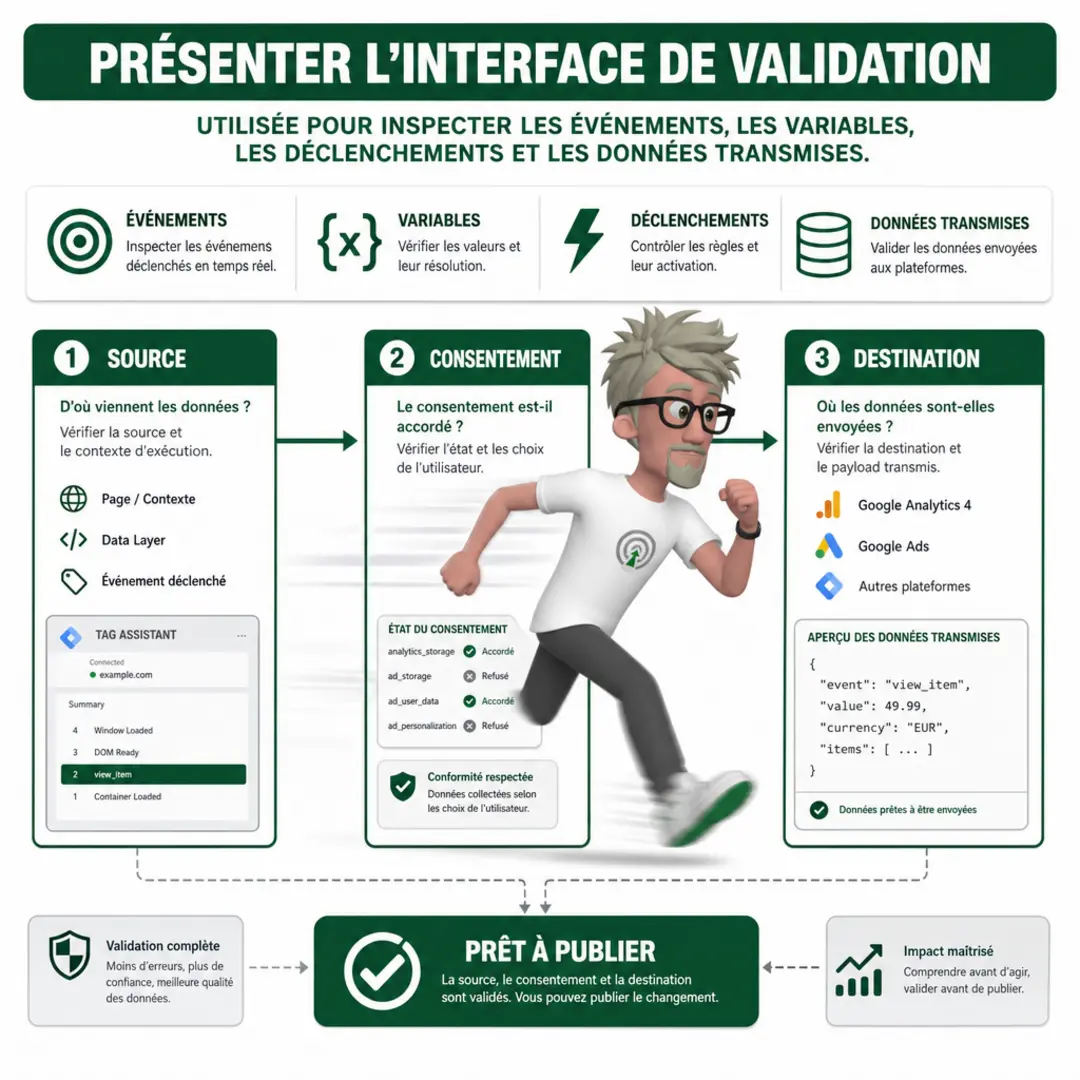
- Nom et type : le nom est cohérent entre la source, la couche de données et la destination, et le type attendu est respecté.
- Périmètre et délai : la valeur concerne le bon utilisateur, événement ou contexte, et elle est disponible au moment où elle est utilisée.
- Identifiants et devises : les identifiants correspondent à la bonne entité ; les montants sont associés à la devise attendue.
- Consentement et valeurs vides : le consentement applicable est pris en compte ; les valeurs absentes, nulles ou vides ne sont pas confondues.
Je limite aussi les données transmises à ce qui est nécessaire à la finalité prévue. Une adresse e-mail, un identifiant ou une donnée de contexte peut exposer des risques de confidentialité ou de gouvernance, même si la balise fonctionne comme prévu. Si une donnée n’est pas nécessaire, je l’écarte.
L’examen d’un modèle communautaire ou d’un code personnalisé doit être un travail défini, pas une validation rapide. Je précise le résultat attendu, le responsable de la revue et les preuves à conserver : par exemple, le périmètre examiné, la version concernée et la décision prise. Je n’intègre pas un modèle ou un code dont l’usage et les effets ne sont pas compris.
Checklist de vérification :
| Élément | À vérifier et à consigner |
| Source | ☐ Source faisant autorité et propriétaire identifiés. |
| Valeur | ☐ Nom, type, périmètre, délai, identifiant, devise et traitement des valeurs vides cohérents. |
| Consentement | ☐ Consentement applicable vérifié ; données non nécessaires écartées. |
| Destination | ☐ Valeur transmise et usage attendu confirmés. |
| Preuve | ☐ Revue du modèle ou du code documentée, avec responsable et décision conservés. |
Votre gouvernance GTM est-elle vérifiable ?
Une gouvernance GTM solide repose sur un périmètre d’audit clair, un état de référence daté et des responsabilités explicites. Les accès suivent le principe du moindre privilège ; les créations, approbations et publications sont attribuées. Les conventions restent cohérentes, et chaque changement est limité, testé, documenté et réversible. La validation suit les données depuis leur source jusqu’à leur destination, en contrôlant les valeurs utiles, le consentement et les risques liés à la confidentialité. Les modèles communautaires et le code personnalisé font eux aussi l’objet d’un examen documenté. En appliquant cette checklist, vous réduisez les changements non maîtrisés et obtenez des mesures plus fiables pour vos décisions.
FAQ
-
Que doit couvrir une checklist de gouvernance GTM ?
Elle doit couvrir le périmètre et l’état de référence, les accès et responsabilités, les conventions du conteneur, les dépendances, les tests, les preuves et les procédures de retour arrière. -
Pourquoi conserver un état de référence avant un changement ?
Il permet de comparer le comportement avant et après l’intervention, de documenter les écarts et de vérifier le résultat attendu avec des preuves datées. -
Comment limiter les risques liés aux accès GTM ?
Appliquez le principe du moindre privilège, supprimez les utilisateurs inactifs et définissez qui peut créer, approuver et publier les changements. -
Que faut-il tester avant de publier un changement ?
Vérifiez les critères d’acceptation et les dépendances en amont et en aval, notamment les événements de l’application, le consentement, les identifiants, les connecteurs et les champs sources. -
Comment vérifier un modèle communautaire ou du code personnalisé ?
Traitez cet examen comme un travail défini : précisez le résultat attendu, désignez un responsable et conservez les preuves de la vérification avant utilisation.
A propos de l’auteur
Je suis Franck Scandolera, expert en mesure digitale et en gouvernance des données. J’aide les équipes à fiabiliser leurs dispositifs de tracking, leurs workflows de validation et les données qui alimentent leurs décisions marketing.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.