

Le Server-Side GTM permet de contrôler les données accessibles aux balises en centralisant leur normalisation et leur minimisation. Je détaille comment cadrer les flux, autoriser les champs sensibles, tester les transformations et prévoir un retour arrière sans perdre le consentement ni les identifiants de corrélation.
Pourquoi centraliser le contrôle des données dans le Server-Side GTM ?
Je centralise le contrôle des données dans le Server-Side GTM pour appliquer des règles communes aux événements avant qu’ils soient accessibles aux balises. Cette couche centrale aide à normaliser les données — rendre leur format cohérent — et à les minimiser en limitant les champs transmis à ceux qui sont nécessaires. Elle ne garantit pas, à elle seule, que les données sont exactes, conformes ou protégées : ces résultats dépendent des règles définies et de leur application.
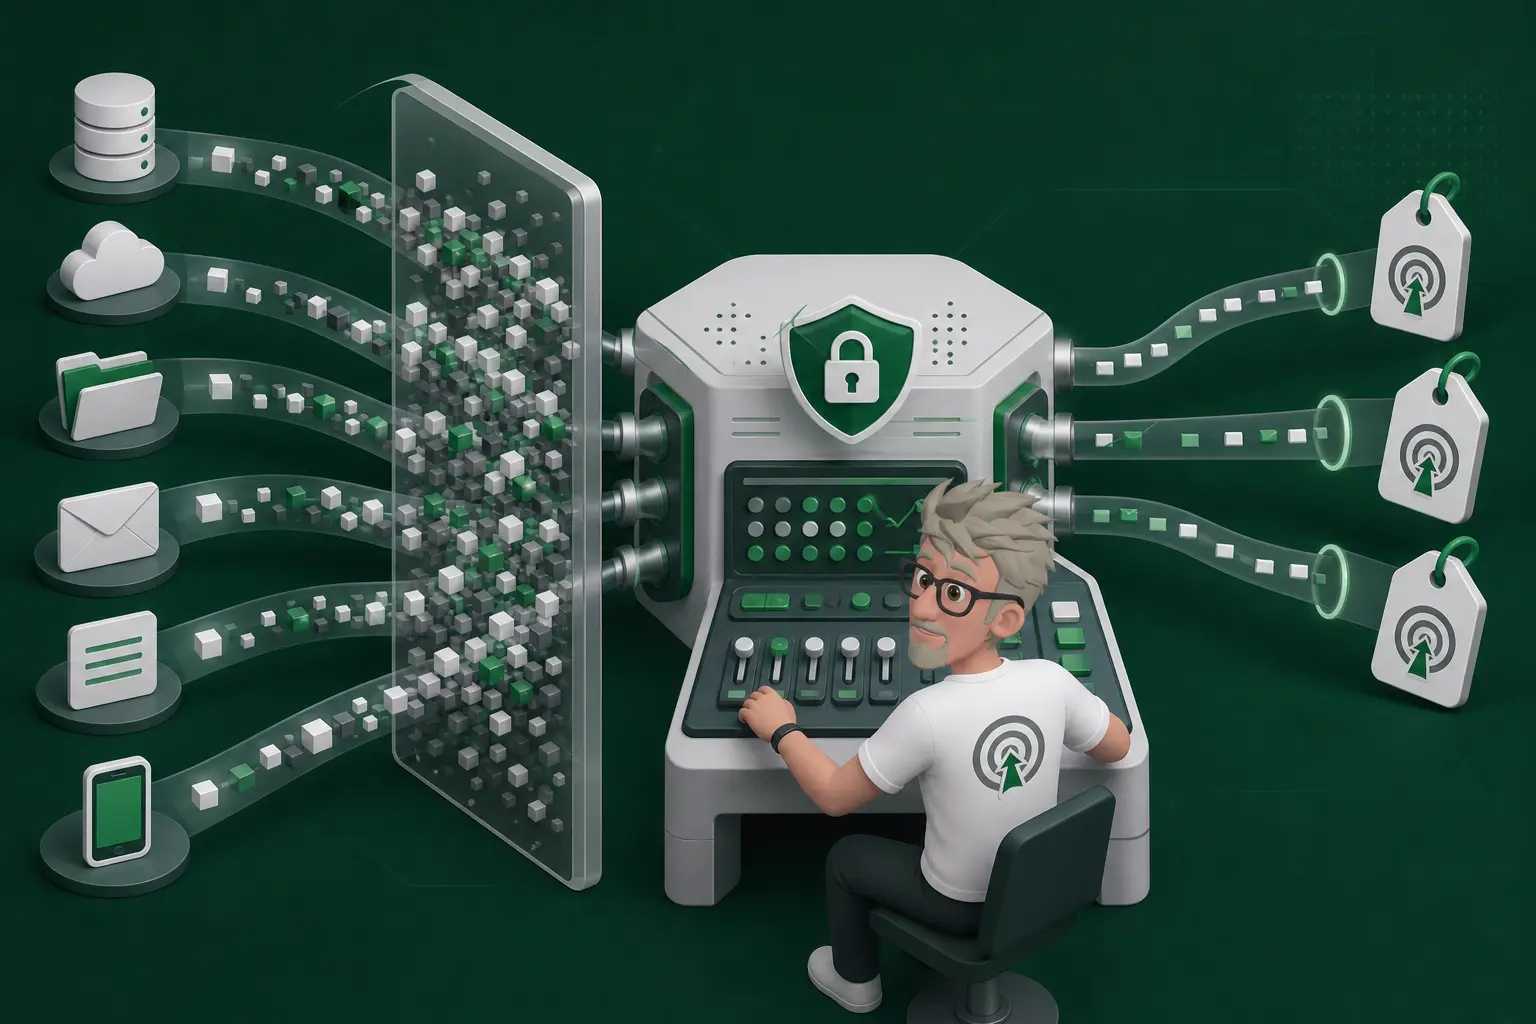
Le point de collecte first-party se situe dans ce flux centralisé. Son rôle est de recevoir les événements concernés et de fournir aux balises les données autorisées. Le périmètre doit rester maîtrisé : je ne configure que les clients et les balises utiles aux événements et aux usages identifiés. Ajouter des composants sans besoin établi augmente la surface à gouverner, sans renforcer automatiquement le contrôle.
Avant de mettre en place cette organisation, je définis les éléments suivants :
Formez-vous à Google Tag Manager !
Apprenez grâce à nos formations Google Tag Manager une compétence précieuse pour tout professionnel du web. Cet outil permet de simplifier la gestion des balises, de gagner du temps, d'améliorer la précision des données et de personnaliser le suivi des événements. En maîtrisant GTM, vous pouvez optimiser vos campagnes marketing, améliorer les performances de votre site et prendre des décisions basées sur des données fiables et précises.
- Les événements métier concernés, avec leur finalité.
- Les flux de données, de leur collecte jusqu’aux balises qui y accèdent.
- Les responsabilités liées à l’infrastructure et à la sécurité.
- Les identifiants autorisés, afin de préciser ceux qui peuvent être présents dans les événements.
- Les règles de gouvernance : données admises, usages attendus et responsabilités de mise à jour.
Ces décisions doivent être documentées. Sans règles explicites, la centralisation déplace le point de traitement, mais ne définit pas ce qui doit être transmis. Il faut aussi distinguer les données nécessaires à un événement métier de celles qui sont simplement disponibles. C’est cette distinction qui rend la minimisation vérifiable.
La suite consiste à établir un état de référence : inventorier les champs réellement présents dans les événements, puis les comparer aux champs autorisés et utiles. Cet inventaire permet de transformer les règles de gouvernance en critères concrets de contrôle.
Comment définir les champs nécessaires à chaque destination ?
Je définis, pour chaque destination, la liste minimale de champs nécessaire à son usage, puis je bloque ou supprime tout champ qui n’a pas de justification fonctionnelle, contractuelle ou réglementaire. Un champ présent dans le navigateur n’a pas vocation à être transmis par défaut.
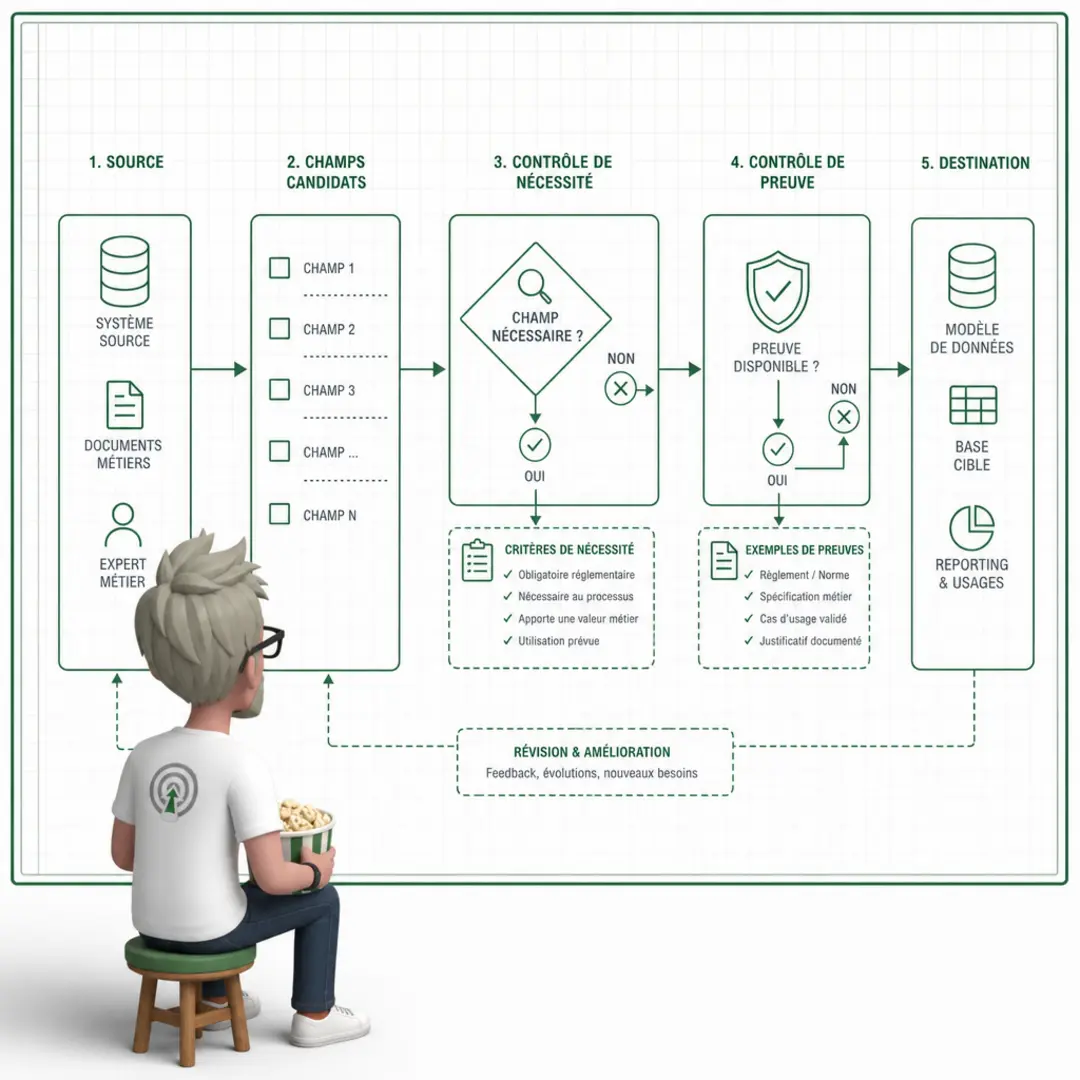
Je pars des exigences documentées de la destination et des traitements réellement activés. Pour chaque champ retenu, je consigne son parcours complet : source d’origine, transformations éventuelles dans le Server-Side GTM, destination, provenance vérifiable et valeur ou format attendu. Les champs qui ne répondent à aucun besoin confirmé sont exclus. Un champ d’identifiant de transaction, par exemple, est ici un cas hypothétique, pas une convention supposée de votre environnement.
Avant chaque modification, je conserve une référence datée de la configuration et du comportement observé. Elle permet de comparer les événements avant et après déploiement. Le dossier de changement précise aussi :
La preuve à recueillir : documentation de la destination, configuration, exemples de requêtes et résultats de tests.
Le responsable du changement et les dépendances, comme les balises, variables, transformations ou équipes concernées.
Les réglages modifiés, les états attendus après déploiement et les alternatives autorisées si la valeur manque ou ne respecte pas le format attendu.
La procédure de retour arrière : configuration précédente, personne habilitée et condition déclenchant la restauration.
La preuve doit confirmer à la fois la présence des champs requis et l’absence des champs écartés. Je vérifie les données au point d’envoi vers chaque destination, pas uniquement dans le conteneur GTM.
| Champ | Source | Destination | Nécessité | Preuve attendue |
| Champ métier à valider | Système source documenté | Destination concernée | Requis ou exclu, selon le besoin confirmé | Exigence documentée et test d’envoi |
| Champ d’identifiant de transaction — exemple hypothétique | Application, sous réserve de validation | Destination concernée, sous réserve de validation | Uniquement si requis par le cas d’usage | Valeur de test et observation de la requête sortante |
Une fois cette liste stabilisée, je traite séparément l’autorisation des flux sensibles : quels événements peuvent partir, vers quelles destinations, sous quelles conditions et avec quelle preuve de consentement.
Comment autoriser les flux sensibles sans élargir leur portée ?
J’autorise un flux sensible en définissant précisément quels événements, quelles valeurs et quels connecteurs sont concernés. La règle d’autorisation sert à contenir le risque : elle ne doit pas devenir un accès général aux données du site. Je pars d’un périmètre minimal, puis je vérifie que chaque transmission répond à un besoin métier et respecte le consentement applicable.
Je teste dans un environnement isolé, sur un ensemble d’événements et de destinations défini avant toute modification. Je n’active pas plusieurs changements en même temps. Une couche logique à la fois : d’abord l’événement entrant, puis les données associées, puis le connecteur destinataire. Cette méthode permet d’identifier l’origine d’une fuite ou d’un blocage sans confondre les causes.
Avant d’autoriser le flux, je vérifie les dépendances en amont et en aval. Un événement applicatif peut contenir des champs inattendus ; le consentement peut varier selon l’utilisateur ; un identifiant peut permettre une réidentification ; un connecteur peut transmettre davantage de données que prévu. Je contrôle aussi les champs sources : leur nom ne garantit ni leur contenu ni leur fiabilité.
Pour chaque valeur transmise, je documente sa provenance et son usage. Je dois pouvoir répondre à trois questions : d’où vient-elle, qui la produit et pourquoi le destinataire en a-t-il besoin ? Si une réponse manque, je n’autorise pas la valeur. Je vérifie ensuite les scénarios de test prévus, y compris les cas sans consentement, avec champs absents ou avec valeurs inattendues.
Cette discipline évite d’élargir le périmètre au fil des corrections. Elle prépare aussi l’étape suivante : normaliser les valeurs approuvées pour que les règles s’appuient sur des données cohérentes, plutôt que sur des variantes difficiles à contrôler.
Comment normaliser les données transmises aux balises ?
Je normalise les données dans une couche centrale du Server-Side GTM, entre leur source et les balises. Chaque valeur suit un chemin vérifiable : source faisant autorité, transformation approuvée, puis destination. Le navigateur ou un système amont peut transmettre une donnée, mais il ne doit pas définir seul son sens ni sa forme finale.
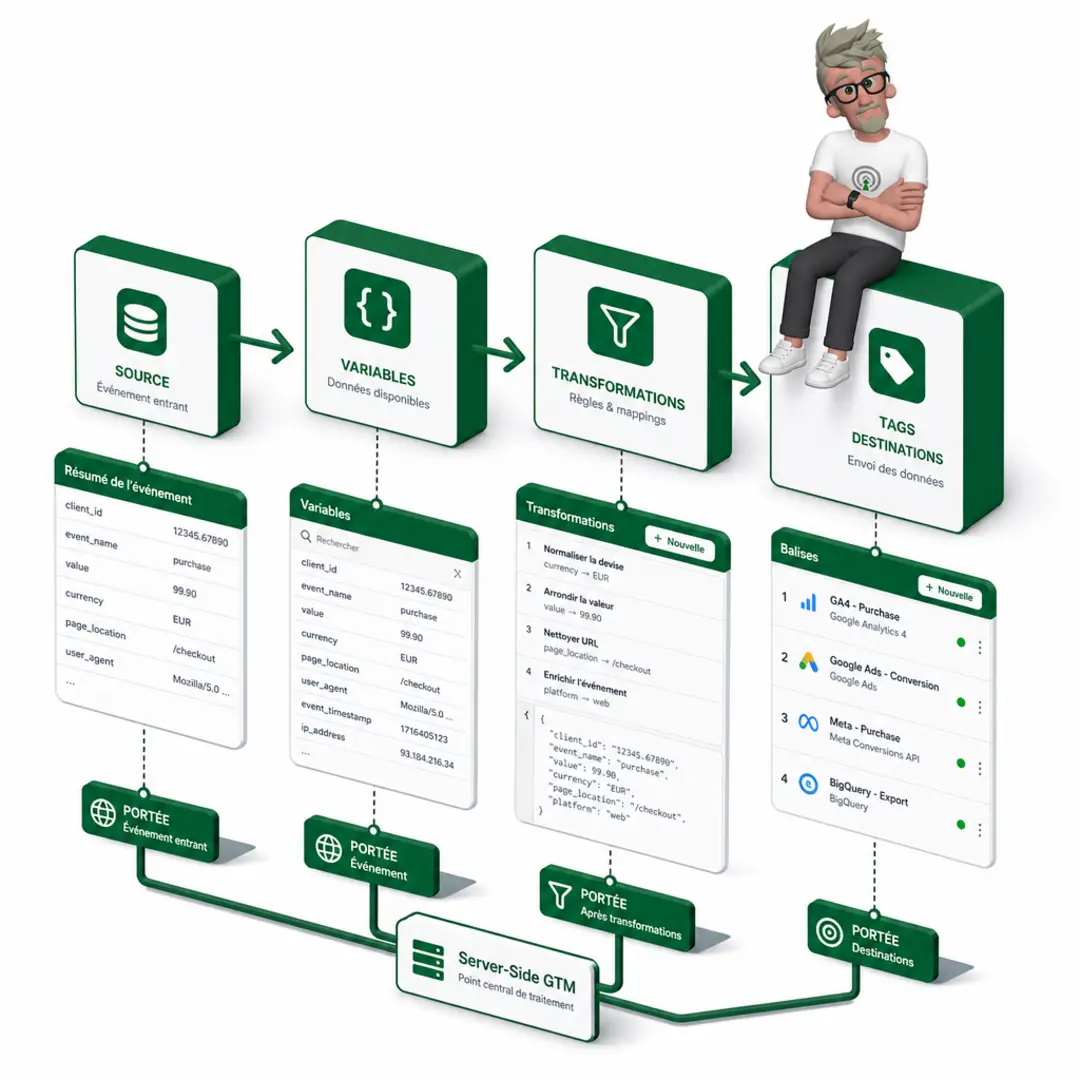
Je documente le nom attendu, le type, la portée et la règle de transformation de chaque champ. La portée précise où la donnée s’applique, par exemple à une requête, un événement ou un utilisateur. Je vérifie aussi son délai de validité, ses identifiants, sa devise, son état de consentement et le traitement des valeurs absentes ou vides. Une valeur vide ne doit pas être convertie silencieusement en zéro, en chaîne ou en valeur par défaut sans règle approuvée.
Cette grille sert à suivre chaque donnée sans imposer de règle propre à un outil :
| Contrôle | Vérification |
| Nom et type | Le nom correspond au schéma approuvé et le type à celui attendu par la destination. |
| Source et portée | La donnée vient de la source faisant autorité et sa portée est explicite. |
| Délai et identifiants | La fraîcheur est suffisante et les identifiants sont nécessaires, cohérents et autorisés. |
| Montants et devise | Le montant et la devise restent interprétables et cohérents dans tout le flux. |
| Consentement et valeurs vides | La transmission respecte le consentement applicable ; les valeurs absentes sont traitées explicitement. |
La minimisation des données et les exigences de consentement se conçoivent dès le départ : je ne collecte ni ne transmets un champ « au cas où ». Une donnée non nécessaire à la finalité ou non autorisée n’est pas envoyée à la balise.
Une vérification visuelle du navigateur ou de l’interface ne suffit pas. Je la complète par une trace des requêtes et, quand c’est possible, par l’examen des enregistrements effectivement transmis. Je peux ainsi repérer une transformation incorrecte, un champ inattendu ou une valeur qui fuit vers une destination.
Une fois les données normalisées, j’applique les conditions à la portée prévue pour chaque balise, puis je valide les cas autorisés, refusés et incomplets avant le déploiement.
Comment tester les transformations et prévoir un retour arrière ?
Je teste une transformation en appliquant ses conditions uniquement aux balises prévues. Je ne suppose pas qu’un mécanisme technique non spécifié limite automatiquement sa portée : ce périmètre doit être vérifié sur les données réellement traitées.
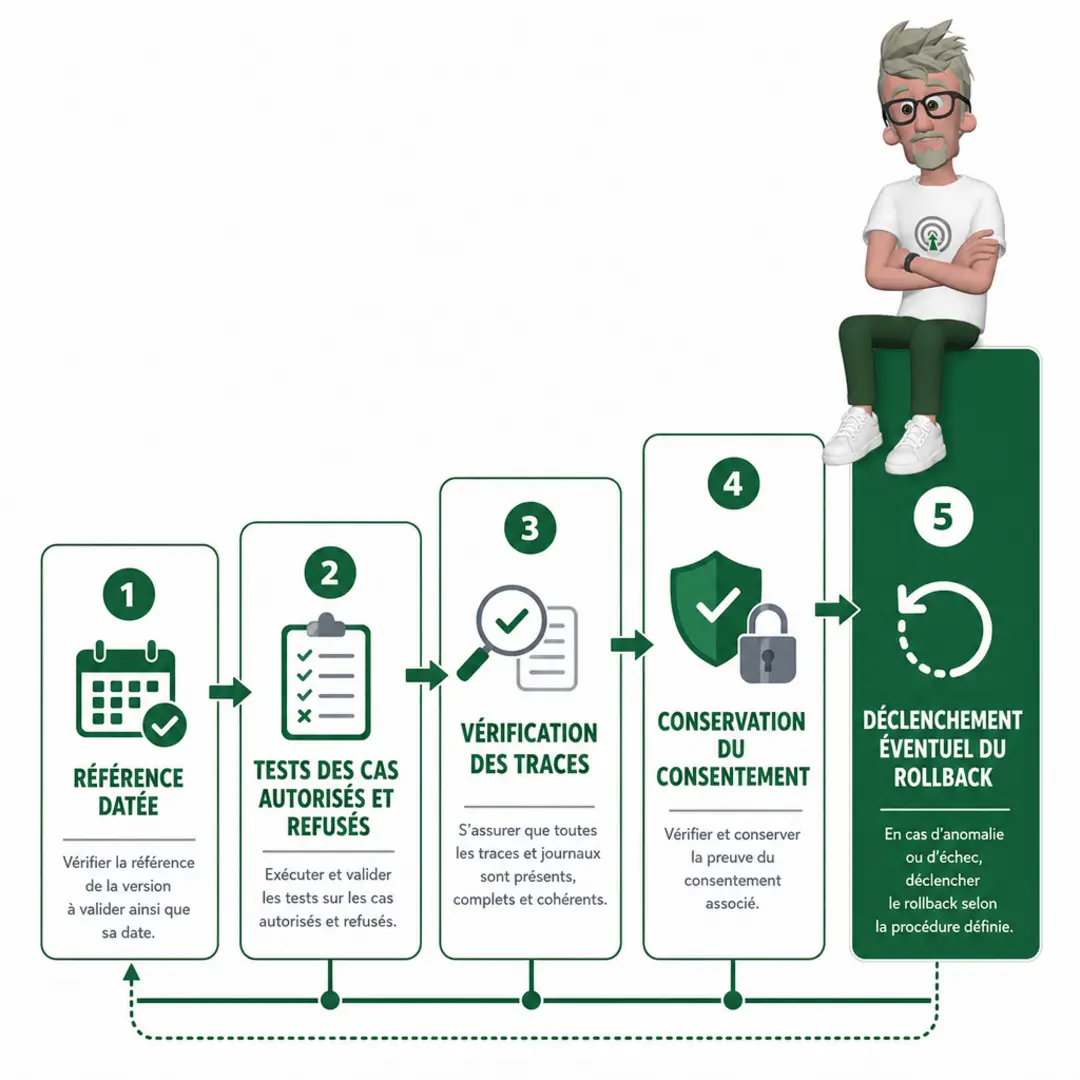
Avant le test, je fixe le périmètre, la référence et les états attendus. La référence doit être datée et permettre de comparer le comportement avant et après la transformation. Je vérifie ensuite les traces de requêtes ou les enregistrements transmis, ainsi que les dépendances concernées.
- Je confirme que les événements inclus et exclus correspondent au périmètre défini.
- Je compare les valeurs obtenues aux états attendus, y compris pour les cas où une condition n’est pas satisfaite.
- Je vérifie que les dépendances nécessaires au traitement reçoivent les données attendues, sans élargir la portée des balises.
- Je préserve l’état du consentement et les identifiants de corrélation. Ces identifiants permettent de rapprocher une requête de son traitement ou de l’enregistrement transmis, sans modifier le contexte du test.
Pour une intégration avec un backend ou un CRM, je vérifie aussi la gestion des erreurs et le comportement en cas de nouvelle tentative. Les traitements doivent être idempotents : une même opération répétée ne doit pas créer de doublons ni produire d’effets supplémentaires. Les erreurs doivent être gérées explicitement, avec un résultat observable qui permet de distinguer un refus, un échec temporaire et une transmission réussie.
Je conserve les preuves de validation : référence datée, périmètre testé, états attendus, traces ou enregistrements observés, dépendances vérifiées et anomalies constatées. Avant toute modification, je documente aussi les responsabilités et la procédure de retour arrière applicable au contexte. Sans ces éléments, le rollback reste une intention, pas une opération maîtrisée.
Votre flux de données est-il désormais maîtrisé ?
Le Server-Side GTM devient une couche de contrôle utile quand les règles sont explicites, documentées et testées. La démarche repose sur un périmètre clair, une cartographie des champs, une référence datée et des règles d’autorisation pour les flux sensibles. La normalisation doit préserver la provenance des valeurs, le consentement et les identifiants de corrélation. Les tests doivent couvrir les dépendances et s’appuyer sur des traces réelles, pas uniquement sur une inspection visuelle. Pour les intégrations backend ou CRM, l’idempotence et la gestion des erreurs sont à prévoir. En documentant aussi les responsabilités et le retour arrière, vous réduisez les données inutiles et gardez un contrôle vérifiable sur ce que vos balises transmettent.
FAQ
-
À quoi sert le Server-Side GTM pour contrôler les données ?
Il centralise le contrôle des données d’événement accessibles aux balises afin de les normaliser et de limiter les champs transmis à ceux qui sont nécessaires. -
Quels champs faut-il envoyer à une destination ?
Uniquement les champs nécessaires à cette destination. Il faut documenter leur source, leur destination, leur valeur attendue et la preuve permettant de vérifier leur transmission. -
Comment traiter les flux sensibles ou à haut risque ?
En définissant des règles d’autorisation explicites, en testant dans un environnement sûr et limité et en vérifiant les dépendances, notamment les événements applicatifs, le consentement, les identifiants et les connecteurs. -
Quels contrôles effectuer lors de la normalisation ?
Vérifiez les noms, les types, les portées, les délais, les identifiants, les devises, le consentement et les valeurs vides. Complétez l’inspection visuelle par des traces de requêtes ou des enregistrements transmis. -
Comment sécuriser une modification avant sa mise en œuvre ?
Conservez une référence datée, définissez un périmètre de test, documentez les dépendances et les preuves attendues, puis préparez une procédure de retour arrière. Pour les intégrations backend ou CRM, prévoyez aussi l’idempotence et une gestion explicite des erreurs.
A propos de l’auteur
Je suis Franck Scandolera, expert en Data engineering et en mesure digitale. J’accompagne la structuration des flux analytics, leur gouvernance et leur automatisation pour rendre les données transmises plus maîtrisées et exploitables.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.