

Je fiabilise un pipeline ETL n8n en pensant relance, doublons, erreurs et checkpoints dès le départ. Le vrai sujet, ce n’est pas juste déplacer la donnée. C’est charger proprement, reprendre sans casse et garder un workflow fiable quand ça tourne en production.
C’est quoi un pipeline ETL fiable ?
Un pipeline ETL fiable, c’est un workflow qui peut tourner seul, échouer proprement, prévenir la bonne personne, puis repartir sans casser vos données. Ce n’est pas juste “j’extrais, je transforme, je charge”. Ça, c’est la base. En production, il faut aussi savoir quand le workflow démarre, quoi faire si une API répond mal, comment notifier sans spammer tout le monde, et comment reprendre sans tout rejouer n’importe comment.
Dans n8n, je vois souvent des workflows qui marchent très bien le premier jour. Un trigger cron, deux appels API, un peu de mapping, puis un insert dans une base SQL. Sur le papier, c’est propre. Le vrai sujet arrive plus tard, quand l’API renvoie une erreur 429, quand un fichier arrive incomplet, ou quand une exécution s’arrête au milieu. Les problèmes arrivent rarement pendant la première exécution. Ils arrivent surtout à la relance après une erreur.
ETL veut dire extraction, transformation, chargement. L’extraction consiste à récupérer des données depuis des applications SaaS, des bases de données, des API ou des fichiers. La transformation sert à nettoyer, valider, enrichir et reformater ces données. Le chargement pousse le résultat vers une destination, par exemple une base SQL, un CRM, un outil métier ou un entrepôt de données comme BigQuery, Snowflake ou PostgreSQL.
Un pipeline de données, au sens large, peut faire plein de choses. Il peut déplacer des fichiers, envoyer des alertes, synchroniser des outils, entraîner un modèle d’IA, générer un rapport. Un pipeline ETL est plus spécifique. Son but, c’est d’intégrer et préparer des données pour qu’elles soient exploitables ailleurs. C’est là que beaucoup de workflows n8n bricolés doivent évoluer. Il ne suffit plus que “ça passe”. Il faut que ça tienne.
Agents IA n8n : une formation pratique pour accélerer votre productivité avec le No Code !
Les formations n8n vous ouvrent les portes d’une automatisation intelligente, fluide et évolutive. Vous y apprendrez à construire des workflows sur mesure, à interconnecter vos outils métiers, à transformer vos données, et même à intégrer des agents IA ou des systèmes RAG dans vos scénarios.
Pour moi, un ETL fiable dans n8n repose sur quelques blocs simples mais non négociables :
- Un déclencheur clair pour savoir pourquoi et quand le pipeline part.
- Une logique d’erreur pour distinguer un bug, une donnée invalide, ou un service temporairement indisponible.
- Une notification utile avec le contexte, pas juste “workflow failed”.
- Une capacité de reprise pour relancer proprement sans doublons ni pertes.
| Bloc | Rôle dans un ETL fiable |
| Extraction | Récupérer les données depuis SaaS, API, base ou fichier. |
| Transformation | Nettoyer, valider, enrichir et reformater les données. |
| Chargement | Envoyer les données vers une destination stable et exploitable. |
| Déclenchement | Lancer le pipeline au bon moment, avec une logique claire. |
| Gestion d’erreur | Détecter, notifier et reprendre sans casser la chaîne. |
ETL ou ELT pour votre workflow ?
Pour votre workflow, je choisis ETL quand je veux contrôler les données avant qu’elles arrivent dans la destination, et ELT quand je veux garder les données brutes pour les transformer ensuite selon les besoins. Il n’y a pas de religion à avoir là-dessus. C’est un choix d’architecture, pas un concours de pureté technique.
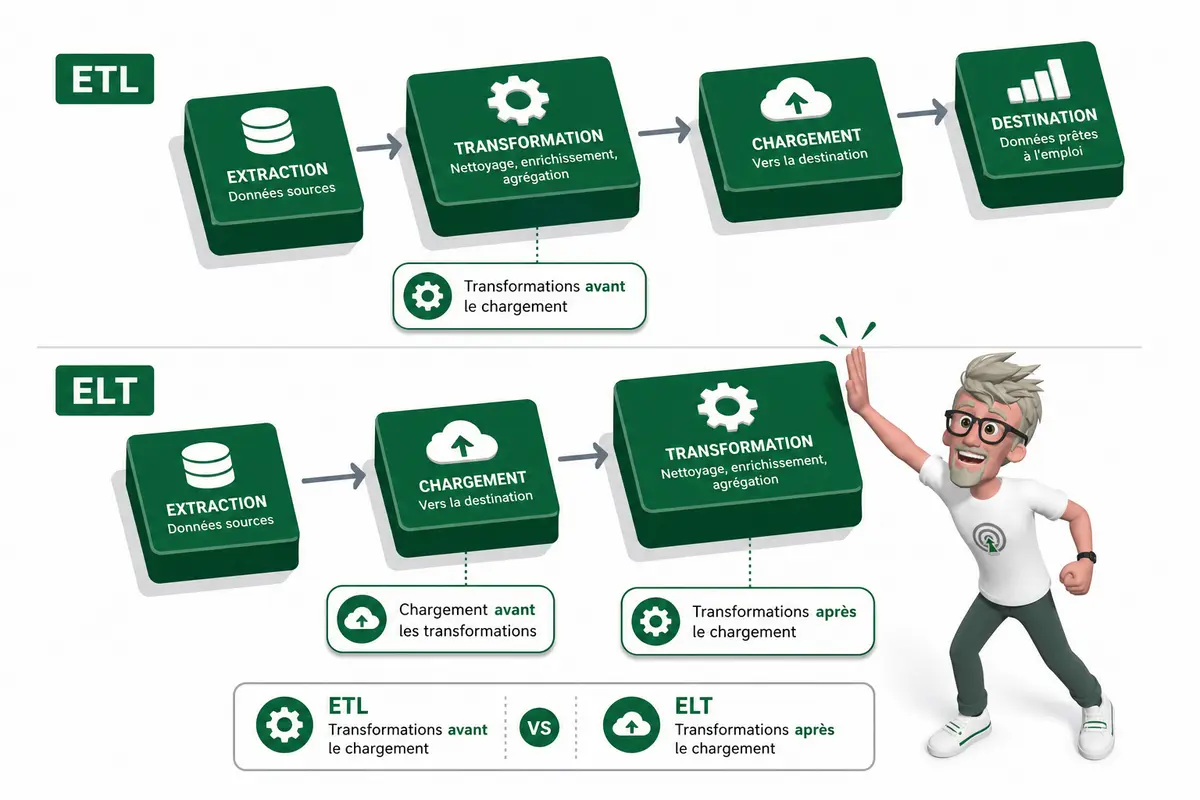
Avec un ETL, pour Extract, Transform, Load, on extrait les données, on les transforme, puis on les charge dans la base, le CRM, le data warehouse ou l’outil métier. Ça veut dire que je nettoie, je filtre, je normalise les formats et je masque éventuellement les données sensibles avant l’arrivée. C’est souvent plus rassurant quand la qualité est critique ou quand on manipule des données personnelles, financières ou contractuelles.
Avec un ELT, pour Extract, Load, Transform, je charge d’abord les données brutes, puis je transforme dans la destination. C’est très pratique quand le volume augmente, quand plusieurs équipes veulent réutiliser la même donnée, ou quand on ne sait pas encore tous les usages business derrière. J’ai déjà vu des clients vouloir tout nettoyer trop tôt, puis regretter parce qu’une info “inutile” devenait importante trois mois après pour un reporting ou un modèle IA.
Dans n8n, les deux approches marchent. n8n peut orchestrer l’extraction, les appels API, les contrôles, les transformations, les chargements et les alertes. Le point important, c’est d’être clair sur une chose simple : où est-ce que la transformation a lieu ? Dans n8n avant le chargement, ou dans la destination après avoir stocké la donnée brute.
Je regarde surtout ces critères avant de choisir :
- Le niveau de contrôle attendu sur la qualité et les formats.
- La sensibilité des données, surtout si elles ne doivent pas circuler partout.
- Le volume, parce que transformer beaucoup de données dans n8n peut vite coûter cher en temps et en maintenance.
- Le nombre d’usages business, car plus il y en a, plus garder du brut peut être intéressant.
| Critère | ETL | ELT |
| Contrôle qualité | Fort contrôle avant le chargement. | Contrôle après chargement, souvent dans la destination. |
| Données sensibles | Plus adapté si je dois filtrer, masquer ou exclure avant stockage. | Possible, mais demande une gouvernance solide sur la destination. |
| Flexibilité | Moins flexible si les règles changent souvent. | Plus flexible, car la donnée brute reste disponible. |
| Volumes | Adapté aux volumes maîtrisés ou aux traitements ciblés. | Souvent meilleur pour les gros volumes. |
| Réutilisation | Réutilisation limitée à la donnée déjà transformée. | Très bon choix si plusieurs usages business exploitent la même source. |
Comment éviter les doublons au chargement ?
Pour éviter les doublons au chargement, je rends le pipeline idempotent. Dit simplement : si je relance deux fois le même workflow n8n, je ne dois pas créer deux fois la même donnée. C’est souvent ce point qui transforme un ETL bricolé en pipeline fiable.
Il y a deux façons classiques de charger les données. Le chargement complet remplace tout le dataset à chaque exécution. C’est simple à comprendre, pratique au début, mais coûteux, lent, et parfois risqué si le volume grossit. Le chargement incrémental, lui, ne traite que les données nouvelles ou modifiées. C’est plus rapide, moins cher, mais ça demande une vraie discipline sur les clés, les dates et les reprises après panne.
| Méthode | Principe | Risque principal |
| Chargement complet | Je recharge tout à chaque fois | Temps long, coûts élevés, écrasement accidentel |
| Chargement incrémental | Je charge seulement ce qui a changé | Doublons si la reprise est mal gérée |
La base, c’est d’avoir une clé unique. Ça peut être un identifiant métier, comme un email client, un ID commande, ou une combinaison de champs. Sans clé stable, n8n ne peut pas deviner si une ligne existe déjà. Ensuite, j’utilise un upsert. C’est une opération qui dit : si la ligne existe, je la mets à jour, sinon je l’insère.
Cette logique est utile dans un nœud SQL, Postgres, MySQL, BigQuery ou même via une API qui accepte les mises à jour conditionnelles.
-- Upsert basé sur une clé unique
-- Si customer_id existe déjà, je mets à jour la ligne
-- Sinon, je crée une nouvelle ligne

INSERT INTO customers (
  customer_id,
  email,
  name,
  updated_at
)
VALUES (
  :customer_id,
  :email,
  :name,
  :updated_at
)
ON CONFLICT (customer_id)
DO UPDATE SET
  email = EXCLUDED.email,
  name = EXCLUDED.name,
  updated_at = EXCLUDED.updated_at;
Pour l’incrémental, je m’appuie souvent sur un timestamp de modification, par exemple updated_at. Je garde aussi un checkpoint, c’est-à-dire le dernier point traité correctement. Si le workflow plante à 10h32, je ne veux pas tout relancer depuis le début. Je veux reprendre au dernier chargement validé.
-- Table de checkpoint pour reprendre après une panne
-- Le workflow lit last_success_at avant d'extraire les données

SELECT last_success_at
FROM etl_checkpoints
WHERE pipeline_name = 'sync_customers';

-- Extraction incrémentale depuis la source

SELECT *
FROM source_customers
WHERE updated_at > :last_success_at
ORDER BY updated_at ASC;

-- Mise à jour du checkpoint seulement après succès complet

UPDATE etl_checkpoints
SET last_success_at = :max_updated_at_loaded
WHERE pipeline_name = 'sync_customers';
Je conseille aussi d’ajouter des statuts de traitement. Par exemple pending, processing, success, error. C’est très utile quand une ligne échoue à cause d’un format invalide ou d’une API temporairement indisponible. Chez un client, on a divisé par trois les relances manuelles juste en ajoutant ce suivi proprement.
Avant mise en production, je vérifie toujours ces points :
- La donnée cible a une clé unique claire et contrainte en base.
- Le workflow utilise un upsert, pas un insert aveugle.
- Le champ updated_at est fiable et bien alimenté côté source.
- Le checkpoint est mis à jour seulement après un chargement réussi.
- Les erreurs sont stockées avec un statut exploitable.
- Une relance du workflow ne crée aucun doublon.
- Un test de panne au milieu du traitement a été fait.
Batch ou streaming dans n8n ?
Dans n8n, je choisis le batch par défaut, et je passe au streaming seulement quand le délai métier le justifie. C’est souvent le choix le plus fiable, parce qu’un pipeline ETL doit surtout être contrôlable, rejouable et compréhensible quand ça casse.
Le batch, c’est un traitement par paquet, lancé selon un calendrier. Toutes les heures, toutes les nuits, tous les lundis matin. Dans n8n, ça correspond très bien au déclencheur calendrier, ou à un appel API programmé qui vient récupérer les données depuis une source.
Le streaming, lui, traite les événements au fil de l’eau, en temps réel ou presque. Dans n8n, on le retrouve avec un webhook, un événement applicatif, ou un appel API déclenché dès qu’une action arrive dans un outil. Par exemple, une commande créée dans Shopify, un ticket ouvert dans HubSpot, ou un paiement validé dans Stripe.
Dans la vraie vie, le batch est souvent plus simple à fiabiliser. Je sais combien de lignes je traite, je peux loguer le début et la fin, rejouer la période d’hier, comparer les volumes, auditer les erreurs. Chez un client, on avait une synchro de commandes qui tournait toutes les nuits. Pas sexy, mais robuste. Quand une API tombait, on relançait le lot, et on savait exactement où regarder.
Le streaming devient intéressant quand attendre pose un vrai problème. Si une commande doit déclencher une préparation en entrepôt immédiatement, le webhook a du sens. Mais là, il faut être plus carré sur trois points :
- Les retries. Si l’API cible ne répond pas, n8n doit réessayer proprement, sans créer de doublon.
- Les erreurs. Une erreur doit dire où le pipeline s’est arrêté, pas juste “ça a échoué”.
- L’idempotence. Ce mot veut dire qu’un même événement peut être rejoué sans produire deux fois le même résultat.
Les notifications doivent être utiles, pas bruyantes. Une alerte Slack ou email à chaque micro-erreur, c’est du spam. Une alerte claire après plusieurs échecs, avec l’identifiant de la commande, le node n8n concerné et le message API, là ça sert vraiment.
| Besoin | Choix conseillé | Pourquoi |
| Synchroniser des commandes chaque nuit | Batch | Plus simple à rejouer, contrôler et auditer. |
| Mettre à jour un stock toutes les heures | Batch | Le délai est acceptable, la stabilité prime. |
| Traiter une commande dès sa création | Streaming | Le temps de réaction compte vraiment. |
| Réagir à un paiement validé | Streaming | L’événement doit déclencher une action immédiate. |
| Pipeline critique avec API instable | Batch | Les retries et les reprises sont plus faciles à maîtriser. |
Comment reprendre après une panne ?
Pour reprendre après une panne, je pars toujours de trois choses simples : des retries, des checkpoints et des notifications utiles. Sans ça, on est vite dans le flou. On ne sait pas si on doit tout relancer, juste une étape, ou surtout ne rien toucher parce qu’une partie des données est déjà passée.
Les retries, c’est le fait de retenter automatiquement une action qui a échoué. C’est utile pour les erreurs temporaires : une API qui répond trop lentement, une base qui coupe la connexion, un service externe qui renvoie une erreur 502. Dans n8n, je les utilise sur les nœuds sensibles, avec une limite claire. Trois tentatives, parfois cinq, mais pas une boucle infinie qui masque le vrai problème.
Les checkpoints, eux, servent à savoir jusqu’où le pipeline est allé. Par exemple : fichier chargé, données nettoyées, lignes insérées, exports envoyés. Dans n8n, ça peut passer par une table de suivi, un Google Sheet temporaire, une base Postgres, ou un stockage interne. L’idée est simple : si ça casse, je sais précisément où reprendre.
Les notifications doivent vraiment aider l’équipe, pas juste dire “Erreur workflow”. Une bonne alerte contient au minimum ces infos :
- Le workflow concerné, pour savoir où regarder.
- L’étape en erreur, pour éviter de fouiller toute l’exécution.
- L’identifiant de lot, souvent appelé batch_id, pour retrouver les données traitées.
- Le dernier checkpoint, pour savoir quoi relancer.
- Le volume traité, pour mesurer l’impact réel.
Dans n8n, je mets souvent une branche d’erreur sur les étapes critiques, avec un workflow de récupération séparé. Ce workflow peut relancer uniquement le lot concerné, reprendre depuis le dernier checkpoint, ou envoyer une alerte Slack avec le contexte. Chez un client, le vrai gain n’a pas été de rendre le workflow plus joli. Le vrai gain, c’était de savoir exactement quoi relancer après un incident, sans toucher aux données déjà traitées.
Une structure de journal d’exécution peut rester très simple :
| Champ | Rôle |
| batch_id | Identifiant unique du lot traité |
| started_at | Date et heure de début |
| finished_at | Date et heure de fin, si le traitement va au bout |
| status | Succès, erreur, en cours, relancé |
| last_checkpoint | Dernière étape validée |
| error_message | Message d’erreur exploitable |
Avant de dire qu’un pipeline ETL est prêt pour la production, je veux voir au minimum : des retries configurés, des checkpoints persistés, des logs d’exécution lisibles, des notifications avec contexte, une logique de relance testée, et une règle claire pour éviter les doublons. Sans ça, le pipeline marche peut-être aujourd’hui, mais il n’est pas encore fiable.
On veut un pipeline qui repart proprement ?
Un pipeline ETL n8n fiable, ce n’est pas un workflow qui marche une fois en démo. C’est un workflow qui sait extraire, transformer, charger, mais aussi reprendre après une erreur, éviter les doublons et signaler les vrais problèmes. Je choisis ETL ou ELT selon le niveau de contrôle attendu, je choisis batch ou streaming selon le besoin de fraîcheur, et je sécurise le tout avec idempotence, retries et checkpoints. C’est moins spectaculaire que des nodes partout, mais c’est ce qui tient en production. Le bénéfice pour vous est simple : moins de données cassées, moins de relances manuelles, plus de confiance.
FAQ
- Qu’est-ce qu’un pipeline ETL dans n8n ?
Un pipeline ETL dans n8n est un workflow qui extrait des données depuis une source, les transforme dans un format exploitable, puis les charge dans une destination comme une base SQL ou un entrepôt de données. Pour être fiable, il doit aussi gérer les erreurs, les relances et les notifications. - Quelle est la différence entre ETL et ELT ?
Avec l’ETL, je transforme les données avant de les charger. Avec l’ELT, je charge d’abord les données brutes puis je transforme dans la destination. L’ETL donne plus de contrôle avant chargement. L’ELT donne plus de flexibilité quand les données doivent servir à plusieurs usages. - Pourquoi les doublons arrivent dans un pipeline ETL ?
Les doublons arrivent souvent quand un workflow échoue puis est relancé sans logique d’idempotence. Si le pipeline ne sait pas reconnaître ce qui a déjà été traité, il peut recréer les mêmes lignes. Les clés uniques, les upserts et les checkpoints limitent ce risque. - Faut-il choisir un chargement complet ou incrémental ?
Le chargement complet est plus simple, car il remplace tout le dataset à chaque exécution. Le chargement incrémental est plus efficace, car il traite seulement les nouvelles données ou les données modifiées. Il demande par contre une gestion plus stricte des changements et des reprises. - Quand utiliser du batch plutôt que du streaming ?
J’utilise du batch quand un traitement planifié suffit et que je veux garder un contrôle simple sur les relances. J’utilise du streaming quand les événements doivent être traités très vite, par exemple après un webhook. Le streaming demande plus de rigueur sur les retries, les erreurs et l’idempotence.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent fiabiliser leurs workflows data, leurs pipelines et leurs automatisations business, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez rendre vos automatisations n8n plus solides en production, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.