

Il faut savoir coder proprement, intégrer des données réelles, déployer en production et parler business sans se cacher derrière la technique. Le Forward Deployed Engineer est ce profil hybride qui transforme un besoin client flou en logiciel utile, mesurable et maintenable.
C’est quoi un Forward Deployed Engineer ?
Un Forward Deployed Engineer est un ingénieur logiciel qui travaille au plus près des clients pour comprendre leur contexte, construire une solution, la déployer, mesurer son impact et l’améliorer rapidement.
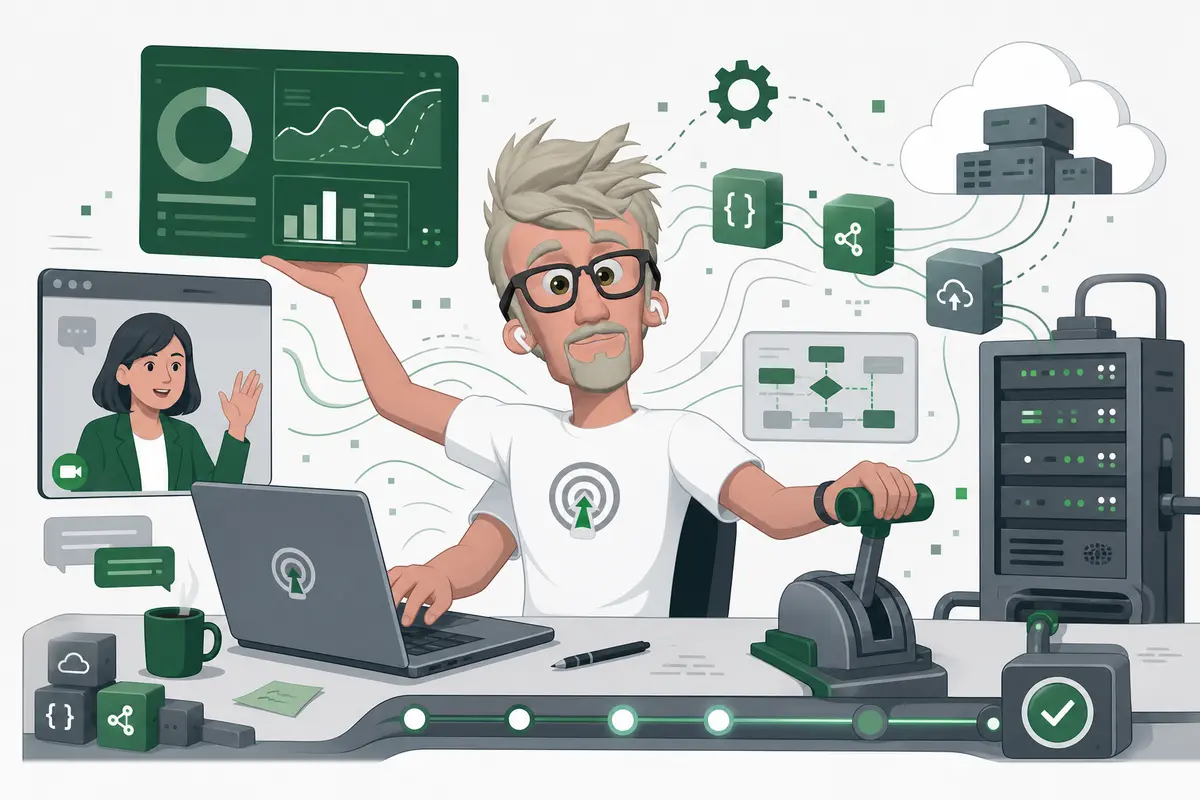
Je le vois comme un profil hybride, mais pas flou. Ce n’est pas juste un développeur qu’on envoie chez le client pour “adapter deux écrans”. Ce n’est pas non plus un consultant qui fait trois ateliers, un schéma d’architecture et un deck de 40 slides. Un FDE doit relier le besoin métier, les données, l’infrastructure, parfois l’IA quand elle apporte vraiment quelque chose, et surtout la mise en production.
Son travail commence souvent avant le code. Il doit cadrer le problème, comprendre pourquoi le client bloque, identifier les contraintes réelles, celles qu’on ne voit jamais dans le brief. Les systèmes existants, les droits d’accès, les données sales, les API mal documentées, les équipes qui n’ont pas le temps, les règles métier planquées dans un fichier Excel vieux de 8 ans. Ça, c’est le terrain.
Ensuite, il construit. Il connecte des systèmes, développe des fonctionnalités, manipule des API, écrit des requêtes SQL, travaille avec des bases de données, déploie avec Docker ou dans le cloud, observe ce qui casse, corrige, mesure, puis améliore. Le mot important ici, c’est exploitable. Le FDE doit livrer quelque chose qui tourne vraiment.
Développez vos compétences avec nos formations expertes en Analytics, Data, IA et automatisation No Code !
Les données sont partout, mais encore faut-il savoir les exploiter. Nos formations vous donnent les clés pour maîtriser Google Analytics, Google Tag Manager, Looker Studio, BigQuery, Prompt Engineering, ChatGPT, Make ou n8n pour créer des agents IA et bien d’autres outils essentiels.
La différence avec un software engineer classique est nette. Un développeur reçoit souvent un ticket déjà cadré. Le FDE, lui, doit parfois créer le ticket lui-même, parce que le problème n’est pas encore clair. La différence avec un consultant technique est tout aussi nette. Le consultant peut recommander une architecture. Le FDE doit être capable de la faire vivre avec du code, des logs, des tests, des données et des utilisateurs réels.
Dans mes missions Data, IA ou automatisation, j’ai souvent vu que les meilleurs profils sont ceux qui acceptent de parler avec les métiers le matin et de debugger une API ou une requête SQL l’après-midi.
| Compétence | Ce que ça veut dire en pratique | Pourquoi c’est important pour un FDE |
| Compréhension métier | Écouter, reformuler, identifier le vrai problème derrière la demande. | Un FDE ne code pas dans le vide, il construit pour un usage réel. |
| Développement logiciel | Créer des fonctionnalités propres, maintenables et utilisables en production. | Il faut livrer du code, pas seulement des idées. |
| Données et API | Connecter des outils, interroger des bases, nettoyer et transformer les données. | La plupart des solutions client vivent entre plusieurs systèmes. |
| Déploiement et debug | Utiliser Docker, le cloud, les logs et les métriques pour faire tourner la solution. | Une solution qui marche en démo mais casse en production ne sert à rien. |
Quelles bases techniques maîtriser ?
La base, c’est Python, les structures de données, Git, GitHub, le terminal et le débogage. Sans ça, le reste devient fragile. Un Forward Deployed Engineer ne peut pas juste bricoler un script qui marche une fois sur sa machine. Il doit livrer du code que d’autres peuvent relire, exécuter, corriger et maintenir.
En Python, je travaillerais surtout les fondamentaux qui reviennent tout le temps sur le terrain : variables, fonctions, classes, exceptions, tests simples, manipulation de fichiers, dictionnaires, listes, files, piles, complexité de base, lecture d’erreurs et logs. Les logs, c’est simplement les messages que votre programme écrit pour expliquer ce qu’il fait. Chez un client, quand un traitement casse à 2h du matin, c’est souvent ça qui sauve la journée.
Git et GitHub sont indispensables parce qu’on ne code presque jamais seul. Il faut versionner son travail, créer des branches, relire du code, collaborer, revenir en arrière si besoin, et documenter les changements. Ce n’est pas théorique. C’est ce qui évite de casser une démo client la veille d’un déploiement.
- git init : Crée un dépôt Git dans le dossier courant.
- git status : Affiche les fichiers modifiés et ce qui reste à valider.
- git add : Prépare un fichier avant de l’enregistrer dans l’historique.
- git commit : Enregistre une version claire de votre travail.
- git branch : Liste ou crée des branches de travail.
- git checkout : Change de branche ou restaure certains fichiers.
- git pull : Récupère les changements depuis GitHub.
- git push : Envoie votre code vers GitHub.
Le terminal compte autant. Il faut savoir naviguer dans les dossiers, lancer des scripts, gérer les variables d’environnement, lire des logs et installer des dépendances. Beaucoup de profils se bloquent encore sur des choses simples parce qu’ils n’ont jamais vraiment pris le terminal au sérieux.
Voici un exemple très réaliste. Un client envoie du JSON imparfait, et je dois le nettoyer sans faire exploser tout le pipeline au premier champ manquant.
from datetime import datetime

def nettoyer_client(data: dict) -> dict:
    # Vérifie que l'identifiant client existe, sinon l'erreur doit être lisible.
    if not data.get("client_id"):
        raise ValueError("Identifiant client manquant dans les données reçues.")

    # Normalise l'email si présent.
    email = data.get("email")
    email = email.strip().lower() if email else None

    # Convertit une date simple si elle existe.
    date_creation = data.get("created_at")
    if date_creation:
        try:
            date_creation = datetime.strptime(date_creation, "%Y-%m-%d").date().isoformat()
        except ValueError:
            date_creation = None

    return {
        "client_id": data["client_id"],
        "email": email,
        "created_at": date_creation,
        "country": data.get("country", "unknown")
    }
Pour progresser vite, je referais des exercices Python simples, je lirais du code existant chaque semaine, je contribuerais à un petit projet GitHub, même modestement, et je m’entraînerais à expliquer mon raisonnement à voix haute. En entretien technique, le bon réflexe vaut souvent autant que la bonne réponse.
Comment gérer API et données réelles ?
Pour gérer des API et des données réelles, il faut savoir récupérer, transformer, stocker et sécuriser des données qui viennent de systèmes différents. C’est le quotidien d’un FDE. Et franchement, dans les missions client, le problème vient rarement du modèle IA. Il vient souvent d’un champ mal compris, d’un email dupliqué, d’un statut métier flou, ou d’une API qui répond différemment le vendredi soir.
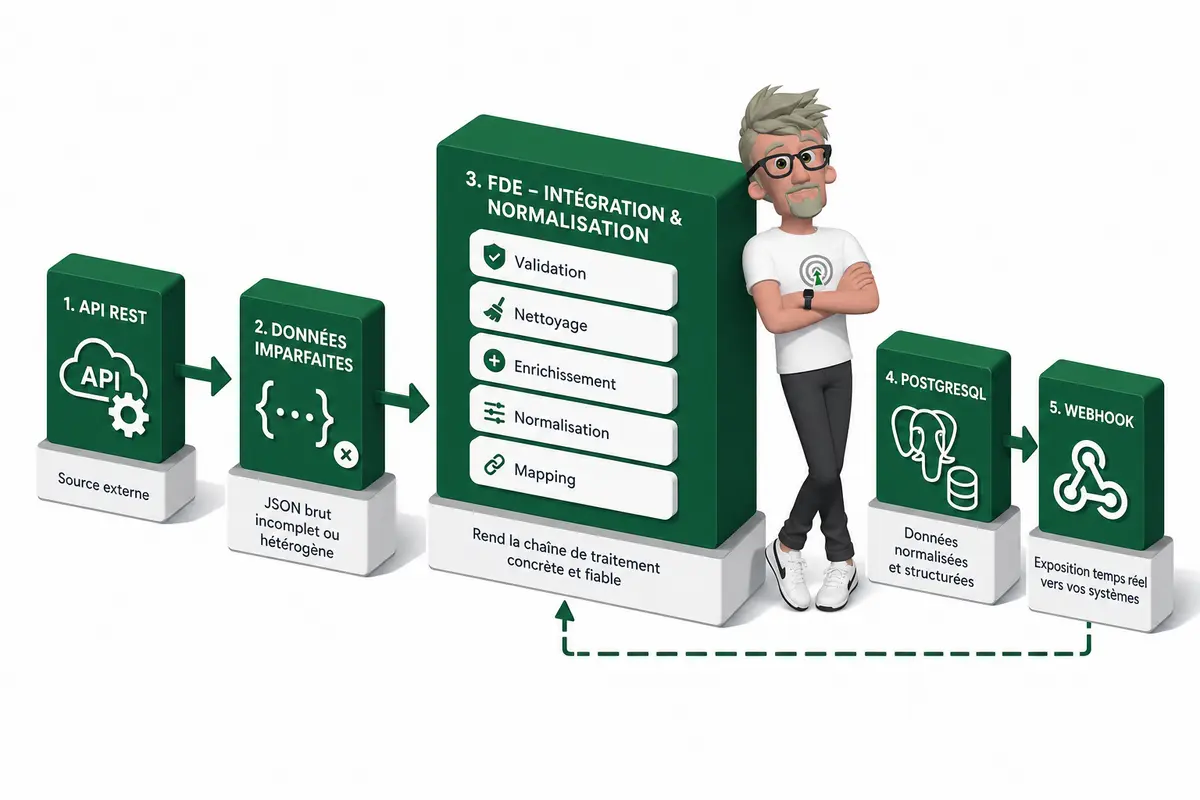
SQL reste central, même avec l’IA et l’automatisation. Il faut maîtriser PostgreSQL, les modèles relationnels simples, les clés primaires, les clés étrangères, les index, les jointures et les agrégations. Une clé primaire identifie une ligne. Une clé étrangère relie deux tables. Un index accélère les recherches. Une jointure rapproche deux sources. Une agrégation répond à des questions métier comme “combien de clients actifs par mois ?”. Si les données sont mal comprises, tout le reste produit de mauvaises décisions.

Côté API, je dois être à l’aise avec REST, les endpoints, les méthodes GET, POST, PUT, DELETE, les codes HTTP, le JSON, la pagination, les filtres, les webhooks et l’authentification. OAuth2 sert à déléguer un accès sécurisé. JWT, c’est un token signé qui prouve qui je suis et ce que j’ai le droit de faire, sans renvoyer mon mot de passe partout.
ETL veut dire : j’extrais, je transforme, je charge. ELT veut dire : j’extrais, je charge, puis je transforme dans la base ou l’entrepôt. En FDE, ça sert à connecter les outils du client, réconcilier les données et rendre la solution fiable.
Voici le SQL minimal côté PostgreSQL. Il crée une table clients simple et un index sur email, utile pour retrouver vite un client.
CREATE TABLE IF NOT EXISTS customers (
    id TEXT PRIMARY KEY,
    email TEXT NOT NULL,
    name TEXT,
    created_at TIMESTAMPTZ,
    source_updated_at TIMESTAMPTZ
);

CREATE INDEX IF NOT EXISTS idx_customers_email
ON customers (email);
Voici un script Python typique. Il appelle une API paginée, lit le token dans une variable d’environnement, gère les erreurs HTTP, normalise les données, puis insère dans PostgreSQL avec une requête paramétrée.
import os
import requests
import psycopg2

API_URL = "https://api.example.com/customers"
TOKEN = os.environ["CUSTOMER_API_TOKEN"]

conn = psycopg2.connect(os.environ["DATABASE_URL"])

def normalize_customer(item):
    # Je transforme le JSON source en format stable pour ma base.
    return {
        "id": str(item["id"]),
        "email": item["email"].lower().strip(),
        "name": item.get("name"),
        "created_at": item.get("created_at"),
        "source_updated_at": item.get("updated_at")
    }

def fetch_customers():
    # Je parcours les pages jusqu’à ce que l’API n’en renvoie plus.
    page = 1
    while True:
        response = requests.get(
            API_URL,
            headers={"Authorization": f"Bearer {TOKEN}"},
            params={"page": page, "limit": 100},
            timeout=20
        )

        # Je lève une erreur claire si l’API refuse ou plante.
        if response.status_code >= 400:
            raise Exception(f"Erreur API {response.status_code}: {response.text}")

        payload = response.json()
        items = payload.get("data", [])

        if not items:
            break

        for item in items:
            yield normalize_customer(item)

        page += 1

def upsert_customer(cur, customer):
    # J’utilise des paramètres pour éviter l’injection SQL.
    cur.execute("""
        INSERT INTO customers (id, email, name, created_at, source_updated_at)
        VALUES (%s, %s, %s, %s, %s)
        ON CONFLICT (id) DO UPDATE SET
            email = EXCLUDED.email,
            name = EXCLUDED.name,
            source_updated_at = EXCLUDED.source_updated_at;
    """, (
        customer["id"],
        customer["email"],
        customer["name"],
        customer["created_at"],
        customer["source_updated_at"]
    ))

with conn:
    with conn.cursor() as cur:
        for customer in fetch_customers():
            upsert_customer(cur, customer)
Un webhook sert quand le client veut pousser un événement vers mon système, au lieu que je vienne chercher les données toutes les heures. Exemple simple avec FastAPI.
from fastapi import FastAPI, HTTPException

app = FastAPI()

@app.post("/webhook/customer")
def customer_webhook(payload: dict):
    # Je valide le minimum avant d’accepter l’événement.
    if "id" not in payload or "email" not in payload:
        raise HTTPException(status_code=400, detail="Payload invalide")

    # Ici, je pourrais normaliser puis stocker le client.
    return {
        "status": "accepted",
        "customer_id": payload["id"]
}| Sujet | Ce qu’il faut savoir faire | Piège fréquent | Bon réflexe |
| SQL | Modéliser, joindre, agréger, indexer | Requêtes lentes ou données dupliquées | Penser clés, contraintes et index |
| API | Appeler, filtrer, paginer, gérer les erreurs | Ignorer les codes HTTP | Logger les erreurs et prévoir les retries |
| Sécurité | Utiliser OAuth2, JWT, variables d’environnement | Mettre un token dans le code | Séparer secrets, code et logs |
| ETL/ELT | Extraire, charger, transformer proprement | Transformer sans comprendre le métier | Valider avec le client les règles de données |
Comment passer du prototype à la production ?
On passe en production quand le logiciel peut tourner ailleurs que sur son ordinateur, être observé, corrigé et relancé sans bricolage.
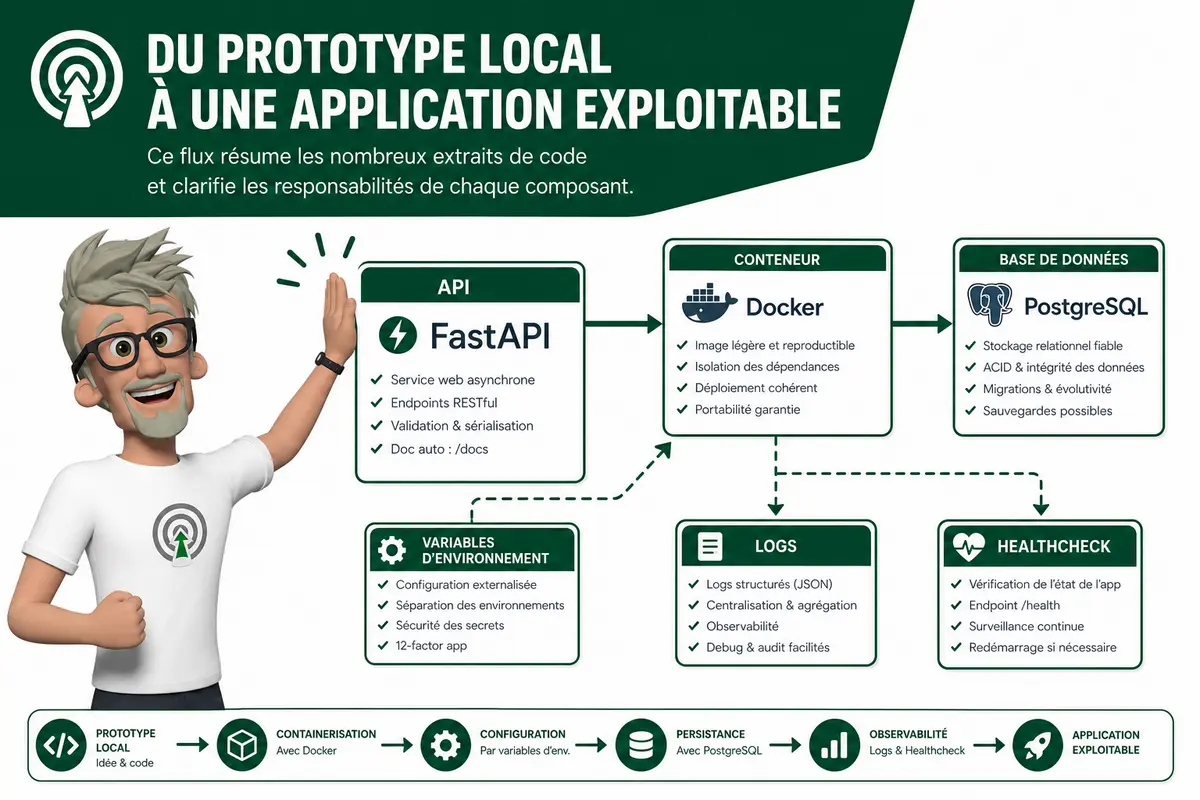
Pour moi, c’est exactement là que le Forward Deployed Engineer fait la différence. Une démo qui marche sur un laptop, c’est bien. Une solution exploitable par un client, avec une base, des logs, une configuration propre et un redémarrage fiable, c’est autre chose.
Docker sert à ça. Une image, c’est le paquet exécutable de l’application. Un conteneur, c’est l’image en train de tourner. Le Dockerfile décrit comment construire l’image. Docker compose lance plusieurs services ensemble, par exemple une API et PostgreSQL. Les variables d’environnement évitent de coder les mots de passe en dur. Les ports exposent l’application. Les volumes gardent les données même si le conteneur redémarre.
Voici une mini API FastAPI connectée à PostgreSQL. C’est le genre de base simple que j’aime utiliser pour vérifier qu’une app est vraiment déployable.
# main.py
import os
import psycopg2
from fastapi import FastAPI

app = FastAPI()

def get_connection():
    # Récupère la configuration depuis l'environnement, pas depuis le code.
    return psycopg2.connect(
        host=os.getenv("DB_HOST"),
        port=os.getenv("DB_PORT", "5432"),
        database=os.getenv("DB_NAME"),
        user=os.getenv("DB_USER"),
        password=os.getenv("DB_PASSWORD")
    )

@app.get("/health")
def health():
    # Sert à vérifier rapidement que l'API répond.
    return {"status": "ok"}

@app.get("/customers")
def customers():
    # Lit quelques lignes depuis PostgreSQL.
    conn = get_connection()
    cur = conn.cursor()
    cur.execute("SELECT id, name FROM customers LIMIT 5")
    rows = cur.fetchall()
    cur.close()
    conn.close()
    return [{"id": row[0], "name": row[1]} for row in rows]
Les dépendances restent minimales, sinon on ne sait plus ce qu’on embarque.
# requirements.txt
fastapi==0.115.0
uvicorn==0.30.6
psycopg2-binary==2.9.9
Le Dockerfile construit l’API dans un environnement reproductible.
# Dockerfile
FROM python:3.12-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY main.py .

CMD ["uvicorn", "main:app", "--host", "0.0.0.0", "--port", "8000"]
Docker compose lance l’API et la base ensemble. Le volume garde les données PostgreSQL.
# docker-compose.yml
services:
  api:
    build: .
    ports:
      - "8000:8000"
    environment:
      DB_HOST: db
      DB_PORT: 5432
      DB_NAME: appdb
      DB_USER: appuser
      DB_PASSWORD: apppassword
    depends_on:
      - db

  db:
    image: postgres:16
    environment:
      POSTGRES_DB: appdb
      POSTGRES_USER: appuser
      POSTGRES_PASSWORD: apppassword
    volumes:
      - postgres_data:/var/lib/postgresql/data

volumes:
  postgres_data:
Pour lancer localement, j’utilise ces commandes.
- docker compose up –build construit l’image et démarre l’API avec PostgreSQL.
- curl http://localhost:8000/health vérifie que l’API répond bien ok.
- docker compose logs -f api affiche les logs de l’API en continu.
- docker compose down arrête les conteneurs proprement.
Dans le cloud, l’idée reste la même. Héberger l’application, connecter une base, gérer les secrets, lire les logs, surveiller les erreurs et déployer une nouvelle version. Pas besoin d’être SRE senior au départ. SRE veut dire Site Reliability Engineering, c’est le métier qui rend les systèmes fiables en production. Mais il faut comprendre ce qui se passe quand l’app ne répond plus.
Les logs doivent aider, pas exposer l’entreprise. Je ne logue jamais les mots de passe, les tokens ou les chaînes de connexion complètes. Je logue l’erreur utile, le contexte, l’identifiant de requête si possible. Et je distingue vite les familles de problèmes : bug applicatif, réseau, base de données indisponible, authentification refusée.
Sur le terrain, le plus gros écart entre un profil junior et un profil solide, ce n’est pas seulement la qualité du code. C’est la capacité à comprendre pourquoi ça casse une fois déployé. J’ai vu des prototypes brillants mourir juste parce que personne ne savait lire les logs ou relancer proprement un service.
Checklist de mise en production :
- Configuration passée par variables d’environnement.
- Secrets stockés hors du code.
- Logs lisibles et sans données sensibles.
- Endpoint healthcheck disponible.
- Base de données accessible et migrable.
- Sauvegarde prévue pour les données importantes.
- Monitoring minimal sur erreurs, latence et disponibilité.
- Documentation courte pour lancer, déployer et dépanner.
Comment se préparer au métier en 2026 ?
Pour se préparer au métier en 2026, je construirais surtout un portfolio qui prouve une chose simple : vous savez partir d’un besoin client, concevoir une solution propre, la déployer, la surveiller et l’améliorer. Pas juste pousser trois scripts Python sur GitHub.
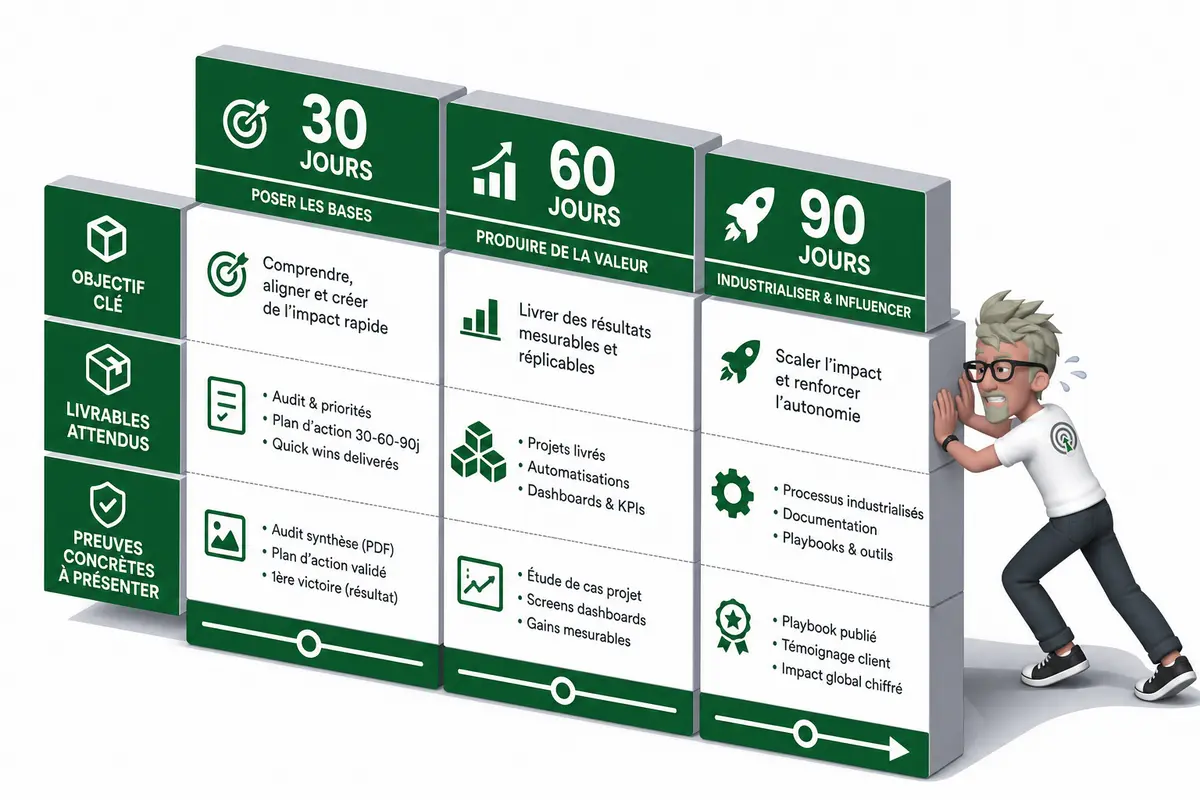
La roadmap est assez claire. Je consolide d’abord les fondamentaux logiciel : Python propre, tests, Git, architecture simple, lecture de code existant. Ensuite je maîtrise les API, les bases de données et l’intégration, parce qu’un FDE passe sa vie à connecter des systèmes qui n’étaient pas faits pour se parler. API veut dire interface entre applications. PostgreSQL, requêtes SQL, webhooks, authentification, pagination, erreurs réseau, tout ça doit devenir naturel.
Après, j’apprends à déployer et opérer. Docker, variables d’environnement, logs, monitoring basique, CI/CD, c’est-à-dire l’automatisation des tests et du déploiement. Puis je travaille le contexte business. Chez un client, la meilleure solution technique est parfois celle qui respecte une contrainte métier pénible, un process interne, ou une équipe qui n’a pas le temps.
Pour l’IA appliquée, je reste sobre. Un FDE n’a pas besoin de vendre de la magie. Il doit savoir quand l’IA aide vraiment : résumé, extraction, classification, assistant métier, recherche dans une base documentaire, automatisation d’un flux. Je regarde surtout la qualité des données, la sécurité, l’évaluation des réponses et l’itération. J’ai déjà vu des projets IA échouer non pas à cause du modèle, mais parce que personne ne savait mesurer si la réponse était utile.
Les meilleurs projets de portfolio sont concrets :
- Une intégration API vers PostgreSQL avec un dashboard ou un endpoint de restitution. Ça prouve que vous savez ingérer, structurer et exposer de la donnée.
- Une application FastAPI dockerisée avec base de données et webhooks. Ça prouve que vous savez construire un service exploitable, pas juste une démo locale.
- Un assistant IA simple branché sur des données internes factices, avec logs et évaluation basique. Ça prouve que vous savez utiliser l’IA avec contrôle, traçabilité et prudence.
Pour les entretiens, je préparerais Python, SQL, conception d’API, debugging, discussion d’architecture et questions comportementales côté client. Le recruteur ne cherche pas seulement une syntaxe parfaite. Il veut voir votre raisonnement, vos hypothèses, votre manière de simplifier un problème flou.
La posture client fait souvent la différence. Je pose des questions simples, je reformule, je refuse les usines à gaz, je documente les décisions, je livre vite une première version, puis je mesure. C’est moins spectaculaire qu’un gros discours technique, mais c’est exactement ce qu’on attend sur le terrain.
| Période | Objectifs | Livrables | Compétences travaillées | Preuve concrète |
| 30 jours | Solidifier Python, SQL, API. | Projet API vers PostgreSQL. | Requêtes, ingestion, structuration. | Dépôt GitHub propre avec README. |
| 60 jours | Déployer une vraie application. | FastAPI, Docker, webhooks, base. | Déploiement, logs, erreurs. | Application lancée en ligne ou démo vidéo. |
| 90 jours | Ajouter IA et préparation entretien. | Assistant IA évalué simplement. | IA appliquée, sécurité, architecture, client. | Portfolio complet avec cas d’usage expliqué. |
Alors, vous commencez par quel vrai projet ?
Devenir Forward Deployed Engineer en 2026, ce n’est pas empiler des buzzwords. C’est apprendre à coder proprement, connecter des API, comprendre les données, déployer une application et tenir la discussion avec un client qui a des contraintes réelles. Python, SQL, PostgreSQL, REST, Docker, cloud, logs, IA appliquée, tout ça doit servir un objectif simple : livrer une solution qui marche et qui s’améliore. Si vous construisez un portfolio autour de vrais problèmes, vous sortez du lot assez vite. Le bénéfice pour vous est clair : vous devenez un profil rare, capable de transformer la technique en impact business.
FAQ
- Qu’est-ce qu’un Forward Deployed Engineer fait au quotidien ?
Il comprend le besoin client, analyse les données et les systèmes existants, développe une solution, la déploie, observe son usage et l’améliore. Le rôle mélange software engineering, intégration de données, déploiement, architecture et conseil technique. - Faut-il être excellent en Python pour devenir FDE ?
Il faut surtout être solide. Vous devez écrire du code clair, gérer les erreurs, structurer un projet, manipuler des données, utiliser Git et debugger sans paniquer. Pas besoin d’être un champion d’algorithmie pure, mais les fondamentaux doivent être propres. - Pourquoi SQL et PostgreSQL sont si importants pour ce métier ?
Parce qu’un FDE travaille presque toujours avec des données réelles. SQL permet de comprendre, nettoyer, joindre et contrôler ces données. PostgreSQL est une base fiable et très utilisée pour construire des applications, des intégrations et des prototypes sérieux. - Docker est-il obligatoire pour un Forward Deployed Engineer ?
Il est quasiment indispensable. Docker aide à faire tourner une application de manière reproductible, sur votre machine comme sur un serveur. Pour un FDE, c’est une compétence clé pour passer d’un prototype local à une solution exploitable. - Comment prouver son niveau quand on débute ?
Le plus simple est de créer des projets complets : une API, une base PostgreSQL, une intégration de données, un déploiement Docker, des logs, une documentation courte. Un recruteur doit voir que vous savez livrer un flux complet, pas seulement écrire une fonction isolée.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des entreprises sur le tracking server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA, le SEO et le GEO. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Mon sujet, c’est simple : relier les données, les outils et les équipes pour produire des systèmes utiles. Si vous voulez structurer ce type de compétences dans votre entreprise, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.