

En testant les réponses avant qu’elles cassent vos automatisations. Un prompt LLM n’est pas une fonction classique, il peut varier, mal formater une réponse ou sembler juste alors qu’il dérape. Je vous montre comment cadrer les tests, choisir les bons outils et utiliser n8n Evaluations proprement.
Pourquoi un prompt se teste autrement ?
Quand je teste un prompt en production, je ne teste pas une fonction classique. Je teste un comportement. Et ça change tout, parce qu’un LLM, un grand modèle de langage, peut recevoir exactement la même entrée et produire une réponse légèrement différente.
Dans un test logiciel classique, j’ai souvent ce réflexe simple : “Si j’entre A, je dois obtenir B”. Avec un prompt, ce réflexe devient trop fragile. Le modèle peut répondre avec une autre formulation, un autre ordre de mots, parfois une nuance différente. La réponse peut être acceptable sans être identique. Et l’inverse est vrai aussi : elle peut avoir l’air propre, bien écrite, rassurante… mais être fausse, incomplète, ou inutilisable par l’étape suivante du workflow.
Le vrai sujet, ce n’est donc pas l’égalité stricte entre une entrée et une sortie. C’est plutôt : Est-ce que la réponse respecte ce qui compte vraiment pour le business ?
- Est-ce que le format attendu est respecté ?
- Est-ce que la bonne catégorie est choisie ?
- Est-ce que le modèle utilise le bon outil dans n8n ?
- Est-ce que la consigne métier est suivie ?
- Est-ce que le cas limite est géré correctement ?
Prenons un workflow n8n qui classe automatiquement des tickets support avec un LLM. Un client écrit : “Je n’arrive plus à me connecter depuis ce matin, ça me bloque pour envoyer mes factures”. Le modèle peut répondre “Problème de connexion” ou “Accès compte”. Les deux formulations peuvent être valides si, derrière, la catégorie normalisée est bien “authentification”, que le ton reste professionnel, et que la sortie respecte la structure attendue, par exemple un JSON avec category, priority et summary.
Agents IA n8n : une formation pratique pour accélerer votre productivité avec le No Code !
Les formations n8n vous ouvrent les portes d’une automatisation intelligente, fluide et évolutive. Vous y apprendrez à construire des workflows sur mesure, à interconnecter vos outils métiers, à transformer vos données, et même à intégrer des agents IA ou des systèmes RAG dans vos scénarios.
Le danger arrive quand je modifie un prompt, que je change de modèle, ou que j’ajoute une étape dans le workflow. Une petite phrase ajoutée peut améliorer un cas et en casser dix autres. C’est ça, la régression. Le workflow marchait hier, il a l’air de marcher aujourd’hui, mais sur certains tickets il commence à classer n’importe comment ou à renvoyer du texte au lieu d’un JSON valide.
Sur les workflows IA que j’ai vus chez des clients, le problème arrive rarement sur le cas parfait de démonstration. Il arrive sur les cas ambigus, les données sales, les demandes trop longues, les messages avec trois sujets mélangés, ou les sorties JSON qui ne sont plus du JSON.
La bonne base, ce n’est pas trois tests faits à la main dans le chat du modèle. C’est un jeu d’exemples représentatif, avec des cas simples, des cas limites, des erreurs attendues, et des sorties qu’on sait vraiment évaluer.
Quels outils choisir pour tester ses prompts ?
Le choix de l’outil dépend moins de “quel est le meilleur outil” que de “où est-ce que mon prompt vit vraiment”. Si votre prompt est dans un repo Git, testé par une équipe dev, il faut un outil code-first. Si votre sujet principal c’est comprendre ce qui se passe en production, il faut de l’observabilité. Si votre automatisation tourne dans n8n, j’aime bien tester directement dans n8n, parce que c’est là que les vrais problèmes apparaissent.
Les frameworks code-first comme Promptfoo et DeepEval sont très utiles quand on veut traiter les prompts comme du code. Promptfoo sert à tester des prompts, comparer des modèles, automatiser des évaluations et lancer tout ça en CI, c’est-à-dire dans une chaîne de validation automatique avant mise en production. DeepEval est plus proche d’une logique de tests unitaires pour applications LLM. Un test unitaire, c’est un petit test ciblé qui vérifie qu’un comportement précis fonctionne toujours. C’est propre, versionnable, rassurant pour une équipe engineering.
Les plateformes d’observabilité comme LangSmith, Braintrust, Langfuse et Arize Phoenix répondent à un autre besoin. Là, on veut tracer les appels LLM, inspecter les entrées et sorties, suivre les coûts, comparer des runs, créer des datasets d’évaluation et voir les régressions dans le temps. Une régression, c’est simple : hier le prompt répondait bien, aujourd’hui il fait n’importe quoi. Langfuse et Phoenix sont souvent appréciés dans l’écosystème open source d’observabilité LLM, surtout quand l’équipe veut garder la main sur sa stack.
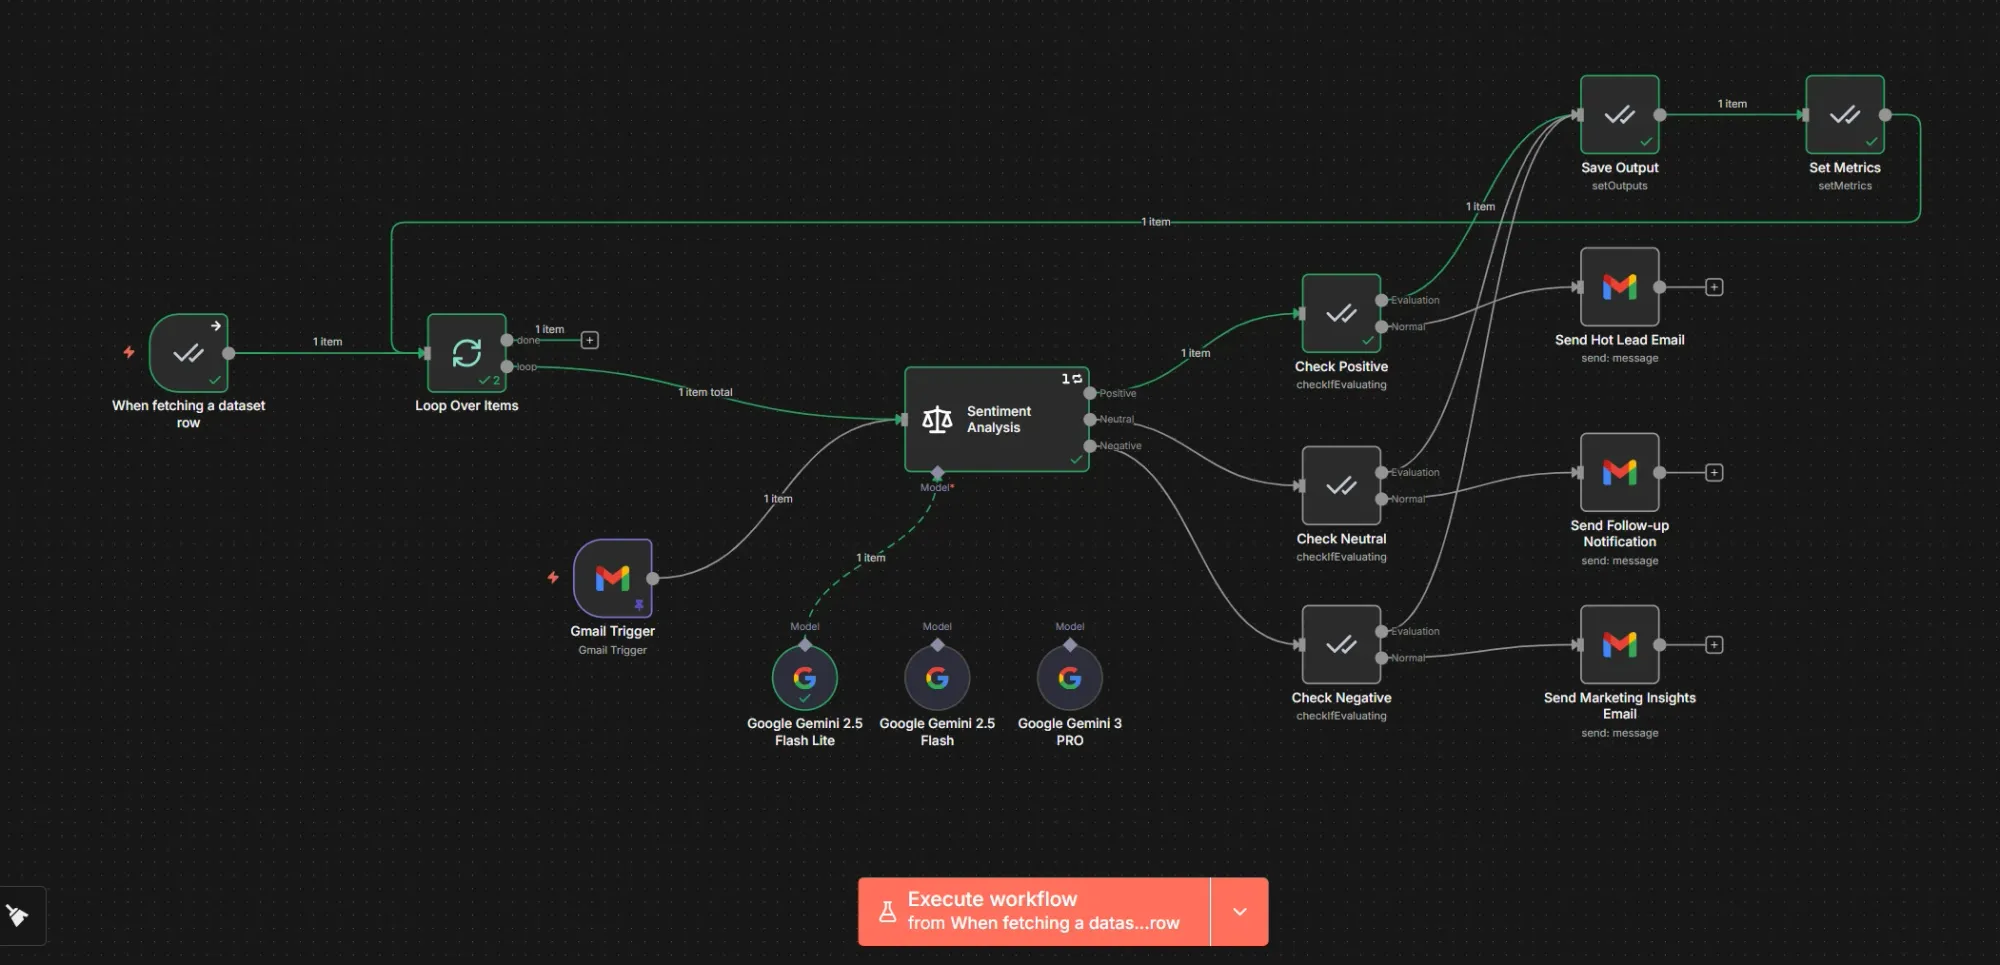
Les solutions intégrées au workflow, comme n8n Evaluations, sont très intéressantes en contexte low-code. Je peux tester là où le workflow tourne vraiment, avec les mêmes nœuds, les mêmes transformations, les mêmes données et les mêmes sorties attendues. Chez un client, c’est souvent là qu’on découvre le bug : pas dans le prompt isolé, mais dans le mapping juste avant, ou dans une condition après.
| Type d’outil | Exemples | Quand l’utiliser | Limite principale |
| Framework code-first et CLI | Promptfoo, DeepEval | Quand l’équipe veut versionner les tests, les lancer en CI et traiter les prompts comme du code. | Moins naturel si l’équipe construit surtout ses automatisations dans n8n. |
| Plateforme d’observabilité | LangSmith, Braintrust, Langfuse, Arize Phoenix | Quand il faut tracer la production, comparer les runs, suivre les coûts et détecter les régressions. | Demande une vraie discipline d’instrumentation et d’analyse. |
| Évaluation intégrée au workflow | n8n Evaluations | Quand les prompts vivent dans n8n et qu’on veut tester le workflow réel, pas une version théorique. | Moins adapté si toute la stack de test est déjà centrée sur du code. |
Mon choix par défaut est simple. Si l’équipe est très engineering, Promptfoo ou DeepEval peuvent être plus naturels. Si l’équipe construit et opère ses automatisations dans n8n, tester dans le canvas évite beaucoup d’allers-retours et colle mieux à la réalité de production.
Quelles métriques utiliser dans n8n ?
Les bonnes métriques sont celles qui vérifient ce que votre workflow doit vraiment garantir. Je vois souvent l’erreur inverse chez des clients. Ils veulent noter la “qualité” d’une réponse IA, alors que le vrai risque en production, c’est un JSON cassé, une mauvaise catégorie, ou un agent qui n’appelle pas le bon outil.
Les métriques déterministes sont les plus simples à poser dans n8n. La réussite est définie à l’avance. Soit c’est bon, soit c’est faux. C’est très rassurant pour les équipes métier parce que c’est rapide, lisible, et difficile à contester.
- Correspondance exacte quand la réponse attendue est stable, par exemple “validé” ou “refusé”.
- Catégorisation quand le LLM doit choisir parmi des classes connues, comme “support”, “facturation”, “commercial”.
- Vérification d’un appel d’outil quand un agent doit déclencher une action précise, par exemple créer un ticket Zendesk plutôt que répondre en texte libre.
Les métriques personnalisées deviennent utiles quand vous devez contrôler un format précis. Une regex, pour expression régulière, sert à détecter un motif dans un texte. Ce n’est pas magique, mais c’est très pratique pour bloquer les erreurs évidentes avant qu’elles partent en production.
Par exemple, j’utilise ce genre de contrôles quand la sortie doit contenir une adresse email, un identifiant métier, ou un champ obligatoire dans un JSON.
# Email simple, utile pour vérifier la présence d'un format basique
^[^s@]+@[^s@]+.[^s@]+$

# Identifiant ticket attendu, comme TICKET-12345
^TICKET-d+$

# Contrôle simple d'un champ obligatoire "status" dans une sortie JSON
"status"s*:s*"[^"]+"
Ces exemples restent pédagogiques. Ils ne valident pas tous les cas possibles, surtout pour les emails ou le JSON complexe. Le but, c’est de détecter vite les sorties clairement mauvaises, pas de remplacer un vrai parseur JSON ou une validation métier complète.
Pour structurer un dataset de test dans n8n, je garde quelque chose de très simple. Une entrée utilisateur, la sortie attendue ou les critères attendus, la métrique utilisée, puis le résultat du test. Ça permet de relire un échec sans devoir deviner ce que le test voulait prouver.
| Besoin | Métrique à utiliser |
| Vérifier un format | Regex |
| Vérifier une catégorie | Score de classification |
| Vérifier un appel d’outil | Test de l’action déclenchée |
| Accepter plusieurs bonnes réponses | LLM-as-a-Judge, c’est-à-dire un autre LLM qui évalue la réponse selon une grille claire |
Quand utiliser LLM as a Judge ?
Quand je teste un prompt en production, j’utilise LLM-as-a-Judge quand la réponse attendue n’a pas une seule bonne forme possible. C’est typiquement le cas d’une réponse de support, d’une synthèse, d’une reformulation, ou d’un message commercial un peu personnalisé.
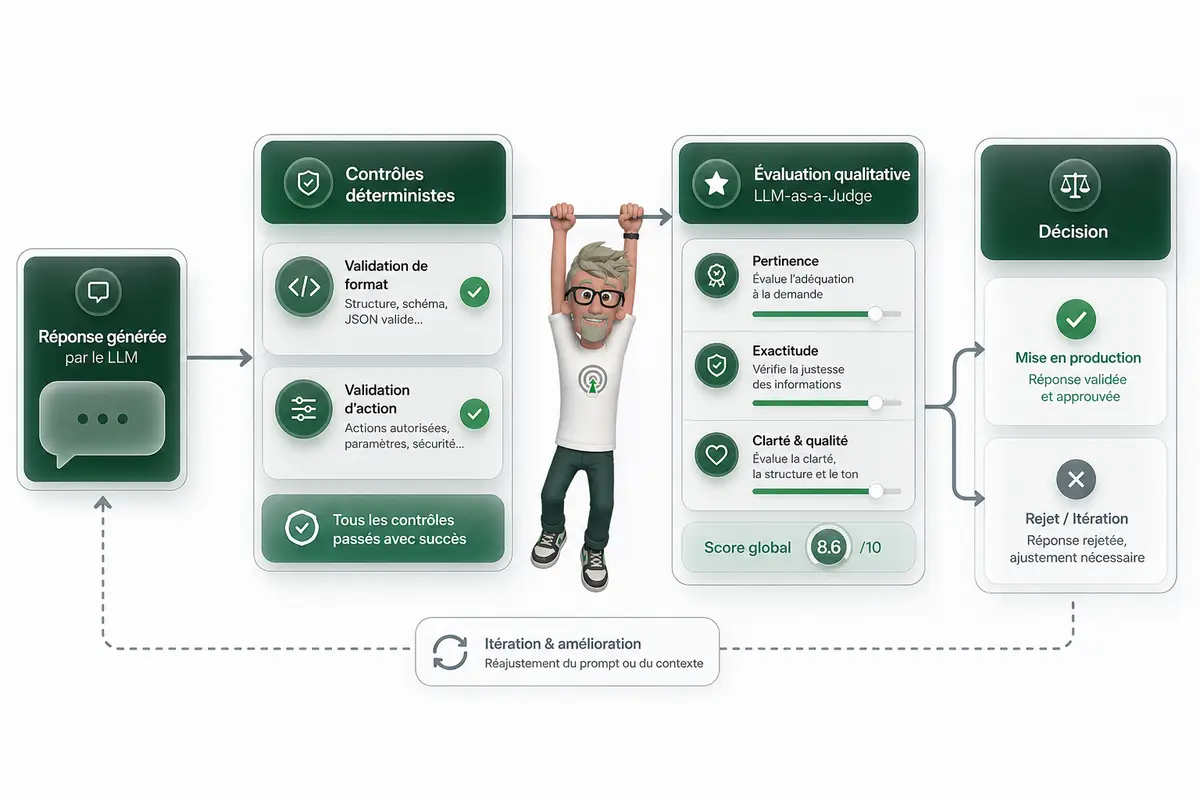
L’idée est simple. Je demande à un autre modèle de juger la réponse générée, avec une grille claire. Le juge ne dit pas juste “j’aime” ou “j’aime pas”. Il vérifie si la réponse est utile, polie, fidèle au contexte, et surtout si elle ne promet pas quelque chose de faux.
Par exemple, dans un workflow n8n de support client, deux réponses peuvent être très différentes et pourtant correctes. Une réponse peut dire “Je comprends votre souci, voici quoi faire”. Une autre peut être plus directe. Si les deux donnent la bonne solution, respectent le ton, et ne promettent pas un remboursement impossible, elles doivent passer.
C’est là que les métriques déterministes montrent leurs limites. Une égalité de chaîne, c’est parfait pour vérifier qu’un champ vaut “premium” ou qu’un JSON contient bien une clé “email”. Mais pour juger une réponse humaine, c’est trop rigide. Le juge LLM peut noter la pertinence, la complétude, le respect du ton, et la présence des éléments attendus.
Le piège, c’est de laisser le juge décider dans le vague. Là, on remplace un flou par un autre flou. Je préfère une grille courte, explicite, presque ennuyeuse.
| Critère | Évaluation demandée au juge |
| Exactitude | Donner une note de 1 à 5. Vérifier que la réponse ne contient pas d’information fausse. |
| Respect du contexte | Décider Pass ou Fail. Vérifier que la réponse utilise uniquement les informations disponibles. |
| Format | Décider Pass ou Fail. Vérifier que la réponse respecte le format attendu. |
| Ton | Donner une note de 1 à 5. Vérifier que la réponse reste polie, claire et adaptée au support client. |
| Action suivante proposée | Décider Pass ou Fail. Vérifier que le client sait quoi faire après avoir lu la réponse. |
Je garde aussi des exemples humains de référence. Ça sert à calibrer le juge. Sur un projet client, on avait un score automatique assez bon, mais en relisant 30 réponses au hasard, on a vu que le modèle validait des réponses trop vagues. Le score aidait, mais il ne disait pas toute la vérité.
Dans n8n, l’intérêt est de combiner les approches dans le même workflow d’évaluation. Des checks déterministes pour les formats, les catégories et les champs obligatoires. Un juge LLM pour les réponses ouvertes. Puis une décision claire avant de modifier un prompt ou de pousser un workflow IA en production.
Vous testez vos prompts avant qu’ils coûtent cher ?
Tester un prompt n8n, ce n’est pas chercher une réponse parfaite à chaque run. C’est vérifier que le workflow reste fiable quand le modèle varie, quand les données changent, quand le prompt évolue. Les métriques déterministes sécurisent les formats, les catégories et les appels d’outils. Les regex aident sur les contraintes précises. LLM-as-a-Judge devient utile dès que plusieurs réponses peuvent être acceptables. Et n8n Evaluations a un vrai intérêt: je teste directement dans l’environnement où l’automatisation tourne. Le bénéfice pour vous est simple: moins de régressions invisibles, moins de surprises en production, plus de confiance dans vos workflows IA.
FAQ
- Pourquoi tester un prompt LLM avant la production ?
Parce qu’un prompt peut régresser sans prévenir. Un petit changement de consigne, de modèle ou de contexte peut produire une réponse mal formatée, une mauvaise catégorie ou une sortie qui semble correcte mais qui casse le workflow derrière.
- n8n Evaluations remplace-t-il Promptfoo ou DeepEval ?
Pas forcément. Promptfoo et DeepEval sont très adaptés aux équipes qui veulent tester côté code ou CLI. n8n Evaluations est surtout intéressant quand vos workflows IA vivent déjà dans n8n et que vous voulez tester dans le même environnement d’exécution.
- Quelle est la métrique la plus simple pour commencer ?
Je commencerais par une métrique déterministe liée au vrai risque du workflow. Si le problème est le format, testez le format. Si le problème est la catégorie, testez la classification. Si le problème est l’appel d’un outil, vérifiez l’action déclenchée.
- Quand faut-il utiliser LLM-as-a-Judge ?
Quand il n’existe pas une seule réponse exacte. C’est utile pour le support client, les synthèses, les reformulations ou les réponses ouvertes. Le juge LLM doit quand même être cadré avec des critères précis, sinon le score devient trop flou.
- Combien d’exemples faut-il pour tester un prompt ?
Il n’y a pas de chiffre magique. Le plus important est d’avoir des exemples représentatifs: cas normaux, cas ambigus, données sales, formats limites, erreurs fréquentes. Quelques bons exemples métier valent mieux qu’un gros dataset artificiel qui ne ressemble pas à votre production.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent industrialiser leurs workflows data et IA sans perdre le contrôle sur la qualité. J’ai travaillé avec des références comme Logis Hôtels, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez fiabiliser vos automatisations IA, vous pouvez me contacter.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.