

Pas toujours. Souvent, le business demande du temps réel alors qu’il veut juste des données plus fraîches, plus souvent. Je vais montrer comment cadrer le vrai besoin, repérer les cas où la latence compte vraiment, et éviter une architecture coûteuse pour gagner trois minutes inutiles.
Que veut dire temps réel pour vous ?
Le temps réel, pour moi, ça veut dire une seule chose au départ : la donnée arrive assez vite pour permettre une décision utile. Pas “instantanément” par principe. Pas “à la milliseconde” parce que ça sonne moderne. Juste assez vite pour votre usage.
Je le vois souvent chez des clients. Une équipe reçoit depuis des années un reporting mensuel, préparé à la main dans Excel, envoyé le 5 du mois suivant. Quand on passe à un chargement automatique toutes les heures, ils disent naturellement “on a enfin du temps réel”. Techniquement, ce n’est pas du vrai temps réel. Mais côté métier, l’écart est énorme. On passe d’une vision historique à une vision presque vivante.
Avant de parler Kafka, streaming, API ou entrepôt cloud, je pose toujours la même question : quand vous dites “maintenant”, vous voulez dire quoi ? Maintenant dans 200 millisecondes ? Dans 5 minutes ? Dans une heure ? Demain matin à 7h ? La réponse change tout. Le coût, l’architecture, la complexité, la supervision, et parfois même la pertinence du projet.
Il y a plusieurs niveaux de fraîcheur, et ils ne servent pas aux mêmes besoins :
- Les données vraiment temps réel arrivent quasiment instantanément, souvent pour réagir à un événement.
- Le quasi temps réel accepte quelques secondes ou minutes de délai.
- Le micro-batch traite les données par petits paquets très fréquents.
- Le batch fréquent recharge toutes les heures, ou plusieurs fois par jour.
- Le batch quotidien met à jour les données une fois par jour, ce qui suffit encore à beaucoup de décisions.
| Expression utilisée | Ce que ça veut parfois dire côté métier | Latence typique | Exemple d’usage |
| Temps réel | Je veux voir ce qui se passe maintenant | Millisecondes à quelques secondes | Détection de fraude pendant un paiement |
| Quasi temps réel | Je peux attendre un peu, mais pas une heure | Quelques secondes à quelques minutes | Suivi de commandes ou alertes opérationnelles |
| Micro-batch | Je veux des mises à jour très régulières | 1 à 15 minutes | Tableau de bord logistique ou production |
| Batch fréquent | Je veux arrêter d’attendre le reporting manuel | 30 minutes à quelques heures | Reporting commercial mis à jour dans la journée |
| Batch quotidien | Je veux une donnée fiable chaque matin | Une fois par jour | Pilotage financier, RH ou stock consolidé |
La vraie question n’est donc pas “Est-ce qu’on peut faire du temps réel ?”. Bien sûr qu’on peut, avec assez de budget et de patience. La vraie question, c’est “Quelle fraîcheur crée vraiment de la valeur ?”. Et là, très souvent, la réponse est beaucoup plus simple que prévu.
Quelle fraîcheur vos décisions exigent-elles ?
La bonne fraîcheur dépend de la décision prise avec les données. Pas de la techno disponible, pas de ce que permet l’outil, pas de l’envie d’avoir “du temps réel” parce que ça sonne mieux en réunion.
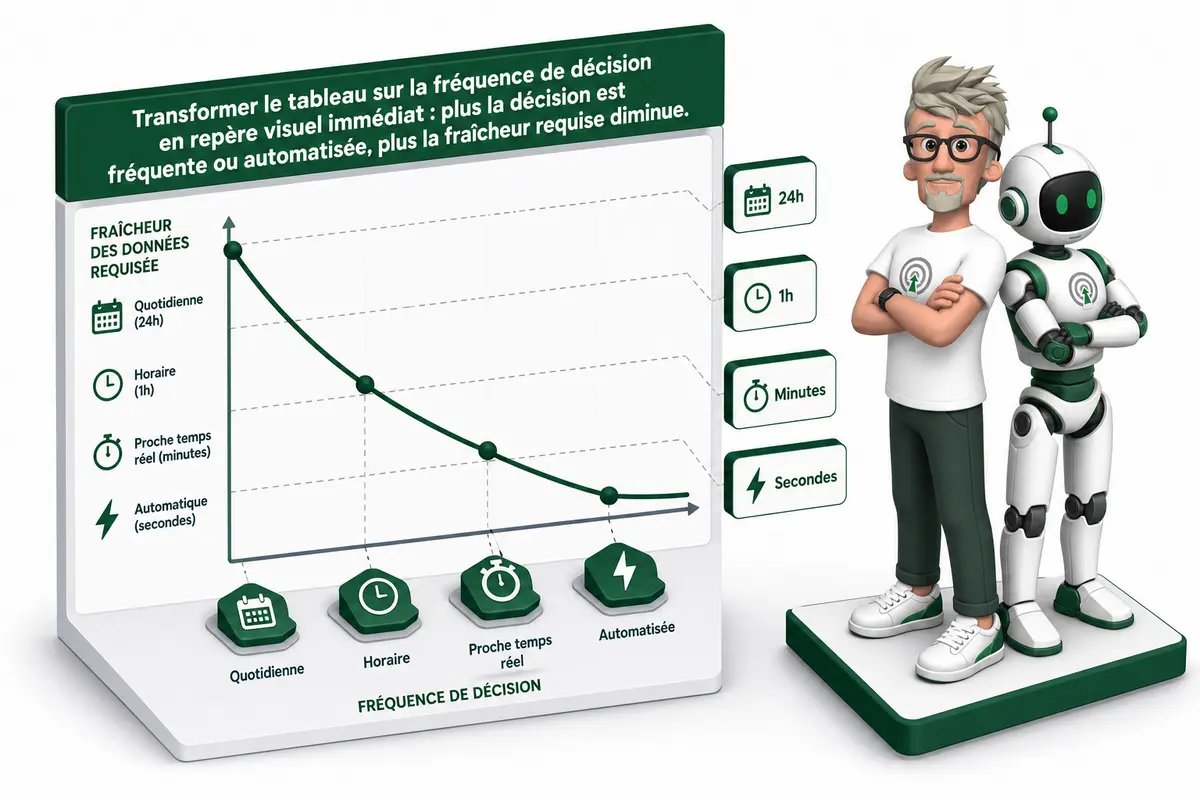
Moi, je pars toujours de la décision. Un dashboard n’a pas besoin d’être frais toutes les minutes si personne ne l’ouvre avant 9h et 17h. J’ai vu ça chez un client : une équipe voulait un rafraîchissement toutes les 5 minutes pour un tableau de suivi commercial. En creusant, les managers le regardaient le matin, puis parfois en fin de journée. On a gardé un rafraîchissement horaire, et personne n’a perdu en qualité de décision.
La vraie question, c’est l’impact business. Que se passe-t-il si la donnée arrive avec une heure de retard ? Est-ce qu’on perd de l’argent ? Est-ce qu’un client attend ? Est-ce qu’une machine continue à produire un défaut ? Ou est-ce que ça change juste la couleur d’un graphique que personne ne regarde vraiment ?
Je pose souvent les mêmes questions en atelier, parce qu’elles remettent les choses au bon endroit :
- Quelle décision est prise grâce à ce tableau de bord ?
- Qui le consulte vraiment, et dans quel contexte ?
- À quelle fréquence cette personne prend-elle une décision ?
- Que se passe-t-il si la donnée a 10 minutes, 1 heure ou 1 jour de retard ?
- Est-ce qu’un humain agit derrière, ou est-ce qu’un système déclenche une action automatiquement ?
- Quel est le coût réel d’une mauvaise décision ou d’une décision trop tardive ?
- Est-ce que la donnée doit être fraîche, ou simplement fiable et complète ?
Le point qui change tout, c’est l’automatisation. Si la donnée déclenche une alerte, bloque une commande, ajuste un prix ou coupe une machine, l’exigence n’est plus la même. Là, on parle de minutes, parfois de secondes. Mais si c’est un humain qui consulte un rapport deux fois par jour, rafraîchir toutes les minutes, c’est souvent payer de la complexité pour rien.
| Fréquence de décision | Fraîcheur recommandée |
| Décision quotidienne | Rafraîchissement une à quelques fois par jour |
| Décision horaire | Rafraîchissement toutes les 15 à 60 minutes |
| Décision toutes les quelques minutes | Rafraîchissement proche temps réel, avec latence courte |
| Décision instantanée ou automatisée | Temps réel ou événementiel, avec exigences claires de latence |
Quand la latence devient-elle critique ?
La latence devient critique quand la décision doit être prise avant que l’événement soit terminé. C’est vraiment le point clé. Si vous pouvez décider après, même quelques minutes après, vous n’avez peut-être pas besoin de temps réel. Si la décision arrive trop tard et ne sert plus à rien, là oui, on parle d’un vrai sujet temps réel.
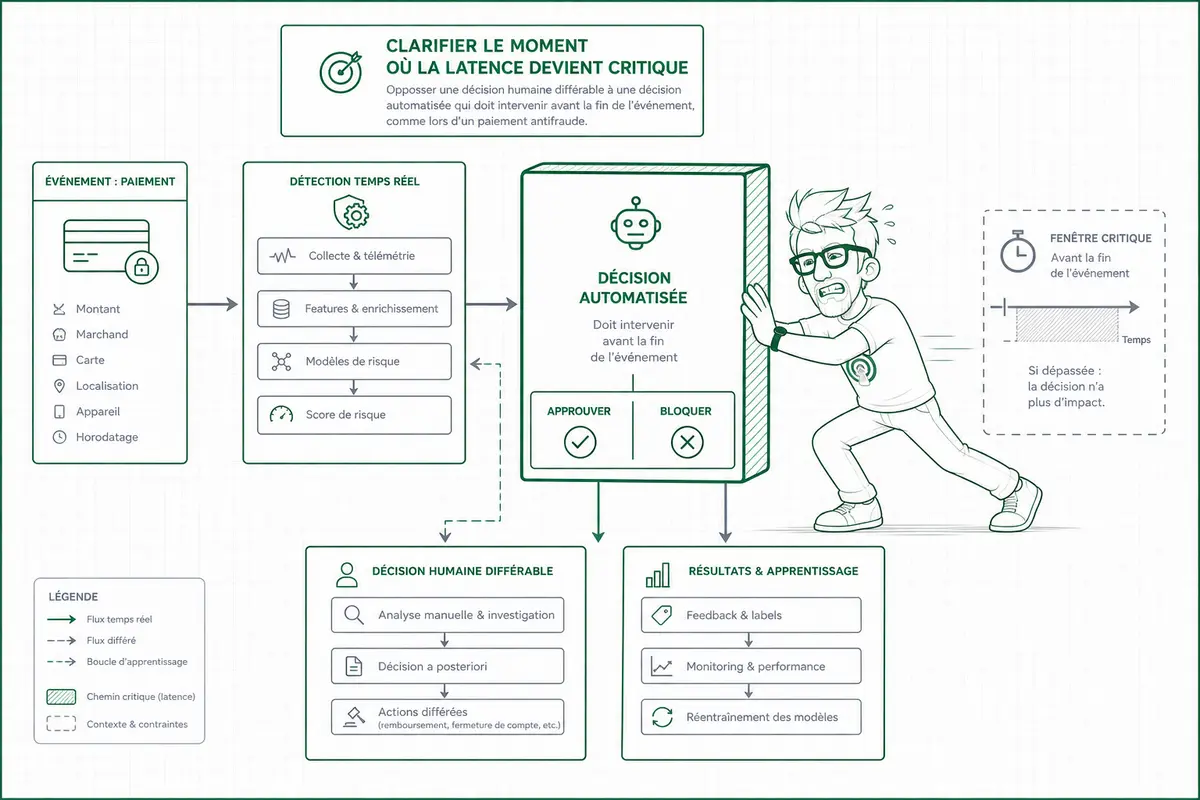
Je prends souvent l’exemple du paiement, parce qu’il est très parlant. Une transaction arrive. Le système doit évaluer le risque de fraude avant de dire oui ou non. Si l’alerte arrive dix minutes plus tard, elle peut aider les équipes fraude à comprendre ce qui s’est passé, à améliorer un modèle, à lancer une enquête. Mais elle ne bloque plus l’opération. L’argent est déjà parti, ou presque.
Dans ce cas, il n’y a pas vraiment d’humain dans la boucle. Personne ne va lire une alerte, analyser le contexte, puis cliquer sur “valider” en deux secondes. Le système doit décider seul, vite, avec un niveau de confiance acceptable. C’est là que les choses deviennent sérieuses, parce que le temps réel n’est pas juste “avoir une donnée fraîche”. C’est une architecture pensée pour tenir la charge, répondre vite, rester disponible, surveiller les erreurs, et parfois accepter de fonctionner en mode dégradé.
| Cas | Latence acceptable | Impact d’un retard |
| Paiement et fraude | Quelques millisecondes à secondes | La décision arrive trop tard pour bloquer |
| Suivi commercial | Quelques minutes à quelques heures | La lecture est moins fraîche, mais reste utile |
| Pilotage marketing | Souvent horaire ou quotidien | L’optimisation attend le prochain cycle |
| Rapport de performance | Quotidien ou hebdomadaire | La décision reste possible après analyse |
J’ai vu des équipes vouloir du streaming partout, alors que leur comité de pilotage regardait les chiffres une fois par jour. Dans ce cas, la fraîcheur est confortable, pas critique. Ça coûte plus cher, ça complexifie les pipelines, et ça ajoute des incidents possibles pour un gain assez faible.
Certains signaux montrent qu’un vrai temps réel est probablement nécessaire :
- La décision doit être prise avant la fin de l’action utilisateur.
- Une réponse tardive n’a plus de valeur opérationnelle.
- Le système agit automatiquement, sans validation humaine.
- Le risque financier, légal ou sécurité augmente à chaque seconde.
- Le volume d’événements impose une décision machine immédiate.
- Une erreur doit être détectée et corrigée avant propagation.
Si aucun de ces signaux n’est présent, je challenge toujours le besoin. Du quasi temps réel, du batch fréquent, ou une mise à jour toutes les quinze minutes peuvent très bien faire le job.
Quel prix pour gagner quelques minutes ?
Les outils modernes ont vraiment simplifié l’ingestion à faible latence. Aujourd’hui, lancer un flux avec Kafka, Pub/Sub, Kinesis, Airbyte, Fivetran ou un orchestrateur cloud, c’est beaucoup plus accessible qu’avant. Mais la complexité ne disparaît pas. Elle se déplace.
Il faut orchestrer les traitements, surveiller les jobs, gérer les reprises sur erreur, contrôler la qualité des données, payer l’infrastructure, former l’équipe. Et ça, personne ne le voit dans la démo commerciale. Je l’ai vu chez un client qui voulait passer d’un pipeline quotidien à un pipeline toutes les minutes. Sur le papier, c’était simple. Dans la vraie vie, on a surtout multiplié les alertes, les logs, les cas limites, et les discussions du lundi matin.
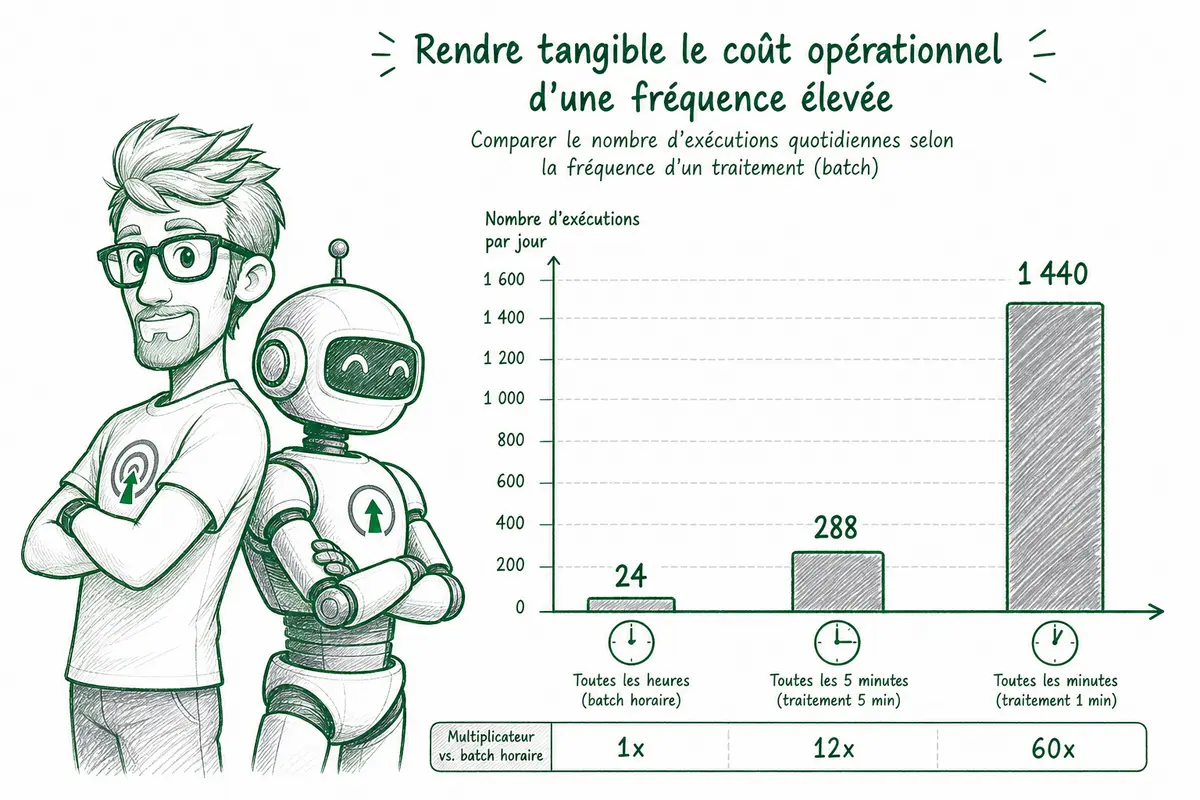
Un pipeline horaire, toutes les cinq minutes ou toutes les minutes, ce n’est pas juste un réglage dans une interface. C’est un changement de charge complet.
- Un traitement horaire fait 24 exécutions par jour.
- Un traitement toutes les cinq minutes fait 288 exécutions par jour.
- Un traitement toutes les minutes fait 1 440 exécutions par jour.
Plus on augmente la fréquence, plus on augmente les points de panne. Plus on génère de logs. Plus on doit monitorer finement. Plus les coûts cloud montent, parfois discrètement. Et plus on crée de dette technique si l’équipe n’a pas le temps de stabiliser proprement.
| Approche | Latence attendue | Complexité | Coût | Quand je la recommande |
| Batch | Quelques heures à une journée | Faible à moyenne | Bas | Quand la décision peut attendre, comme le reporting, la finance, l’analyse commerciale. |
| Micro-batch | Quelques minutes à une heure | Moyenne | Moyen | Quand il faut réagir vite, sans avoir besoin d’un vrai flux continu. |
| Streaming | Quelques secondes | Élevée | Élevé | Quand chaque seconde compte vraiment, comme la fraude, l’IoT critique ou la personnalisation instantanée. |
Parfois, le temps réel est totalement justifié. Si une fraude bancaire doit être bloquée avant validation, personne ne va attendre le batch de 18h. Si une machine industrielle chauffe trop, quelques minutes peuvent coûter cher.
Mais parfois, c’est juste une façon très chère de rassurer tout le monde. On dit “temps réel” parce que ça sonne sérieux, alors que la décision métier se prend le lendemain en comité.
La meilleure architecture, ce n’est pas celle qui coche le mot temps réel. C’est celle qui colle à la décision réelle, au bon niveau de fraîcheur, avec un coût que l’équipe peut tenir dans la durée.
Alors on le branche en temps réel ou pas ?
Le vrai sujet, ce n’est pas d’avoir des données temps réel. C’est d’avoir des données assez fraîches pour prendre la bonne décision au bon moment. Si un humain consulte un dashboard deux fois par jour, le streaming à la minute peut être inutile. Si une transaction doit être validée ou refusée en direct, là oui, la latence devient stratégique. Mon conseil est simple : je pars toujours du besoin métier, de la décision, du délai acceptable, puis seulement après je choisis l’architecture. Vous évitez de payer trop cher, vous réduisez la complexité, et vous gardez une data vraiment utile pour votre business.
FAQ
- Qu’est-ce qu’une donnée temps réel ?
Une donnée temps réel est disponible presque immédiatement après l’événement qui l’a générée. Mais dans les échanges business, le terme est souvent utilisé de façon plus large. Il peut vouloir dire toutes les minutes, toutes les heures, ou simplement plus souvent qu’avant. - Quelle est la différence entre temps réel et batch ?
Le batch traite les données par lots, à une fréquence définie, par exemple toutes les heures ou chaque nuit. Le temps réel traite les événements au fil de l’eau, avec une latence très faible. Entre les deux, on trouve souvent le micro-batch, qui rafraîchit les données très fréquemment sans construire une architecture streaming complète. - Quand le temps réel est-il vraiment nécessaire ?
Il devient nécessaire quand la décision doit être prise immédiatement, avant que l’action soit terminée. Un bon exemple, c’est la détection de fraude pendant un paiement. Si l’analyse arrive après validation de la transaction, elle peut informer, mais elle ne peut plus empêcher l’opération. - Pourquoi le temps réel coûte plus cher ?
Parce qu’il demande souvent plus d’infrastructure, plus de surveillance, plus de reprise sur erreur et plus de rigueur sur la qualité des données. Même avec des outils modernes, un pipeline qui tourne toutes les minutes crée plus de charge et de complexité qu’un pipeline horaire ou quotidien. - Comment choisir la bonne fréquence de rafraîchissement ?
Je pars de la décision à prendre. Qui utilise la donnée, à quelle fréquence, avec quel délai acceptable, et que se passe-t-il si elle arrive trop tard. Si personne n’agit dans les cinq minutes, un rafraîchissement toutes les cinq minutes n’a souvent aucun intérêt business.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes sur leurs architectures data, leurs plans de tracking et leurs automatisations métier, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer un besoin data, automatiser vos flux ou éviter une usine à gaz temps réel inutile, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.