

Un agent qui lit des factures fournisseurs, choisit le compte comptable et pousse l’écriture dans l’ERP. La démo tourne. Trois semaines plus tard, la facture d’API dépasse le budget du service et la comptable relit une ligne sur deux. J’ai vu ce scénario deux fois cette année. Dans les deux cas, le problème n’était pas le modèle : c’était d’avoir laissé le modèle conduire le flux.
Il existe une autre façon de brancher un LLM : un workflow déterministe qui orchestre les étapes, et l’IA appelée uniquement là où elle apporte ce qu’aucune règle ne sait produire. Moins d’appels, moins de tokens, moins d’énergie, un journal lisible et une surface RGPD réduite. Voici cette différence, chiffrée.
- 1. Pourquoi un agent autonome coûte-t-il plus cher qu’il ne rapporte ?
- 2. Où l’IA est-elle vraiment irremplaçable ?
- 3. Combien coûte la même tâche dans un workflow n8n ?
- 4. Pourquoi l’IA généraliste consomme-t-elle autant d’énergie ?
- 5. Que change le RGPD quand l’IA ne voit que ce qu’elle doit voir ?
- 6. Comment n8n garde-t-il le contrôle sans se priver d’IA ?
Pourquoi un agent autonome coûte-t-il plus cher qu’il ne rapporte ?
Parce qu’on paie chaque étape du raisonnement, y compris celles qui ne mènent à rien. Un agent ne suit pas un chemin connu : il essaie, échoue, recommence. Ce rendement s’écroule quand la tâche s’allonge.
L’agent qui cherche consomme 27 appels de modèle par tâche
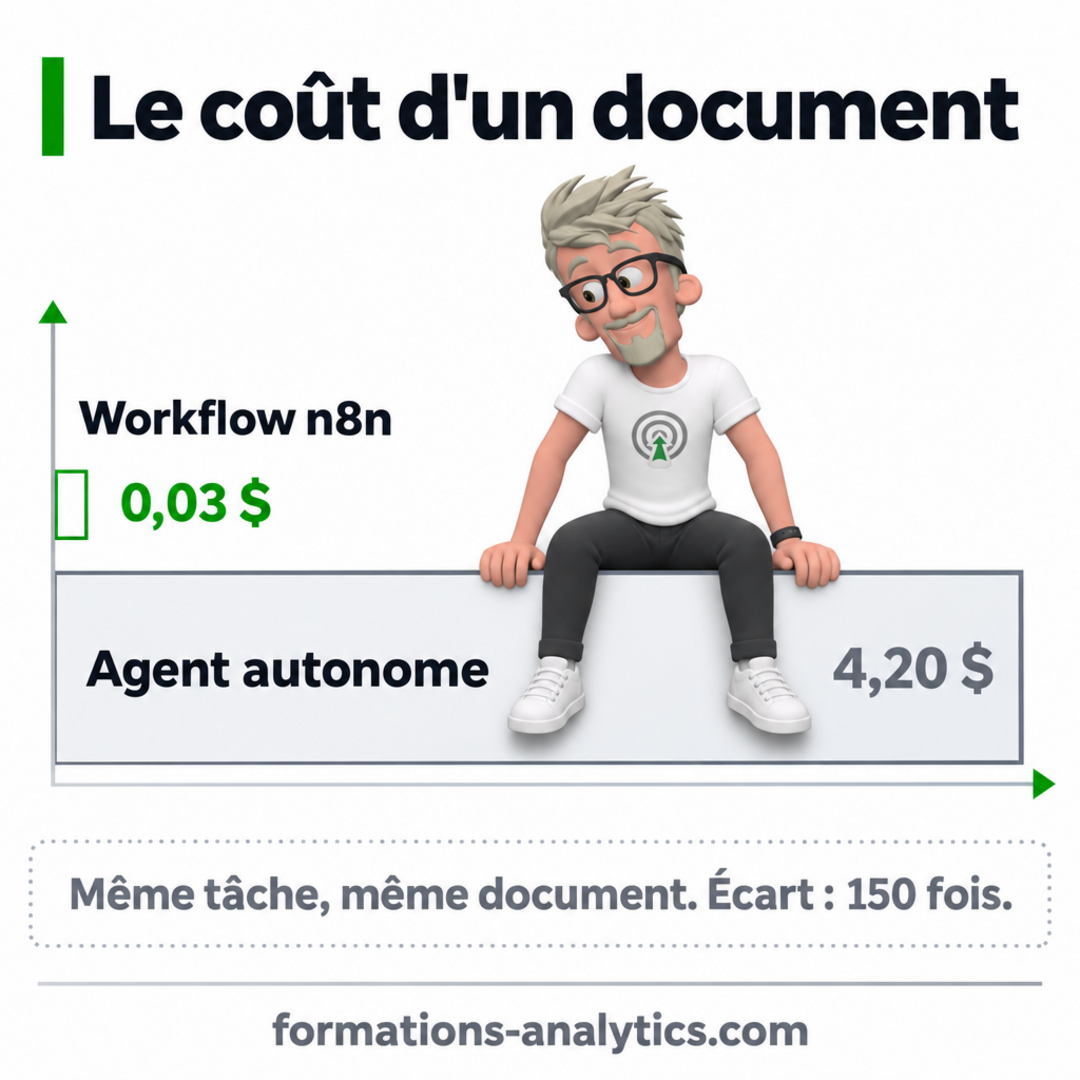
Le benchmark TheAgentCompany, présenté à NeurIPS en 2025 par des chercheurs de Carnegie Mellon, mesure exactement cela. Cent soixante-quinze tâches professionnelles réalistes dans une entreprise logicielle simulée : lire un ticket, mettre à jour un CRM, produire un rapport. Le meilleur agent, propulsé par Gemini 2.5 Pro, en réussit 30,3 % au prix de 27,2 étapes et 4,20 $ par tâche. Claude 3.5 Sonnet plafonne à 24 % pour 29,2 étapes et 6,30 $.
Les deux chiffres viennent du même tableau : 4,20 $ pour 30,3 % de réussite, soit 13,86 $ par tâche aboutie. Le coût réel d’un agent n’est pas son coût par tentative, c’est son coût par résultat.
Agents IA n8n : une formation pratique pour accélerer votre productivité avec le No Code !
Les formations n8n vous ouvrent les portes d’une automatisation intelligente, fluide et évolutive. Vous y apprendrez à construire des workflows sur mesure, à interconnecter vos outils métiers, à transformer vos données, et même à intégrer des agents IA ou des systèmes RAG dans vos scénarios.
Le rapport du MIT NANDA (juillet 2025) va dans le même sens, avec une réserve méthodologique qu’il faut citer au passage : 52 entretiens, 153 répondants, des chiffres que les auteurs qualifient eux-mêmes de « directionnellement exacts ». La direction reste utile : ce n’est pas la qualité du modèle qui bloque, c’est l’absence d’insertion dans un processus réel.
Un échec d’agent ne coûte jamais zéro
Un workflow qui casse s’arrête. Un agent qui se trompe continue : il écrit au mauvais compte, envoie un mail à la mauvaise personne, écrase une ligne de base. La reprise humaine n’est pas facturée par l’API, elle sort du budget du service qui la subit.
Gartner a chiffré la conséquence en juin 2025 : plus de 40 % des projets d’IA agentique seront abandonnés d’ici fin 2027, pour coûts dérapants, valeur floue ou contrôles insuffisants. La note estime à environ 130 le nombre de fournisseurs réellement agentiques sur les milliers qui revendiquent le label, et décrit un « agent washing » : du RPA et des chatbots rebaptisés. Anushree Verma, analyste chez Gartner, y écrit la phrase qui devrait servir de filtre à tout comité : « beaucoup de cas d’usage présentés comme agentiques aujourd’hui ne nécessitent pas d’implémentation agentique ».
Où l’IA est-elle vraiment irremplaçable ?
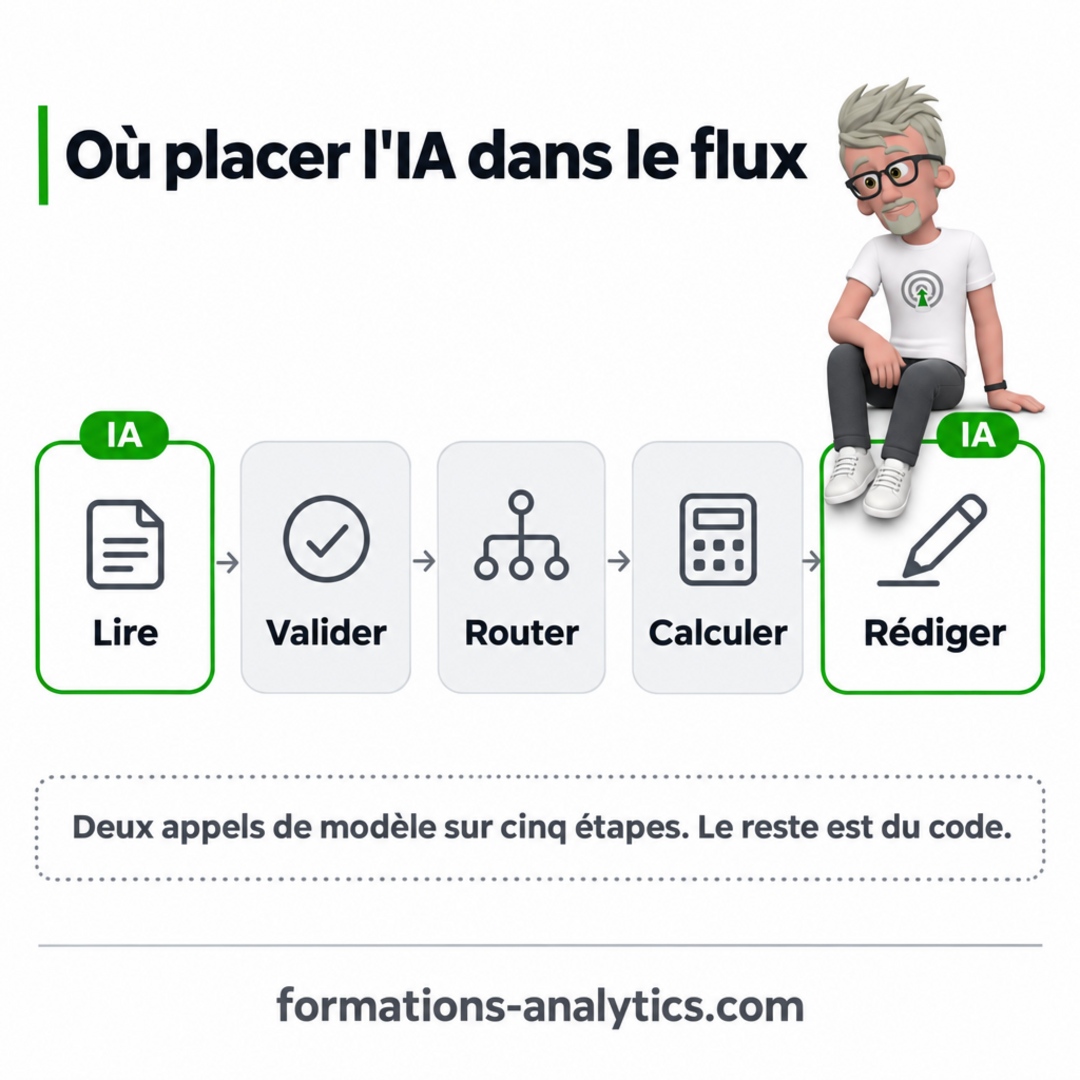
Sur trois maillons seulement : une entrée non structurée à comprendre, une décision de jugement qu’aucune règle ne tranche, une sortie à rédiger. Partout ailleurs, une règle ou une requête fait le travail mieux, gratuitement.
| Maillon du flux | Ce qu’on y met | Ce qu’on n’y met pas |
|---|---|---|
| Lire un PDF de facture scannée | Extraction IA vers un schéma JSON | Le calcul de TVA, la validation du SIRET |
| Classer une demande client | IA sur la phrase libre | Le routage, qui suit une table de correspondance |
| Rédiger la réponse | IA sur la sortie | L’envoi, la signature, la pièce jointe contractuelle |
| Détecter une anomalie | Seuil, règle métier, test statistique | Un modèle génératif qui « sent » le problème |
| Décider de l’escalade | Condition explicite sur des champs extraits | L’appréciation libre du modèle |
D’où une règle de conception : le graphe s’écrit avant l’appel au modèle. On ne demande pas à l’IA ce qu’elle veut faire ensuite, on lui donne un travail borné, une entrée définie, une sortie validée par un schéma. C’est ce qui distingue un pipeline ETL n8n fiabilisé d’un prototype.
Combien coûte la même tâche dans un workflow n8n ?
Deux appels suffisent le plus souvent : un pour comprendre l’entrée, un pour rédiger la sortie. Le raisonnement intermédiaire reste dans le graphe, où il ne coûte rien.
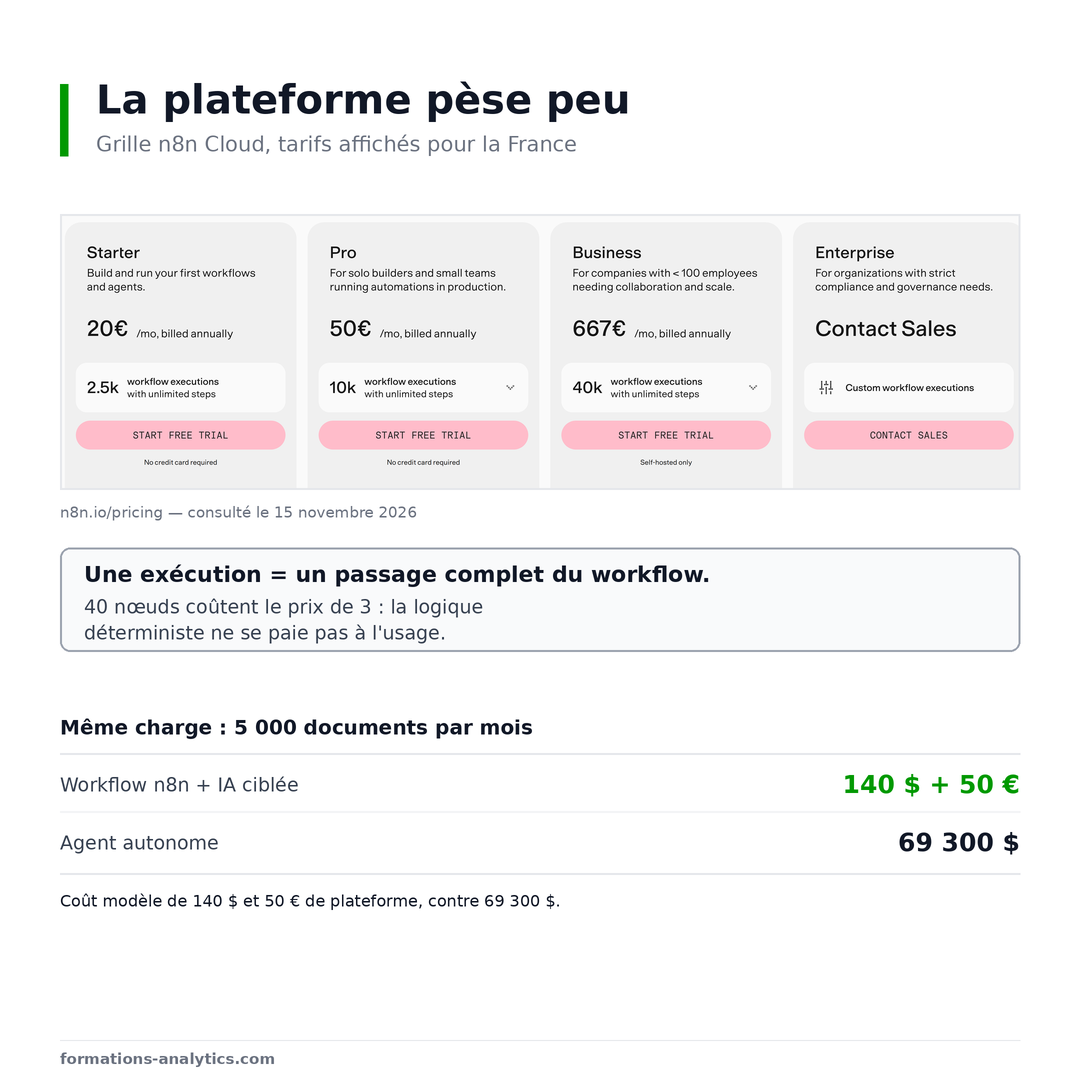
Prenons une facture fournisseur : extraction des champs, puis rédaction d’un commentaire de validation. Deux appels, 3 000 tokens d’entrée et 800 de sortie chacun. Aux tarifs publics relevés le 15 novembre 2026, Claude Sonnet 5.5 facture 2 $ le million de tokens d’entrée et 10 $ le million de sortie : 0,028 $ pour la paire. Avec un modèle économique comme Haiku 5.5 ou GPT-6 Luna (0,10 $ / 0,50 $), la paire tombe à 0,0014 $.
Le tableau ramène les deux architectures à 5 000 documents par mois. Les 4,20 $ et les 30,3 % sont mesurés ; les 0,028 $ sont calculés, en supposant un succès du premier coup : même avec une reprise humaine sur 2 % des documents, l’écart reste de deux ordres de grandeur.
| Poste | Agent autonome | Workflow n8n, IA ciblée |
|---|---|---|
| Appels de modèle par tâche | 27,2 (mesuré) | 2 (conçu) |
| Coût modèle par tentative | 4,20 $ (mesuré) | 0,028 $ (calculé) |
| Coût modèle par résultat | 13,86 $ | 0,028 $ |
| Tentatives pour 5 000 résultats | 16 500 | 5 000 |
| Coût modèle mensuel | 69 300 $ | 140 $ |
Le poste plateforme ne renverse rien : n8n Cloud démarre à 20 € par mois pour 2 500 exécutions (tarif affiché pour la France), la Community Edition auto-hébergée est gratuite sous licence Sustainable Use. À 5 000 documents, on reste dans le plan Pro à 50 €.
Un aparté terrain. Sur un flux de qualification de leads, un client avait empilé un agent à quatre outils. Le score variait d’un jour à l’autre pour le même lead. Remplacé par un graphe — enrichissement, règles de score explicites, un seul appel LLM pour l’argumentaire —, le taux de leads correctement priorisés est passé de 71 % à 89 % et la facture modèle a été divisée par onze.
Pourquoi l’IA généraliste consomme-t-elle autant d’énergie ?
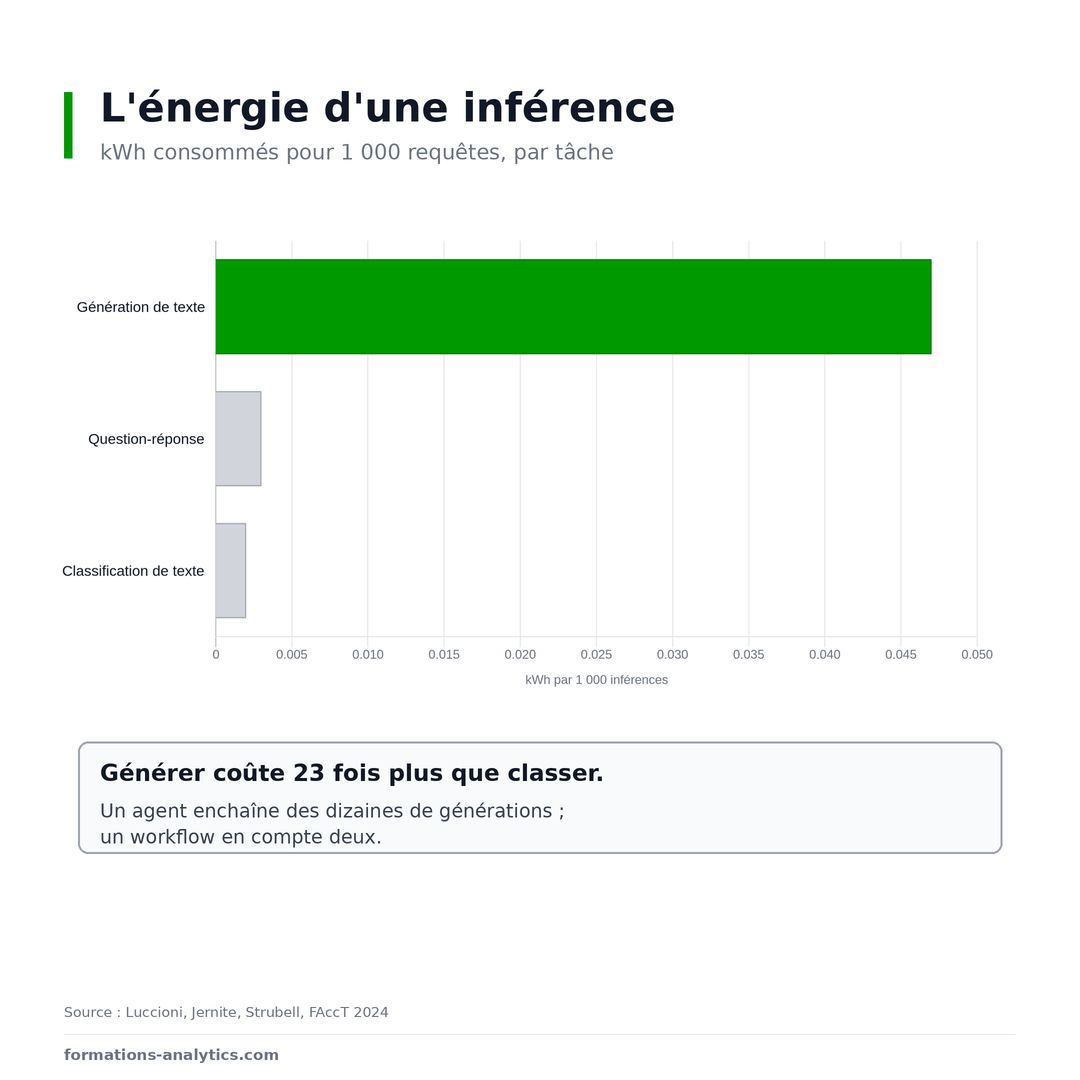
Parce que générer du texte est la tâche d’inférence la plus énergivore après la génération d’image, et qu’un agent en enchaîne des dizaines là où un workflow en compte deux. La variable décisive n’est pas la taille du modèle, c’est le nombre d’inférences et leur nature.
1 000 classifications coûtent 0,002 kWh, 1 000 générations 0,047 kWh
L’étude de référence, menée par Alexandra Sasha Luccioni, Yacine Jernite et Emma Strubell et publiée à FAccT 2024, mesure l’énergie d’inférence de 88 modèles sur 10 tâches. Pour 1 000 requêtes : 0,002 kWh en classification de texte, 0,003 kWh en question-réponse extractive, 0,047 kWh en génération de texte, 2,907 kWh en génération d’image. Entre la tâche la moins et la plus coûteuse, le facteur dépasse 1 450.
À taille comparable, l’écart entre modèle spécialisé et généraliste se compte en ordres de grandeur sur la classification et la question-réponse. Sur le résumé, il est plus modeste mais réel : 4 à 10 g de CO₂eq pour 1 000 inférences avec un modèle spécialisé, 20 à 30 g avec un généraliste. Appeler un LLM pour classer un email en « réclamation » ou « information » coûte environ vingt-trois fois l’énergie d’un classifieur dédié, pour un raisonnement dont personne n’a besoin.
Chaque tour d’agent est en outre une inférence de génération, et l’historique renvoyé à chaque tour fait grossir l’entrée : le coût ne croît pas linéairement avec la longueur de la tâche, mais plus vite.
À l’échelle des datacenters, la marge de manœuvre est réelle
L’Agence internationale de l’énergie chiffre dans Energy and AI (avril 2025) la consommation des datacenters à 415 TWh en 2024, soit 1,5 % de l’électricité mondiale, avec une projection à 945 TWh en 2030. Un datacenter dédié à l’IA consomme autant qu’une ville de 100 000 foyers. Aucune entreprise ne décide de ce total, mais chacune décide de sa part : le nombre d’inférences déclenchées pour un résultat est le seul levier qu’elle contrôle vraiment.
Que change le RGPD quand l’IA ne voit que ce qu’elle doit voir ?
La minimisation cesse d’être une promesse de prompt pour devenir une propriété du graphe. Dans un workflow, on sait quelle donnée entre dans le modèle, parce que c’est le nœud précédent qui la construit. Dans un agent, on sait seulement ce à quoi on lui a donné accès.
Un agent qui explore collecte plus que nécessaire
L’article 5.1.c du RGPD impose des données adéquates, pertinentes et limitées à ce qui est nécessaire. Un agent qui dispose d’un accès CRM, d’une boîte mail et d’un dossier partagé peut, pour répondre à une question simple, lire des données qui n’avaient rien à faire dans ce traitement. La CNIL, dans ses recommandations sur le développement des systèmes d’IA et sa liste de vérification de juillet 2025, place la finalité et la minimisation au premier rang des points à contrôler, avec la sécurité et la gouvernance.
Un graphe se défend plus facilement : la finalité est lisible dans l’enchaînement des nœuds, le périmètre est celui des champs extraits, et l’analyse d’impact décrit un flux plutôt qu’un comportement émergent.
Le journal d’exécution existe déjà et il est lisible
n8n conserve, pour chaque exécution, l’entrée et la sortie de chaque nœud. On répond donc à la question d’un DPO — quelles données personnelles ont été transmises à quel fournisseur, et quand — sans instrumentation supplémentaire. Avec un agent, il faut reconstituer une trajectoire à partir de transcripts.
Une entreprise qui utilise un LLM est déployeur au sens de l’article 3(4) : elle doit assurer la maîtrise de l’IA (article 4) et, pour les systèmes concernés, la transparence (article 50), applicable depuis le 2 août 2026. Le calendrier officiel de la Commission repousse les règles de l’annexe III au 2 décembre 2027 et celles de l’annexe I au 2 août 2028, à la suite du paquet Digital Omnibus.
Trois questions suffisent à cadrer un flux avant de le construire : quelle donnée personnelle franchit la frontière du modèle, et pour quelle finalité ? Où est hébergé le fournisseur, et quel transfert cela implique-t-il ? Qui peut relire ce qui a été envoyé, et pendant combien de temps le journal est-il conservé ? Dans un workflow, ces réponses tiennent en une page et se vérifient dans le graphe.
Comment n8n garde-t-il le contrôle sans se priver d’IA ?
En mettant le modèle dans une boîte dont les entrées, les sorties et les droits sont fixés par le graphe. Trois mécanismes rendent cette boîte tenable en production.
Une sortie structurée, pas une réponse libre
Le nœud AI Agent accepte une contrainte de schéma JSON : le modèle remplit des champs, il ne choisit pas le format. Les nœuds suivants reçoivent des données prévisibles et deviennent testables. C’est le prolongement de ce que j’explique sur les tests de prompts n8n en production : sans schéma de sortie, il n’y a rien à tester.
Une validation humaine sur les outils sensibles
n8n permet de marquer un outil comme sensible : l’agent s’arrête et attend une approbation avant de l’exécuter. Sur un envoi de mail, une écriture comptable ou une suppression, ce point d’arrêt suffit à rendre l’automatisation acceptable pour un métier. Le nœud Guardrails complète le dispositif en filtrant les contenus problématiques et en retirant les données personnelles avant qu’elles n’atteignent le modèle.
Les limites à connaître avant de standardiser
Trois. La fonction Agents est encore en Preview, et le queue mode — qui répartit la charge sur plusieurs workers — n’est pas pris en charge pour les agents : on passe un workflow à l’échelle, pas encore un agent. n8n est ensuite en fair-code, pas en open source au sens OSI : la licence Sustainable Use autorise l’usage interne, pas l’hébergement comme service pour des tiers. Enfin, l’auto-hébergement gratuit transfère mises à jour, base et sécurité à votre équipe ; les changements de n8n 3.0 rendent ce suivi nécessaire.
Une exécution n8n reste un passage complet du workflow : un flux de 40 nœuds coûte le prix d’un flux de 3. Pour situer les trois niveaux de délégation, le fonctionnement d’un agent IA vaut une lecture.
Le tableau suivant réunit les quatre dimensions sur lesquelles l’architecture se joue. Aucun chiffre nouveau : tout est démontré plus haut.
| Critère | Agent autonome | Workflow n8n, IA ciblée |
|---|---|---|
| Coût modèle par document | 4,20 $ (mesuré) | 0,028 $ (calculé) |
| Coût par résultat obtenu | 13,86 $ | 0,028 $ |
| Appels de modèle | 27,2 par tâche | 2 par document |
| Journal d’exécution | Trajectoire à reconstituer | Entrée et sortie par nœud |
| Données vues par le modèle | Tout ce à quoi il a accès | Les seuls champs extraits |
| Passage à l’échelle | Queue mode non supporté | Workers standards |
Alors, faut-il encore des agents ?
Oui, mais pas là où vous les mettez. Un agent reste le bon outil pour explorer un espace mal défini : une recherche, un diagnostic, un prototypage. Dès que le chemin est connu — dans un processus métier, il l’est presque toujours — le graphe est plus rapide, moins cher et plus facile à défendre devant un auditeur.
La question à poser avant d’ouvrir un projet n’est donc pas « quel agent construire », mais « quels maillons exigent un jugement ». Il y en a deux ou trois. Le reste est du code : il se teste, se versionne et se facture.
Si vous voulez passer vos flux en revue avec cette grille — coût par résultat, nombre d’inférences, périmètre de données — prenons une heure pour le faire.
Questions fréquentes
-
Un agent IA peut-il remplacer un workflow n8n ?
Sur des tâches ouvertes, oui. Sur un processus dont les étapes sont connues, non : l’agent ajoute coût et variabilité sans capacité supplémentaire. TheAgentCompany mesure 30,3 % de réussite pour le meilleur agent, à 4,20 $ la tentative. -
Combien coûte un workflow n8n avec IA par rapport à un agent ?
Environ 0,028 $ par facture avec Claude Sonnet 5.5 aux tarifs de novembre 2026, contre 4,20 $ par tentative d’agent, soit 13,86 $ par résultat. -
L’IA ciblée dans n8n est-elle vraiment plus écologique ?
Oui, à résultat comparable : 0,002 kWh pour 1 000 classifications contre 0,047 kWh pour 1 000 générations, et un agent enchaîne des générations là où un workflow en compte deux. -
Un workflow n8n est-il plus conforme au RGPD qu’un agent ?
Il est plus facile à documenter : minimisation et finalité se lisent dans l’enchaînement des nœuds, et le journal garde l’entrée et la sortie de chaque étape. -
Peut-on garder un agent pour certaines étapes seulement ?
Configuration recommandée : le nœud AI Agent s’insère dans un workflow comme un autre nœud, sur le seul maillon qui demande un jugement.
Sources
- Xu, F. F., Song, Y., Li, B. et al. (2025). TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks. NeurIPS 2025, Datasets and Benchmarks Track. arxiv.org/abs/2412.14161
- Luccioni, A. S., Jernite, Y., Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment? ACM FAccT ’24. arxiv.org/abs/2311.16863
- Agence internationale de l’énergie (2025). Energy and AI. iea.org
- Gartner (25 juin 2025). Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. gartner.com
- MIT NANDA, Challapally, A. et al. (juillet 2025). The GenAI Divide: State of AI in Business 2025. Échantillon restreint, résultats qualifiés de directionnels par les auteurs.
- CNIL (juillet 2025). Développement des systèmes d’IA : que faut-il vérifier ? cnil.fr
- Commission européenne. Calendrier de mise en œuvre de la législation de l’UE sur l’IA, consulté le 15 novembre 2026. ai-act-service-desk.ec.europa.eu
- n8n. Build and manage agents et Plans and pricing, consultés le 15 novembre 2026. docs.n8n.io · n8n.io/pricing
- Anthropic et OpenAI. Grilles tarifaires API, consultées le 15 novembre 2026. claude.com/pricing · openai.com
- Règlement (UE) 2016/679 (RGPD), articles 5, 25 et 35. eur-lex.europa.eu
Franck Scandolera forme et accompagne les équipes data sur l’orchestration de workflows et l’intégration ciblée de l’IA générative : conception de flux n8n, évaluation de coûts, cadrage RGPD des traitements.

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
Data Engineering : BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
Automatisation IA : n8n, Apps Script, scraping, API, LLM
Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals