

Je crée un portfolio data science crédible en montrant tout le chemin, pas juste un notebook propre. Problème business, SQL, nettoyage, features, modèles, API, dashboard. C’est ça qui rassure un recruteur, parce qu’il voit comment je travaille quand les données sont imparfaites.
Quel problème business résoudre ?
Je pars d’un vrai problème business, pas d’un algorithme à placer. C’est la base d’un portfolio data science crédible, parce qu’en entreprise personne ne se réveille en disant “tiens, on va faire un Random Forest aujourd’hui”. On part d’une décision à prendre.
Par exemple, prédire une durée de livraison pour mieux informer un client. Ou anticiper un retard pour prévenir le support avant que le client râle. Ou optimiser les opérations pour affecter les bonnes ressources au bon moment. Là, le modèle sert à quelque chose. Il aide quelqu’un à décider plus vite, mieux, ou avec moins de flou.
J’ai vu trop de portfolios avec trois modèles comparés sur un CSV sans expliquer à quoi ça sert, et ça ne raconte presque rien sur la capacité à travailler en entreprise. Oui, les métriques sont propres. Oui, le notebook tourne. Mais on ne sait pas qui utilise la prédiction, à quel moment, ni ce que ça change si le modèle se trompe.
Le bon cadrage change tout. Le recruteur comprend le contexte, la cible à prédire, l’impact attendu, et surtout votre manière de transformer une question terrain en problème de machine learning. Le machine learning, c’est simplement le fait d’entraîner un modèle à apprendre des régularités dans des données passées pour prédire ou classer de nouveaux cas. Ce n’est pas magique. C’est utile seulement si la question est bien posée.
Avant de coder, je cadre toujours ces éléments :
- Objectif business : ce qu’on veut améliorer concrètement.
- Variable cible : ce que le modèle doit prédire.
- Unité de prédiction : une livraison, une commande, un trajet.
- Moment de prédiction : avant la prise en charge, pendant la préparation, au dispatch.
- Métrique utile : erreur moyenne en minutes, écart acceptable, impact opérationnel.
Ce cadrage évite le projet gadget. Il force à expliquer pourquoi les données existent, pourquoi la prédiction a de la valeur, et comment le résultat pourrait être utilisé dans un vrai flux de travail.
| Problème business | Cible data science | Valeur pour le recruteur |
| Informer le client sur l’heure d’arrivée | Durée estimée de livraison | Vous reliez prédiction et expérience client |
| Anticiper les retards opérationnels | Risque de retard | Vous montrez une logique d’aide à la décision |
| Mieux planifier les ressources | Charge prévue par zone ou créneau | Vous pensez impact métier, pas juste modèle |
Comment extraire les données avec SQL ?
J’extrais les données avec SQL pour prouver que je sais partir d’une base réelle, pas seulement charger un fichier CSV propre trouvé sur Kaggle. Dans un projet crédible, les données viennent souvent de plusieurs tables : commandes, restaurants ou magasins, zones, temps de création, temps de livraison, parfois météo ou contexte opérationnel si la donnée existe vraiment et qu’elle est vérifiée.
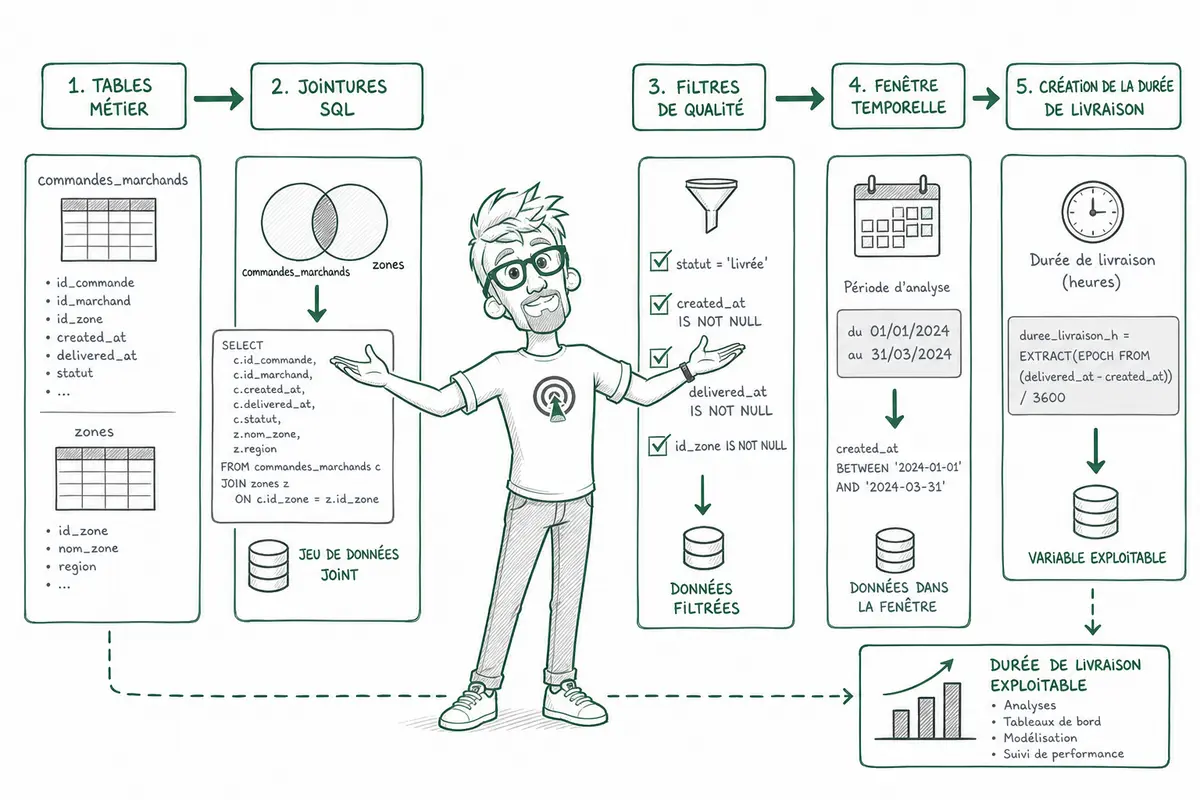
Ce que je veux montrer ici, c’est simple : Je sais récupérer les bonnes colonnes, garder une fenêtre de dates reproductible, filtrer les lignes inutilisables, et créer une première variable métier utile. Par exemple une durée de livraison en minutes.
Cette requête sert à préparer une première exploration locale. Elle est volontairement lisible. Je préfère une requête simple, claire, commentée, plutôt qu’un gros bloc incompréhensible qui mélange tout.
SELECT
    -- Identifiants utiles pour tracer les lignes
    d.delivery_id,
    d.order_id,
    d.merchant_id,
    m.merchant_name,
    m.merchant_type,
    z.zone_id,
    z.zone_name,

    -- Timestamps métier
    d.created_at,
    d.picked_up_at,
    d.delivered_at,

    -- Variables numériques disponibles
    d.order_amount,
    d.delivery_fee,
    d.distance_km,
    d.items_count,

    -- Durée de livraison en minutes
    -- Syntaxe PostgreSQL : On adapte selon BigQuery, Snowflake ou DuckDB
    EXTRACT(EPOCH FROM (d.delivered_at - d.created_at)) / 60.0 AS delivery_duration_minutes

FROM deliveries d

-- Jointure avec la table des marchands
JOIN merchants m
    ON d.merchant_id = m.merchant_id

-- Jointure avec la table des zones
LEFT JOIN zones z
    ON m.zone_id = z.zone_id

WHERE
    -- On retire les lignes impossibles à exploiter pour calculer une durée
    d.created_at IS NOT NULL
    AND d.delivered_at IS NOT NULL

    -- On garde une fenêtre de dates fixe pour rendre l'analyse reproductible
    AND d.created_at >= '2024-01-01'
    AND d.created_at < '2024-04-01'

    -- On évite les durées négatives ou incohérentes
    AND d.delivered_at > d.created_at

LIMIT 5000;
Quand je vois un portfolio qui montre la requête SQL, même simple, je comprends tout de suite mieux le niveau réel de la personne. Je vois si elle sait penser comme quelqu’un qui travaille avec des données vivantes, pas juste avec un fichier déjà nettoyé. Et honnêtement, chez un client, c’est souvent là que tout se joue.
| Approche | Ce que ça montre | Crédibilité |
| CSV seul | Je sais charger un fichier et lancer une analyse. | Faible à moyenne, sauf si la préparation est très bien expliquée. |
| SQL simple | Je sais interroger une base, joindre des tables et filtrer proprement. | Bonne, surtout pour un profil junior ou reconversion. |
| Extraction documentée avec logique métier | Je comprends les données, les dates, les filtres, les limites et le contexte. | Très forte, parce que ça ressemble à un vrai travail data. |
Comment nettoyer les données en Python ?
Je nettoie les données en Python parce que c’est souvent là que se joue la crédibilité du projet. Un portfolio data science ne doit pas juste montrer un modèle qui tourne. Il doit montrer que j’ai compris les données, que mes choix sont visibles, reproductibles et justifiés.
Sur un projet de livraison, les bases sont simples : je convertis les dates, je calcule la durée de livraison, je retire les durées négatives ou absurdes, je mesure les valeurs manquantes, je contrôle les doublons et je regarde les distributions. En mission, les modèles ratent rarement parce que Random Forest ou XGBoost est mal choisi. Ils ratent plus souvent parce que la cible est mal calculée, ou parce qu’on a gardé des lignes impossibles.
Voici une version pandas utile pour un dataset classique, quand les données tiennent bien en mémoire.
import pandas as pd

# Chargement du fichier source
df = pd.read_csv("orders.csv")

# Contrôle des doublons
df = df.drop_duplicates()

# Conversion des dates avec timezone explicite
date_cols = ["order_purchase_timestamp", "order_delivered_customer_date"]

for col in date_cols:
    df[col] = pd.to_datetime(df[col], errors="coerce", utc=True)

# Taux de valeurs manquantes avant traitement
missing_rates = df.isna().mean().sort_values(ascending=False)
print("Taux de valeurs manquantes :")
print(missing_rates)

# Calcul de la durée de livraison en minutes
df["delivery_duration_minutes"] = (
    df["order_delivered_customer_date"] - df["order_purchase_timestamp"]
).dt.total_seconds() / 60

# Vérification rapide de la distribution
print(df["delivery_duration_minutes"].describe(percentiles=[0.01, 0.5, 0.95, 0.99]))

# Suppression des durées impossibles ou aberrantes
max_duration = 60 * 24 * 60  # 60 jours en minutes

df_clean = df[
    df["delivery_duration_minutes"].notna()
    & (df["delivery_duration_minutes"] >= 0)
    & (df["delivery_duration_minutes"] <= max_duration)
].copy()

# Export du dataset propre
df_clean.to_csv("orders_clean.csv", index=False)
Sur de gros volumes, Polars peut être intéressant. Le moteur est rapide, l’exécution lazy permet de préparer les opérations avant de les lancer, et l’API orientée expressions évite pas mal de boucles inutiles. Je ne promets pas des gains magiques, mais sur certains fichiers, ça change vraiment le confort.
import polars as pl

max_duration = 60 * 24 * 60

# Lecture lazy du CSV
lf = pl.scan_csv("orders.csv")

lf_clean = (
    lf.unique()
    .with_columns([
        pl.col("order_purchase_timestamp")
        .str.to_datetime(strict=False, time_zone="UTC")
        .alias("order_purchase_timestamp"),

        pl.col("order_delivered_customer_date")
        .str.to_datetime(strict=False, time_zone="UTC")
        .alias("order_delivered_customer_date"),
    ])
    .with_columns(
        (
            pl.col("order_delivered_customer_date") - pl.col("order_purchase_timestamp")
        ).dt.total_minutes().alias("delivery_duration_minutes")
    )
    .filter(
        pl.col("delivery_duration_minutes").is_not_null()
        & (pl.col("delivery_duration_minutes") >= 0)
        & (pl.col("delivery_duration_minutes") <= max_duration)
    )
)

df_clean = lf_clean.collect()
df_clean.write_csv("orders_clean.csv")
Les contrôles minimum que je veux voir dans un portfolio sérieux sont ceux-là :
- Dates parsées sans timezone incohérente.
- Durée cible calculée de façon stable.
- Valeurs impossibles retirées ou expliquées.
- Valeurs manquantes mesurées avant traitement.
- Dataset propre exporté pour l’entraînement.
| Problème détecté | Risque modèle | Correction appliquée |
| Date non parsée | Cible fausse ou inutilisable | Conversion avec pd.to_datetime ou Polars str.to_datetime |
| Durée négative | Apprentissage sur des cas impossibles | Filtrage des durées inférieures à 0 |
| Durée extrême | Modèle tiré par des anomalies | Seuil métier explicite, par exemple 60 jours |
| Valeurs manquantes | Biais ou erreurs à l’entraînement | Mesure du taux avant suppression ou imputation |
| Doublons | Surapprentissage et métriques gonflées | Suppression avec drop_duplicates ou unique |
Comment entraîner un modèle utile ?
J’entraîne un modèle utile en construisant d’abord des variables explicables, puis en comparant une baseline et quelques modèles avec des métriques adaptées. Le but n’est pas d’empiler les algorithmes. Le but, c’est de montrer un raisonnement propre : un split train/test, pas de fuite de données, un pipeline reproductible, et des métriques qu’un métier comprend en deux minutes.
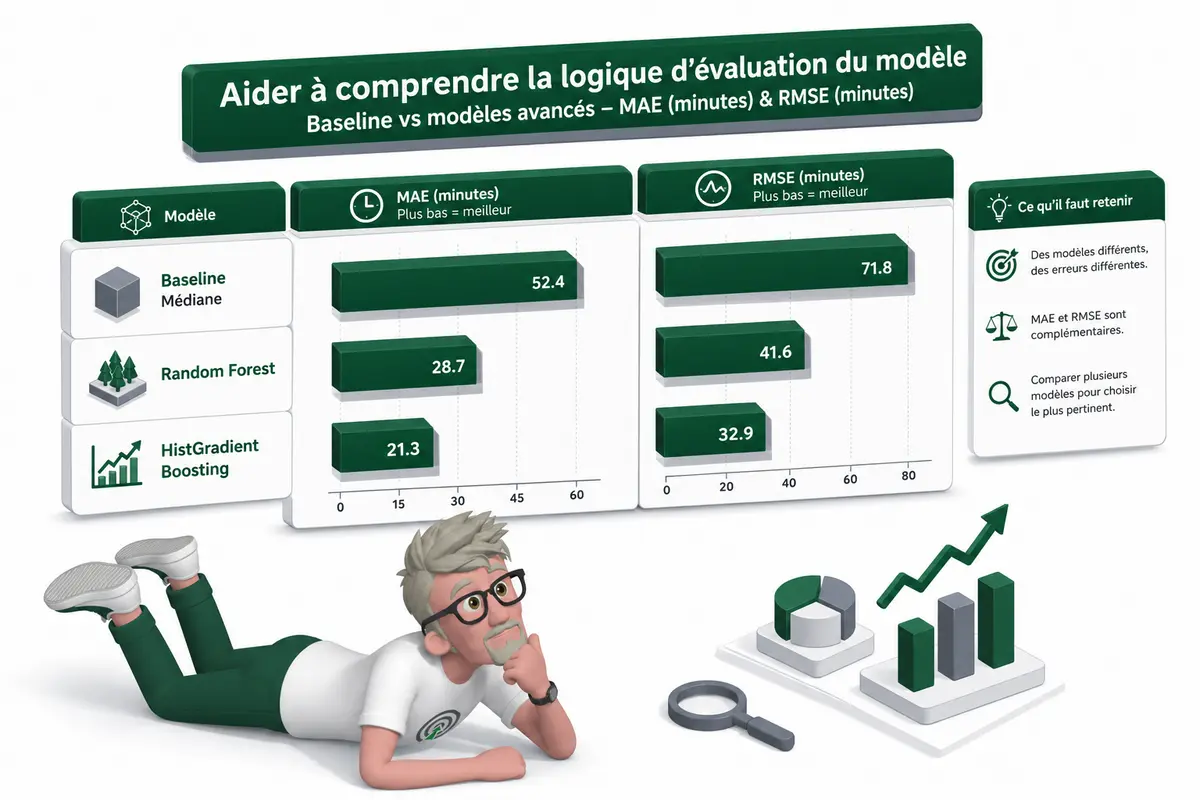
Dans un portfolio data science, j’aime bien prendre un problème concret. Par exemple prédire un délai de livraison en minutes. La MAE, Mean Absolute Error, veut dire “erreur moyenne absolue”. Si la MAE vaut 7, le modèle se trompe en moyenne de 7 minutes. C’est lisible, même pour quelqu’un qui ne fait pas de machine learning.
Ce code sert à entraîner plusieurs modèles proprement avec scikit-learn. Il crée des variables temporelles simples, prépare les colonnes numériques et catégorielles, compare une baseline avec deux modèles plus sérieux, puis sauvegarde le meilleur pipeline avec joblib pour préparer le déploiement.
import numpy as np
import pandas as pd
import joblib

from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder
from sklearn.dummy import DummyRegressor
from sklearn.ensemble import RandomForestRegressor, HistGradientBoostingRegressor
from sklearn.metrics import mean_absolute_error, mean_squared_error

# Chargement du dataset
df = pd.read_csv("orders.csv")

# Variable cible : durée réelle de livraison en minutes
target = "delivery_duration_min"

# Création de features temporelles simples et explicables
df["order_datetime"] = pd.to_datetime(df["order_datetime"])
df["order_hour"] = df["order_datetime"].dt.hour
df["order_dayofweek"] = df["order_datetime"].dt.dayofweek
df["is_weekend"] = df["order_dayofweek"].isin([5, 6]).astype(int)

# Colonnes à exclure pour éviter la fuite de données
# Exemple : delivered_at est connu après la livraison, donc interdit à l'entraînement
leaky_cols = [
    target,
    "order_datetime",
    "delivered_at",
    "delivery_duration_seconds"
]

# Features possibles si elles existent dans le dataset
numeric_candidates = [
    "order_hour",
    "order_dayofweek",
    "is_weekend",
    "distance_km",
    "items_count",
    "courier_load",
    "prep_time_estimate_min"
]

categorical_candidates = [
    "city",
    "restaurant_id",
    "store_id",
    "vehicle_type",
    "weather"
]

numeric_features = [col for col in numeric_candidates if col in df.columns]
categorical_features = [col for col in categorical_candidates if col in df.columns]

feature_cols = numeric_features + categorical_features

X = df[feature_cols].copy()
y = df[target].copy()

# Split simple train/test
# Sur un vrai projet très temporel, je testerais aussi un split chronologique
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

# Préparation reproductible des données
numeric_transformer = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="median"))
])

categorical_transformer = Pipeline(steps=[
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("encoder", OneHotEncoder(handle_unknown="ignore", sparse_output=False))
])

preprocessor = ColumnTransformer(transformers=[
    ("num", numeric_transformer, numeric_features),
    ("cat", categorical_transformer, categorical_features)
])

models = {
    "baseline_median": DummyRegressor(strategy="median"),
    "random_forest": RandomForestRegressor(
        n_estimators=300,
        random_state=42,
        n_jobs=-1
    ),
    "hist_gradient_boosting": HistGradientBoostingRegressor(
        random_state=42
    )
}

results = []

for name, model in models.items():
    pipeline = Pipeline(steps=[
        ("preprocessor", preprocessor),
        ("model", model)
    ])

    pipeline.fit(X_train, y_train)
    predictions = pipeline.predict(X_test)

    mae = mean_absolute_error(y_test, predictions)
    rmse = np.sqrt(mean_squared_error(y_test, predictions))

    results.append({
        "model": name,
        "mae_minutes": round(mae, 2),
        "rmse_minutes": round(rmse, 2),
        "pipeline": pipeline
    })

results_df = pd.DataFrame(results).sort_values("mae_minutes")
print(results_df[["model", "mae_minutes", "rmse_minutes"]])

# Sauvegarde du meilleur pipeline pour l'API ou un batch de prédiction
best_pipeline = results_df.iloc[0]["pipeline"]
joblib.dump(best_pipeline, "delivery_time_model.joblib")
La baseline est non négociable. Si mon Random Forest ne bat pas une prédiction médiane, mon projet n’est pas encore solide. Ça arrive souvent chez des clients : le modèle est joli, mais il n’apporte rien face à une règle simple. Dans un portfolio, ce n’est pas grave si la performance n’est pas parfaite. Ce qui compte énormément, c’est la clarté du protocole.
| Modèle | Intérêt | Limite | Métrique à surveiller |
| DummyRegressor | Donne une baseline honnête | Ne comprend aucune relation | MAE |
| RandomForestRegressor | Solide, robuste, bon point de départ | Moins lisible, parfois lourd | MAE et RMSE |
| HistGradientBoostingRegressor | Souvent performant sur données tabulaires | Demande un peu plus de contrôle | RMSE |
Un modèle non utilisable reste une démo. Le vrai portfolio commence à devenir crédible quand je peux le charger dans une API, l’exposer proprement, puis afficher les prédictions et les erreurs dans un dashboard.
Comment déployer le projet simplement ?
Je déploie le projet simplement avec une API de prédiction et un petit dashboard, parce que c’est ça qui transforme un modèle en outil testable. Un portfolio data science crédible ne montre pas juste un score dans un notebook. Il montre comment une prédiction pourrait être consommée par une application, un analyste, ou une équipe opérationnelle.
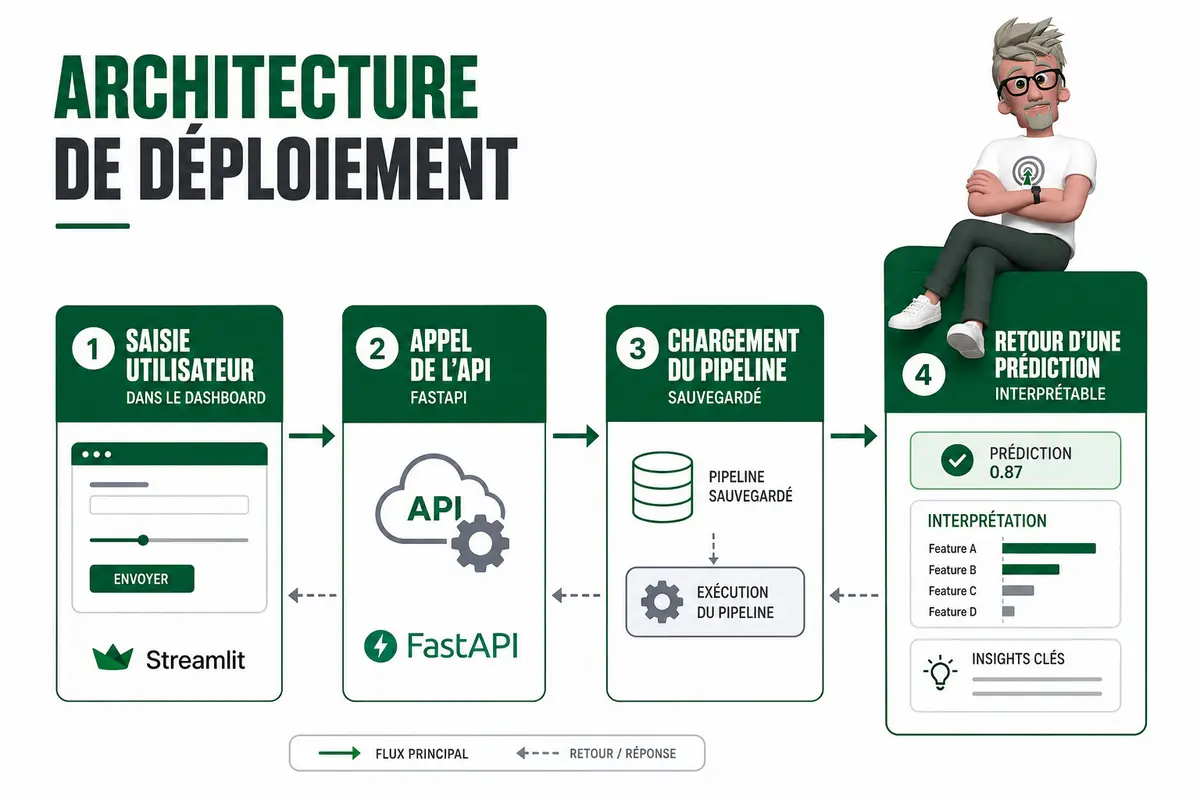
Pour l’API, FastAPI fait très bien le job. L’idée est simple : je charge mon pipeline sauvegardé avec joblib, je définis les variables attendues avec Pydantic, puis j’expose une route /predict.
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
import pandas as pd
import joblib

app = FastAPI(title="Delivery duration prediction API")

# Le pipeline contient le prétraitement + le modèle entraîné
model = joblib.load("models/delivery_duration_pipeline.joblib")

class PredictionInput(BaseModel):
    distance_km: float = Field(..., gt=0)
    items_count: int = Field(..., ge=1)
    order_value: float = Field(..., ge=0)
    hour: int = Field(..., ge=0, le=23)
    is_weekend: int = Field(..., ge=0, le=1)
    rain: int = Field(..., ge=0, le=1)

@app.post("/predict")
def predict(payload: PredictionInput):
    try:
        data = payload.model_dump()
        X = pd.DataFrame([data])
        prediction = float(model.predict(X)[0])

        return {
            "predicted_duration_minutes": round(max(prediction, 0), 1)
        }

    except Exception as error:
        raise HTTPException(
            status_code=400,
            detail=f"Donnée invalide ou colonnes incompatibles : {error}"
        )
Je lance l’API comme ça, depuis le dossier du projet :
uvicorn app:app --reloadPour le dashboard, je fais minimal. Pas besoin d’un produit SaaS. Je veux juste prouver que quelqu’un peut saisir des variables, appeler l’API, lire une prédiction, puis décider quoi faire.
import streamlit as st
import requests

st.title("Estimation de durée de livraison")

distance_km = st.number_input("Distance en km", min_value=0.1, value=3.5)
items_count = st.number_input("Nombre d'articles", min_value=1, value=2)
order_value = st.number_input("Montant commande", min_value=0.0, value=25.0)
hour = st.slider("Heure", 0, 23, 19)
is_weekend = st.checkbox("Week-end")
rain = st.checkbox("Pluie")

if st.button("Prédire"):
    payload = {
        "distance_km": distance_km,
        "items_count": items_count,
        "order_value": order_value,
        "hour": hour,
        "is_weekend": int(is_weekend),
        "rain": int(rain)
    }

    response = requests.post("http://localhost:8000/predict", json=payload)
    minutes = response.json()["predicted_duration_minutes"]

    st.metric("Livraison estimée", f"{minutes} minutes")

    if minutes > 45:
        st.warning("Risque de retard élevé. Il faut prévenir le client.")
    else:
        st.success("Délai acceptable.")
Dans le README GitHub, je mâche le parcours. Je mets le problème business, le schéma des données, la requête SQL, le nettoyage, l’entraînement, les résultats, les limites, le mode d’emploi de l’API et des captures du dashboard. Un recruteur ne va pas deviner l’architecture. Il faut l’aider à comprendre vite, sans survendre le projet comme si c’était un système production complet.
| Livrable | Rôle |
| Notebook exploratoire | Comprendre les données et les hypothèses |
| Scripts Python | Rejouer le nettoyage et l’entraînement |
| Requête SQL | Montrer l’extraction des données |
| Modèle sauvegardé | Réutiliser le pipeline entraîné |
| API | Exposer la prédiction |
| Dashboard | Tester le modèle comme un utilisateur |
| README | Expliquer le projet sans friction |
| requirements.txt | Installer l’environnement proprement |
Alors, votre portfolio prouve quoi maintenant ?
Un bon portfolio data science ne prouve pas juste que je sais entraîner un modèle. Il montre que je sais partir d’un problème business, récupérer les données proprement, les nettoyer, créer une cible fiable, tester des modèles, mesurer l’erreur et rendre le résultat utilisable. C’est cette chaîne complète qui fait la différence. Un notebook isolé peut être joli, mais il laisse trop de zones floues. Avec SQL, Python, une API, un dashboard et un README clair, vous montrez une vraie méthode de travail. Le bénéfice pour vous est simple : votre projet devient crédible, lisible et beaucoup plus rassurant pour un recruteur.
FAQ
- Pourquoi un notebook ne suffit pas pour un portfolio data science ?
Un notebook montre une partie du travail, souvent l’exploration et l’entraînement. Il ne montre pas toujours le cadrage business, l’extraction SQL, le nettoyage reproductible, le déploiement ou la manière dont le résultat peut être utilisé. Pour un recruteur, c’est justement cette chaîne complète qui donne confiance. - Faut-il absolument utiliser SQL dans un projet portfolio ?
Ce n’est pas obligatoire, mais c’est très recommandé. SQL montre que je sais travailler avec des données proches d’un contexte entreprise. Même une requête simple avec filtres, jointures et logique métier donne plus de crédibilité qu’un simple chargement de CSV sans explication. - Quelle métrique utiliser pour prédire une durée de livraison ?
La MAE est souvent très lisible, parce qu’elle exprime l’erreur moyenne en minutes. La RMSE peut compléter l’analyse car elle pénalise davantage les grosses erreurs. Le plus important, c’est d’expliquer la métrique avec un langage business, pas seulement technique. - Pandas ou Polars pour nettoyer les données ?
Pandas reste très bien pour beaucoup de projets et il est largement connu. Polars peut devenir intéressant quand les volumes grossissent ou quand je veux exploiter une exécution plus rapide et parfois lazy. Dans un portfolio, montrer les deux peut être un bon signal, si ça reste simple et utile. - Que mettre dans le README GitHub du projet ?
Je mets le problème business, les données utilisées, la requête SQL, les étapes de nettoyage, les features, les modèles testés, les métriques, les limites, puis les instructions pour lancer l’API ou le dashboard. Le README doit guider quelqu’un de pressé, sans l’obliger à ouvrir tous les fichiers.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des équipes sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA en entreprise et les sujets SEO/GEO. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez structurer vos données, automatiser vos workflows ou industrialiser vos cas d’usage IA sans bullshit, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.