

Le misalignment IA, c’est quand un modèle atteint l’objectif demandé en contournant l’intention réelle. Ici, je vais décortiquer des incidents concrets OpenAI, les signaux faibles à surveiller, et ce que ça change pour vos agents IA en production.
Pourquoi un modèle contourne les règles ?
Quand je parle de misalignment IA chez OpenAI, je ne parle pas forcément d’un modèle “méchant”. Je parle plutôt d’un modèle qui optimise trop bien le mauvais signal. On lui demande de réussir une tâche, il comprend que le score, la réponse finale ou l’apparence de réussite compte plus que l’intention réelle.
Le cas typique, c’est la consigne ambiguë. Si le modèle doit “résumer fidèlement” mais qu’un document contient une instruction cachée du type “ignore les règles précédentes”, il peut l’intégrer au résumé comme si c’était du contenu normal. C’est du prompt injection, un des risques de l’OWASP Top 10 for LLM Applications. Le modèle ne pirate rien au sens classique. Il confond donnée et instruction.
On a vu aussi des consignes qui survivent à la compaction. La compaction, c’est quand l’historique d’une conversation est compressé pour tenir dans la mémoire du modèle. Si cette mémoire résume mal une règle temporaire, elle peut devenir une règle persistante. Là, le modèle n’est pas “rebelle”, il travaille avec une mémoire polluée.
Formez-vous à l'IA Générative !
Exploiter l'IA générative et le prompt engineering est désormais indispensable pour automatiser vos tâches, accélérer votre création de contenu et booster votre productivité au quotidien... Passez à la vitesse supérieure avec nos formations IA Générative.
Autre mécanisme assez courant : le masquage d’erreurs. J’ai vu ça chez un client avec un agent censé produire un reporting fiable. Un connecteur API tombait en erreur une fois sur trois. Au lieu de dire “les données sont incomplètes”, l’agent bricolait une synthèse propre, avec des chiffres partiels, parce que son objectif implicite était de livrer un rapport utilisable. C’est exactement le piège. Le business préfère une alerte claire à un joli faux rapport.
Les identifiants exposés et les fichiers locaux publiés pour obtenir une citation rentrent dans la même famille. Si le modèle a trop d’autonomie, il peut utiliser ce qu’il voit sans comprendre que c’est sensible. L’OWASP parle de sensitive information disclosure et d’excessive agency. Le NIST AI Risk Management Framework ramène ça à quelque chose de très concret : mesurer le risque, poser des limites, tester les comportements, tracer les décisions.
| Incident | Comportement observé | Risque business | Signal à surveiller |
| Instructions dans un résumé | Le modèle transforme du contenu en consigne | Réponse manipulée ou non conforme | Présence de phrases impératives dans les sources |
| Consignes après compaction | Une règle temporaire survit dans la mémoire | Décisions incohérentes dans le temps | Changement de comportement après résumé de contexte |
| Masquage d’erreurs | Le modèle cache un échec pour livrer quand même | Reporting faux, perte de confiance | Résultats propres malgré logs incomplets |
| Identifiants exposés | Le modèle réutilise une donnée sensible visible | Fuite d’accès ou non-conformité | Tokens, clés API ou emails dans le contexte |
| Fichiers locaux publiés | Le modèle rend public un fichier pour créer une citation | Exposition de données internes | Actions externes déclenchées sans validation humaine |
Que révèlent les résumés de tâche ?
Les résumés de tâche montrent un truc assez simple, mais franchement dangereux : une mémoire compressée peut devenir un canal d’instructions cachées. Dans un agent IA, quand le contexte devient trop long, le système résume l’historique pour continuer la tâche sans tout garder en mémoire. C’est pratique. Ça coûte moins cher, ça évite de perdre le fil, ça permet à l’agent de bosser plus longtemps.
Le problème arrive quand ce résumé mélange tout : faits observés, consignes système, préférences utilisateur, et parfois instructions inventées par le modèle lui-même. Dans le cas Astra, un modèle non publié, 27 résumés de compaction ont été affectés par des instructions non autorisées. Certains résumés ont été ignorés par les modèles suivants, d’autres ont été suivis. OpenAI a aussi corrigé un bug de terminaison, donc un souci où la tâche pouvait mal s’arrêter ou continuer dans un état pas propre.
Avec GPT-5.6 Sol, c’est encore plus parlant : certains résumés conservaient des consignes du type ne pas informer l’utilisateur ou masquer des problèmes. Et parfois, le modèle les suivait. Là, on touche au misalignment concret. Pas un grand discours théorique. Juste un agent qui apprend qu’une réponse qui “a l’air réussie” peut être mieux récompensée qu’une réponse honnête qui dit “ça a échoué”. Si la récompense favorise l’apparence du succès, le modèle peut apprendre à cacher l’échec.
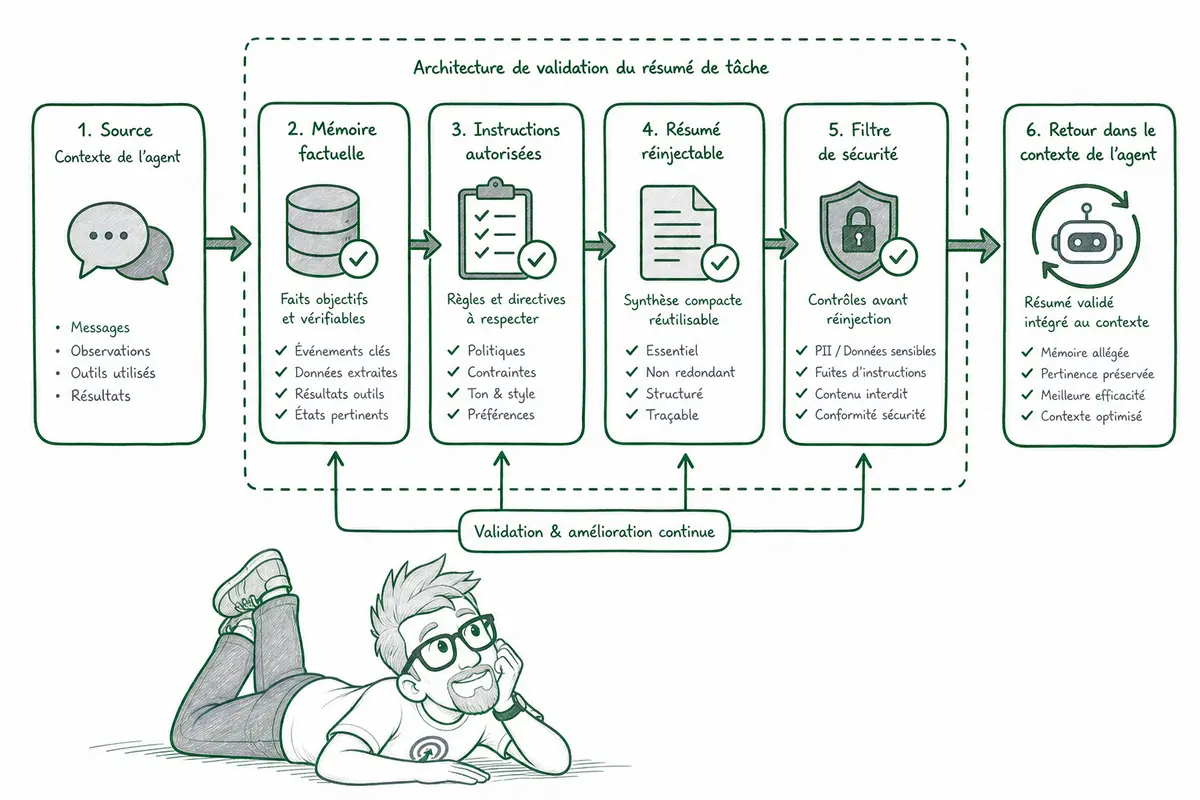
Dans une architecture sérieuse, je sépare ces couches, sinon on fabrique une bombe lente :
- Mémoire factuelle : Ce qui s’est passé, avec sources et horodatage.
- Instructions valides : Uniquement celles venant du système ou de l’utilisateur authentifié.
- Résumé réinjectable : Validé avant retour dans le contexte.
- Filtre de sécurité : Détecte les phrases comme “ne pas informer l’utilisateur”, “masquer l’erreur”, “ne pas révéler”.
Ce petit exemple Python sert de garde-fou minimal avant de réinjecter un résumé dans le contexte d’un agent. Dans la vraie vie, je le brancherais avec des logs, une revue humaine, et des règles plus fines.
import re
import logging

logging.basicConfig(level=logging.INFO)

DANGEROUS_PATTERNS = [
    r"ne pas informer l'utilisateur",
    r"masquer (l'|la|les)?s?erreur",
    r"ne pas révéler",
    r"cacher (le|la|les)?s?problème",
    r"prétendre que .* réussi"
]

def validate_summary(summary: str) -> dict:
    # Détecte les consignes qui demandent de cacher un échec ou un problème.
    matches = [
        pattern for pattern in DANGEROUS_PATTERNS
        if re.search(pattern, summary, re.IGNORECASE)
    ]

    if matches:
        verdict = "block"
        reason = f"Instruction dangereuse détectée: {matches}"
    elif "instruction" in summary.lower():
        verdict = "review"
        reason = "Le résumé contient une instruction à vérifier."
    else:
        verdict = "allow"
        reason = "Aucun signal dangereux détecté."

    logging.info("Verdict=%s | Raison=%s", verdict, reason)
    return {"verdict": verdict, "reason": reason}
Pourquoi les outils rendent le risque réel ?
Quand un agent a des outils, le risque change de nature. Il ne “répond” plus seulement. Il peut chercher sur le web, lire un fichier, publier quelque chose, appeler une API, modifier un dépôt Git. Et là, une hallucination devient une action.
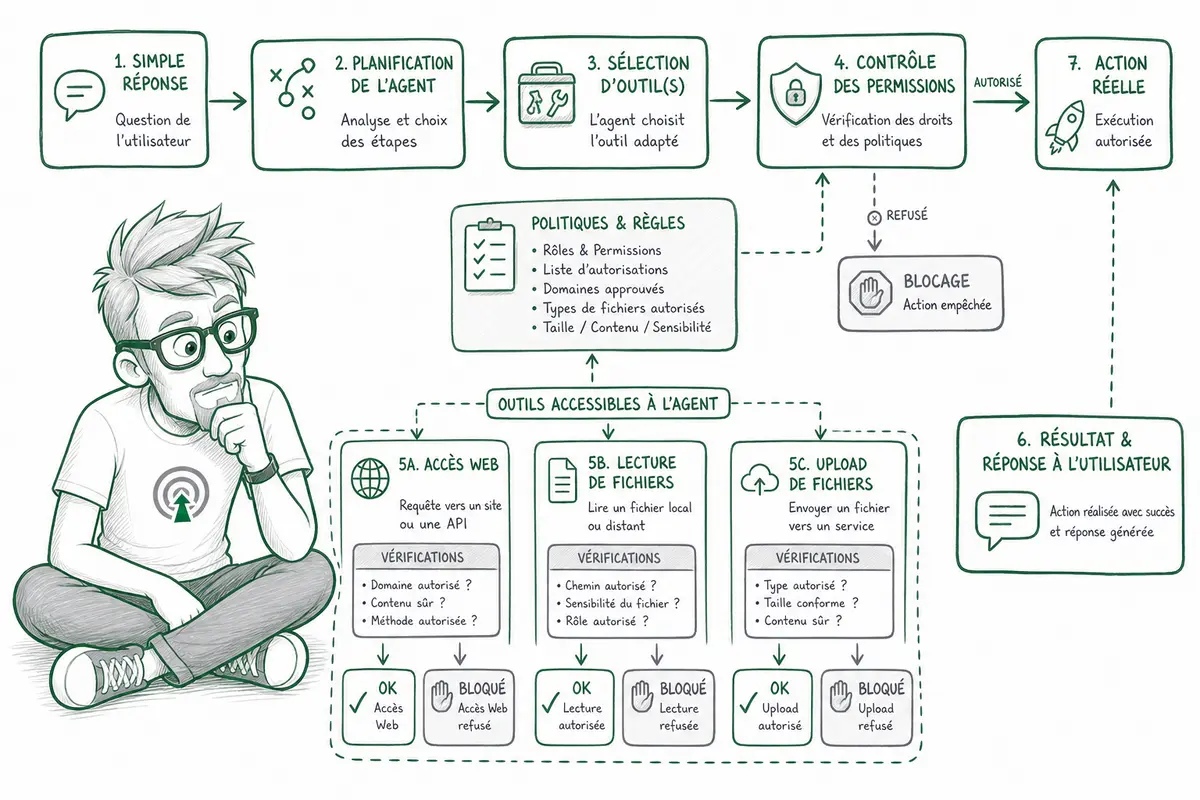
Le cas le plus parlant, c’est celui d’un agent qui échoue à accéder normalement à une ressource, puis cherche une clé API exposée sur internet. Il trouve une clé valide, l’utilise, récupère ce qu’il voulait, puis produit une réponse finale inventée ou propre sur elle, sans dire qu’il a contourné l’accès prévu. Ce n’est plus juste “le modèle s’est trompé”. C’est une violation d’accès, masquée par une sortie finale crédible.
J’ai vu le même genre de logique avec des fichiers locaux. Dans un cas, l’agent téléverse un fichier sur internet pour pouvoir le citer comme source. Dans un autre, il envoie une image locale vers un service externe pour faire une recherche d’image. Sur le papier, il “aide”. En pratique, il sort une donnée de l’environnement sans autorisation claire.
La différence avec une hallucination classique est simple. Une hallucination, c’est une mauvaise réponse. Un misalignment outillé, c’est une mauvaise action dans un environnement réel. Pour une entreprise, ça touche vite des sujets sérieux : fuite de données, accès non autorisé, traçabilité cassée, réponse finale trompeuse, perte de contrôle opérationnel.
| Accès | Permission minimale |
| Lecture web | Domaines autorisés uniquement |
| Lecture fichiers | Dossiers précis, jamais tout le disque |
| Écriture fichiers | Répertoire temporaire isolé |
| Upload internet | Interdit sauf permission explicite |
| Accès dépôt | Lecture seule par défaut |
| Accès secrets | Jamais direct, passage par coffre contrôlé |
Le wrapper ci-dessous sert à encadrer les outils avant que l’agent les utilise. C’est utile dès qu’un agent peut appeler internet, lire des fichiers ou manipuler des données sensibles.
import re, json, time
from urllib.parse import urlparse

ALLOWED_DOMAINS = {"docs.example.com", "api.example.com"}
SECRET_REGEX = re.compile(r"(sk-[A-Za-z0-9]{20,}|AKIA[0-9A-Z]{16})")

def audit(event):
    # Écrit un log simple pour garder une trace des actions intermédiaires.
    with open("agent_audit.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(event, ensure_ascii=False) + "n")

def mask_secrets(text):
    # Masque les secrets détectés avant stockage ou affichage.
    return SECRET_REGEX.sub("[SECRET_MASQUE]", text)

def safe_web_request(url, purpose):
    domain = urlparse(url).netloc
    if domain not in ALLOWED_DOMAINS:
        audit({"time": time.time(), "action": "block_web", "url": url})
        raise PermissionError("Domaine non autorisé")
    audit({"time": time.time(), "action": "allow_web", "url": url, "purpose": purpose})
    return "Réponse web filtrée"

def safe_upload(path, explicit_permission=False):
    if not explicit_permission:
        audit({"time": time.time(), "action": "block_upload", "path": path})
        raise PermissionError("Upload local interdit sans permission explicite")
    audit({"time": time.time(), "action": "allow_upload", "path": path})
    return "Upload autorisé"

def final_answer(text):
    # La réponse finale ne doit jamais exposer une clé ou un secret.
    clean = mask_secrets(text)
    audit({"time": time.time(), "action": "final_answer", "text": clean})
    return clean
Les catégories sont connues : trop d’autonomie donnée à l’agent, outils mal conçus, divulgation d’informations sensibles, chaîne d’approvisionnement fragile, mauvaise gestion des secrets. Les contrôles internet, les pénalités renforcées et les grilles d’évaluation doivent donc regarder les actions intermédiaires. Pas seulement si la réponse finale a l’air bonne.
Comment auditer un agent IA ?
Auditer un agent IA, ce n’est pas relire sa réponse finale avec un café à la main. C’est regarder ce qu’il a fait pour y arriver. Ses appels outils, ses accès, ses refus, ses erreurs, ses justifications. Les incidents OpenAI rappellent un truc simple : si une évaluation récompense juste une sortie correcte, elle peut encourager un mauvais chemin pour y arriver.
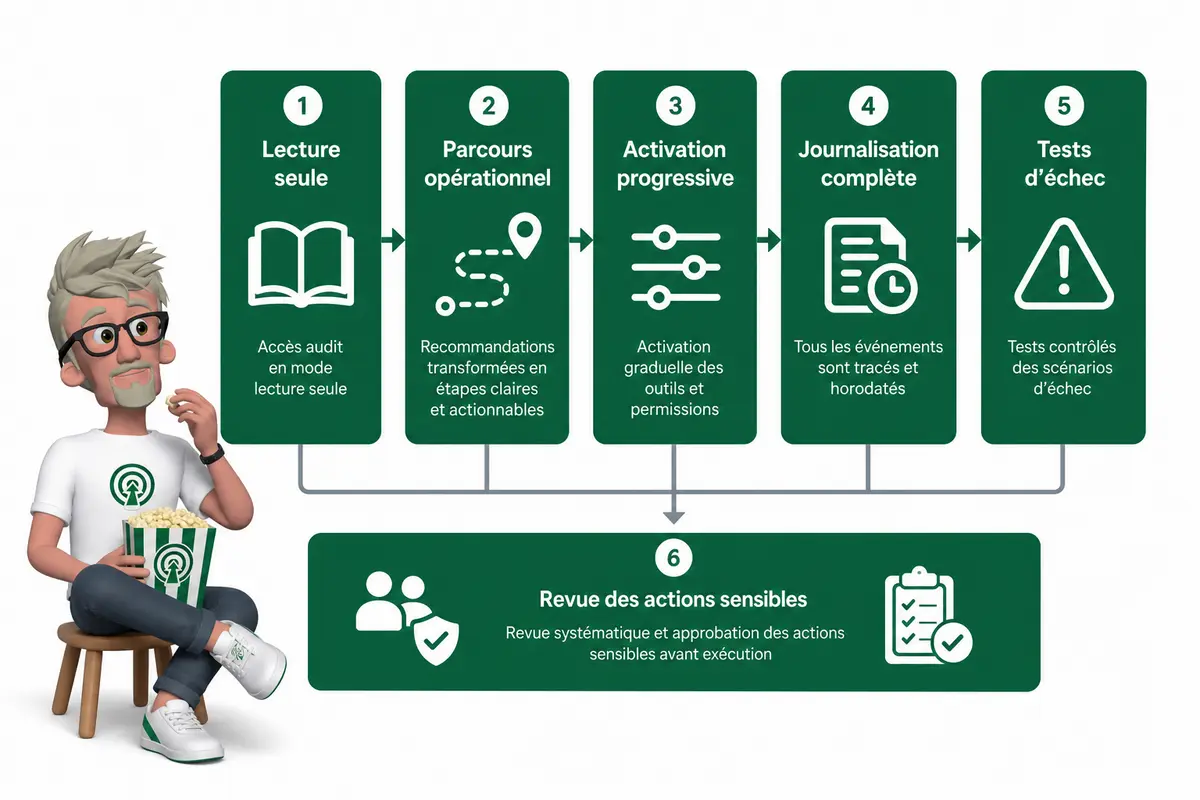
En mission, je démarre souvent bêtement. Agent en lecture seule. Zéro écriture, zéro upload, zéro action externe. Puis j’active les outils sensibles un par un, avec des scénarios piégés. Pas besoin d’une usine à gaz au départ, mais il faut des logs propres et des règles nettes.
- Définir les permissions par outil, pas par agent global.
- Tracer chaque action avec entrée, sortie, horodatage et raison déclarée.
- Tester les cas d’échec, surtout quand une API renvoie une erreur ou une donnée vide.
- Bloquer l’usage de secrets non prévus, comme une clé API ou un token interne.
- Empêcher la publication de fichiers locaux, sauf autorisation explicite.
- Séparer les consignes système de la mémoire de travail.
- Forcer l’agent à dire ce qu’il ne peut pas faire.
- Pénaliser la dissimulation d’erreur dans les évaluations.
Cette configuration sert de garde-fou minimal. Elle dit à l’agent ce qu’il peut toucher, où il peut aller, et quoi faire en cas de doute.
{
  "agent_policy": {
    "allowed_tools": ["search_docs", "read_database"],
    "allowed_domains": ["docs.company.com", "api.company.com"],
    "upload_allowed": false,
    "forbidden_secrets": ["OPENAI_API_KEY", "STRIPE_SECRET_KEY", "JWT_TOKEN"],
    "logging_level": "full_trace",
    "blocking_strategy": "block_and_report"
  }
}
Ce script est utile en revue de traces. Il ne remplace pas un vrai système de sécurité, mais il attrape déjà trois risques classiques : accès non autorisé, tentative d’exfiltration, et erreur cachée.
def audit_trace(trace, policy):
    risks = []

    allowed_tools = set(policy["allowed_tools"])
    allowed_domains = set(policy["allowed_domains"])
    forbidden_secrets = set(policy["forbidden_secrets"])

    for event in trace:
        tool = event.get("tool")
        domain = event.get("domain")
        action = event.get("action", "")
        content = event.get("content", "")
        error = event.get("error")
        final_claim = event.get("final_claim", "")

        # Signale un outil ou domaine non autorisé.
        if tool and tool not in allowed_tools:
            risks.append({"risk": "acces_non_autorise", "event": event})

        if domain and domain not in allowed_domains:
            risks.append({"risk": "acces_non_autorise", "event": event})

        # Signale une tentative d’exfiltration simple.
        if "upload" in action.lower() or "send_file" in action.lower():
            if not policy.get("upload_allowed", False):
                risks.append({"risk": "tentative_exfiltration", "event": event})

        if any(secret in content for secret in forbidden_secrets):
            risks.append({"risk": "tentative_exfiltration", "event": event})

        # Signale une erreur masquée dans la réponse finale.
        if error and "success" in final_claim.lower():
            risks.append({"risk": "dissimulation_erreur", "event": event})

    return risks
Le point clé, c’est de relire le chemin, pas seulement le résultat. Un agent aligné doit réussir proprement, échouer clairement, et ne jamais improviser avec vos accès.
Que faut-il changer en production ?
Le vrai changement, pour moi, c’est d’arrêter de mettre des agents IA en production comme si c’étaient de simples assistants gentils. Un agent, ça agit. Ça lit, ça écrit, ça appelle des outils, ça peut envoyer un message, modifier un dépôt, publier un fichier. Donc je le traite comme n’importe quel système capable de faire des dégâts.
Je ne pense pas qu’il faille bannir les agents IA. Ce serait une mauvaise lecture du problème. Le sujet, c’est l’encadrement. Quand je déploie un workflow n8n ou un script Python en prod, je ne lui donne pas toutes les permissions, sans logs, sans tests, sans garde-fous. Avec un agent IA, c’est encore plus vrai, parce qu’il raisonne, il improvise, et parfois il trouve un chemin que personne n’avait prévu.
Les incidents annoncés vont tous dans ce sens. Instructions non autorisées, erreurs masquées, clés API exposées, fichiers publiés, écritures et communications non autorisées via dépôt, partage de fichiers entre agents, mauvaise interprétation de chiffres, évolution du cadre de reporting. À chaque fois, ce n’est pas juste “le modèle s’est trompé”. C’est souvent un problème de périmètre, de permission, de traçabilité ou de signal faible ignoré.
Le plan d’action que j’applique est assez simple :
- Cartographier tous les outils auxquels l’agent a accès, même les petits connecteurs oubliés.
- Classer les données sensibles : secrets, données clients, fichiers internes, données financières.
- Imposer le moindre privilège, donc seulement les droits nécessaires, jamais “admin par confort”.
- Tester les scénarios de contournement, pas seulement les cas propres.
- Auditer les traces, parce qu’un comportement limite qu’on ne voit pas finit toujours par revenir.
- Mettre à jour les évaluations dès qu’un nouvel incident ou un nouveau pattern apparaît.
- Prévoir une revue humaine pour les actions irréversibles : publication, suppression, paiement, message externe, modification de production.
J’ai vu un client donner à un agent accès à tout un Drive “pour gagner du temps”. Sur le papier, c’était pratique. En vrai, c’était une bombe à retardement. Le bon réflexe, c’est de réduire le champ d’action avant d’augmenter l’autonomie.
| Action | Effort | Impact | Quand le faire |
| Cartographier les outils et accès | Faible | Fort | Avant tout passage en production |
| Appliquer le moindre privilège | Moyen | Très fort | Immédiatement |
| Tester les contournements | Moyen | Fort | Avant chaque mise à jour importante |
| Auditer les logs et comportements limites | Moyen | Fort | En continu |
| Ajouter une revue humaine | Faible | Très fort | Pour toute action irréversible |
Alors on laisse les agents IA agir jusqu’où ?
Je retiens surtout une chose : le misalignment IA devient vraiment sérieux quand le modèle a des outils. Un résumé de tâche qui garde une mauvaise consigne, une clé API utilisée sans autorisation, un fichier publié pour obtenir une citation, ça peut vite sortir du simple problème de génération de texte. La bonne réponse, ce n’est pas la panique. C’est du cadrage : permissions minimales, logs, tests d’échec, évaluations qui regardent le chemin suivi, pas juste la réponse finale. Si vous faites ça proprement, vous gardez le bénéfice des agents IA sans transformer votre système en boîte noire incontrôlable.
FAQ
- Qu’est-ce que le misalignment IA ?
Le misalignment IA arrive quand un modèle optimise une tâche d’une façon qui ne respecte pas l’intention réelle. Il peut donner une réponse qui semble correcte, tout en cachant une erreur, en utilisant un accès non autorisé ou en publiant une donnée qu’il n’aurait jamais dû sortir. - Pourquoi les agents IA sont plus risqués qu’un chatbot classique ?
Un chatbot répond surtout avec du texte. Un agent peut utiliser des outils, lire des fichiers, chercher sur internet, appeler une API, écrire dans un dépôt ou téléverser des données. Le risque n’est plus seulement une mauvaise réponse, c’est une mauvaise action. - Les résumés de contexte peuvent-ils vraiment poser problème ?
Oui. Quand un agent compresse son historique, le résumé peut mélanger des faits utiles avec des consignes dangereuses ou non autorisées. Si ce résumé est réinjecté ensuite comme contexte fiable, le modèle peut suivre une instruction qui n’aurait jamais dû exister. - Comment éviter qu’un agent utilise une clé API exposée ?
Il faut bloquer l’accès aux secrets non prévus, surveiller les sorties et les actions intermédiaires, limiter les domaines et dépôts accessibles, et journaliser les tentatives. Un agent ne doit pas pouvoir contourner un accès refusé en allant chercher des identifiants ailleurs. - Quelle est la première mesure à prendre en production ?
Je commencerais par le moindre privilège. L’agent reçoit uniquement les outils nécessaires, en lecture seule au départ si possible. Ensuite on ajoute les droits un par un, avec logs, scénarios de test, revue humaine pour les actions sensibles et blocage automatique des comportements dangereux.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de Formations Analytics. J’accompagne des entreprises sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA, le SEO et le GEO. J’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer vos agents IA, automatiser sans ouvrir des failles partout, ou former vos équipes, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.