

Je réussis mon n8n workflow versioning en traitant chaque workflow comme du code. Git garde l’historique, les branches séparent les environnements, les commits expliquent les changements. Le vrai sujet, c’est d’éviter qu’un petit ajustement casse une automatisation entière sans retour arrière propre.
Pourquoi versionner ses workflows n8n ?
Je versionne mes workflows n8n pour pouvoir comprendre, comparer et restaurer un état fiable quand une automatisation casse. C’est aussi simple que ça. Quand un workflow tourne tous les jours, il devient une petite pièce de production, même s’il a été construit en low code avec trois nœuds au départ.
Dans n8n, un changement minuscule peut tout bloquer. Une condition modifiée trop vite. Un mapping de champ déplacé. Une API qui ne reçoit plus le bon format. Un nœud Slack, HubSpot, Airtable ou HTTP Request qui change de comportement. Sur l’écran, ça a l’air petit. Dans la vraie vie, ça peut couper toute une chaîne : plus de lead créé, plus de facture envoyée, plus d’alerte transmise.
Je le vois souvent chez les clients. Le problème arrive rarement pendant les grosses refontes, parce que là tout le monde fait attention. Il arrive plutôt sur une petite modification faite vite, entre deux réunions. Un “je change juste ce filtre” qui finit en régression silencieuse. Le workflow continue parfois de tourner, mais il produit une mauvaise donnée. C’est pire qu’une erreur visible.
Sans versioning, on se retrouve vite avec des questions pénibles. Qui a modifié quoi ? Quand ? Pourquoi ce nœud ne ressemble plus à la version qui marchait hier ? Est-ce qu’un autre éditeur a écrasé mon travail ? Est-ce qu’on peut revenir à un état propre sans tout reconstruire à la main ?
Agents IA n8n : une formation pratique pour accélerer votre productivité avec le No Code !
Les formations n8n vous ouvrent les portes d’une automatisation intelligente, fluide et évolutive. Vous y apprendrez à construire des workflows sur mesure, à interconnecter vos outils métiers, à transformer vos données, et même à intégrer des agents IA ou des systèmes RAG dans vos scénarios.
Sauvegarder, c’est utile pour dormir un peu mieux. On exporte un JSON quelque part, on se dit qu’on est couvert. Versionner, c’est maintenir sérieusement. On garde un historique traçable des définitions de workflow, on compare les changements, on documente les états stables, et on peut restaurer une version fiable sans jouer aux archéologues.
| Problème | Impact | Réponse apportée |
| Sans versioning, une modification écrase l’état précédent. | On perd la dernière version fonctionnelle. | Avec versioning, je peux restaurer un état stable. |
| Sans versioning, une régression peut passer inaperçue. | Le workflow tourne, mais avec de mauvaises données. | Avec versioning, je compare précisément ce qui a changé. |
| Sans versioning, plusieurs éditeurs travaillent à l’aveugle. | Les changements se mélangent et deviennent difficiles à auditer. | Avec versioning, l’historique rend les modifications traçables. |
Comment Git suit-il un workflow n8n ?
Git suit un workflow n8n parce qu’un workflow est représenté par une définition structurée, généralement en JSON, qui décrit les nœuds, leurs connexions, leur logique et leurs paramètres. Git adore ce genre de fichiers texte. Il sait montrer ce qui a changé, ligne par ligne, entre deux versions.
Le point important, et je préfère être très clair là-dessus : je ne commit jamais les mots de passe, tokens, clés API ou credentials sensibles. Les données d’exécution, les logs, les secrets et les credentials doivent rester séparés de la définition du workflow. Sinon, un dépôt Git devient vite une fuite de sécurité très proprement organisée.
Voici un exemple simplifié d’export n8n. Le JSON pur ne supporte pas les commentaires, donc je les mets autour du code, pas dedans. Ici, on voit surtout les nœuds, les paramètres et la connexion entre eux.
{
  "name": "Exemple Slack Alert",
  "nodes": [
    {
      "id": "1",
      "name": "Webhook",
      "type": "n8n-nodes-base.webhook",
      "parameters": {
        "path": "new-lead",
        "method": "POST"
      }
    },
    {
      "id": "2",
      "name": "Send Slack Message",
      "type": "n8n-nodes-base.slack",
      "parameters": {
        "channel": "#sales",
        "text": "Nouveau lead reçu"
      }
    }
  ],
  "connections": {
    "Webhook": {
      "main": [
        [
          {
            "node": "Send Slack Message",
            "type": "main",
            "index": 0
          }
        ]
      ]
    }
  }
}
Dans un vrai projet, j’ajoute un fichier .gitignore. C’est le fichier qui dit à Git quoi ignorer. C’est basique, mais ça évite pas mal de bêtises. J’ai déjà vu un client pousser un export complet avec des credentials dedans, juste avant une mise en prod. Ambiance.
.env
.env.local
credentials.json
credentials/
executions/
logs/
*.sqlite
*.db
exports-sensitive/
n8n-backup-*.json
Les commandes Git utiles restent simples au début. Je les utilise surtout pour vérifier ce que je suis en train de versionner avant de figer un changement.
| Commande | Usage |
| git init | Crée un dépôt Git dans le dossier courant. |
| git status | Montre les fichiers modifiés, ajoutés ou non suivis. |
| git add workflow.json | Prépare un fichier pour le prochain commit. |
| git commit -m « Ajoute alerte Slack lead » | Enregistre une version avec un message clair. |
| git log | Affiche l’historique des commits. |
| git diff | Montre exactement ce qui a changé. |
Quand la fonctionnalité Source Control de n8n est disponible, c’est encore plus propre. Le flux push/pull avec Git permet de synchroniser les changements entre n8n et le dépôt sans bricoler des exports à la main.
Ma règle simple : si je ne peux pas expliquer un commit en une phrase claire, le changement est probablement trop large.
Quelles branches pour dev staging prod ?
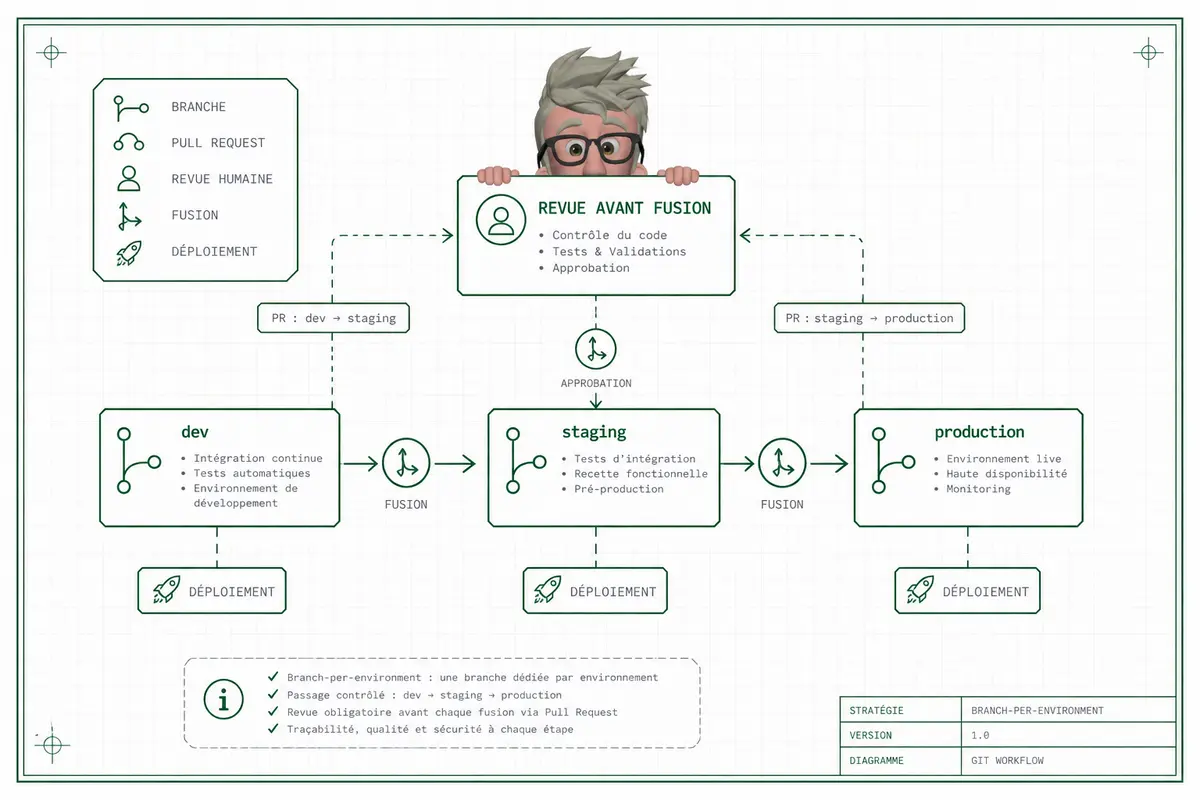
J’utilise des branches Git pour représenter des états maîtrisés du même workflow, par exemple développement, staging et production. L’idée est simple. On teste en développement, on valide en staging, puis on publie en production seulement quand le comportement est approuvé. Pas avant.
Dans n8n, ça évite un piège classique que j’ai vu chez plusieurs clients : quelqu’un corrige “vite fait” un workflow en prod, personne ne sait exactement ce qui a changé, et deux semaines plus tard on n’ose plus toucher au scénario. Git sert justement à garder une trace claire.
Le mécanisme reste basique. On pousse une version validée depuis n8n vers Git avec un commit propre. On récupère une version approuvée depuis Git vers l’environnement cible. Et surtout, on évite les modifications directes non tracées en production. La prod doit refléter ce qui est dans la branche de prod, pas l’inspiration du moment.
Je préfère une stratégie simple, souvent appelée branch-per-environment. Ça veut juste dire une branche par environnement, avec des noms stables partout dans l’organisation :
- Dev pour construire et casser sans stress.
- Staging pour tester dans des conditions proches de la prod.
- Main ou production pour ce qui tourne vraiment.
Le flux concret ressemble à ça. Je modifie en local ou dans l’environnement dev. Je fais un commit descriptif. Je passe par une pull request, c’est-à-dire une revue avant fusion. Je merge vers staging. Je teste. Puis seulement après validation, je merge vers production.
Ces commandes couvrent le quotidien. Elles servent à créer les branches, changer d’environnement Git, fusionner une version validée, puis publier les changements vers le dépôt distant.
# Créer la branche de développement
git checkout -b dev

# Passer sur la branche staging
git switch staging

# Fusionner les changements validés depuis dev
git merge dev

# Envoyer la branche vers le dépôt distant
git push
Quand une version est vraiment stable, j’ajoute un tag ou une release. Un tag, c’est une étiquette figée sur un commit précis, par exemple v1.4.0. Une release ajoute souvent une description plus lisible pour l’équipe. C’est pratique quand on doit revenir à une version connue après un incident.
| Environnement | Rôle | Niveau de risque | Règle de publication |
| Dev | Construire, modifier, tester vite | Faible | Commit fréquent, erreurs acceptées |
| Staging | Valider le comportement avant prod | Moyen | Merge depuis dev après revue |
| Main ou production | Exécuter la version approuvée | Élevé | Merge uniquement après tests validés |
Comment éviter collisions et rollbacks ratés ?
J’évite les collisions et les rollbacks ratés avec des commits courts, des messages lisibles, des revues et une vraie discipline de restauration. C’est simple à dire, mais dans n8n, ça fait une grosse différence, parce qu’un workflow écrasé peut casser une intégration CRM, une alerte Slack ou un traitement de paiement sans prévenir.
Le cas classique, je l’ai vu chez un client : deux personnes modifient le même workflow. L’une ajoute une validation sur un webhook, l’autre corrige un mapping HubSpot. La deuxième sauvegarde après la première, et hop, une partie du travail disparaît. Autre scénario pénible : un changement part en production sans revue, et personne ne voit qu’un trigger actif va relancer 300 exécutions.
À grande échelle, je garde quelques règles très terre à terre :
- Je fais des petites modifications, faciles à relire et faciles à annuler.
- J’écris des messages de commit descriptifs, pas des messages jetables.
- Je sépare les workflows critiques des workflows expérimentaux.
- Je demande une revue avant merge, surtout sur les webhooks, credentials, triggers et mappings.
- Je garde des conventions de nommage claires, par exemple crm_sync_leads ou alert_slack_payment_failed.
- Je mets une documentation minimale dans le dépôt : objectif du workflow, dépendances, variables, points sensibles.
Un bon message de commit dit ce qui change vraiment :
- fix mapping CRM lead source
- add retry on Slack alert
- update webhook validation
Un mauvais message ne sert à rien quand il faut revenir en arrière à 2h du matin :
- update
- test
- final
- corrections
Quand je dois revenir en arrière, ces commandes suffisent dans 90% des cas. Elles servent à retrouver, comparer, annuler ou récupérer une version précise.
git log
# Retrouver l’historique des commits

git diff
# Comparer les changements en cours

git revert <commit_id>
# Annuler proprement un commit en créant un nouveau commit inverse

git checkout <commit_id> -- workflows/crm_sync.json
# Récupérer un fichier depuis une ancienne version

git restore workflows/crm_sync.json
# Annuler les modifications locales sur un fichier
La différence importante : git revert annule sans réécrire l’historique, donc c’est propre pour une branche partagée. Git reset déplace l’historique, donc je l’utilise avec beaucoup plus de prudence, surtout si d’autres personnes ont déjà récupéré la branche.
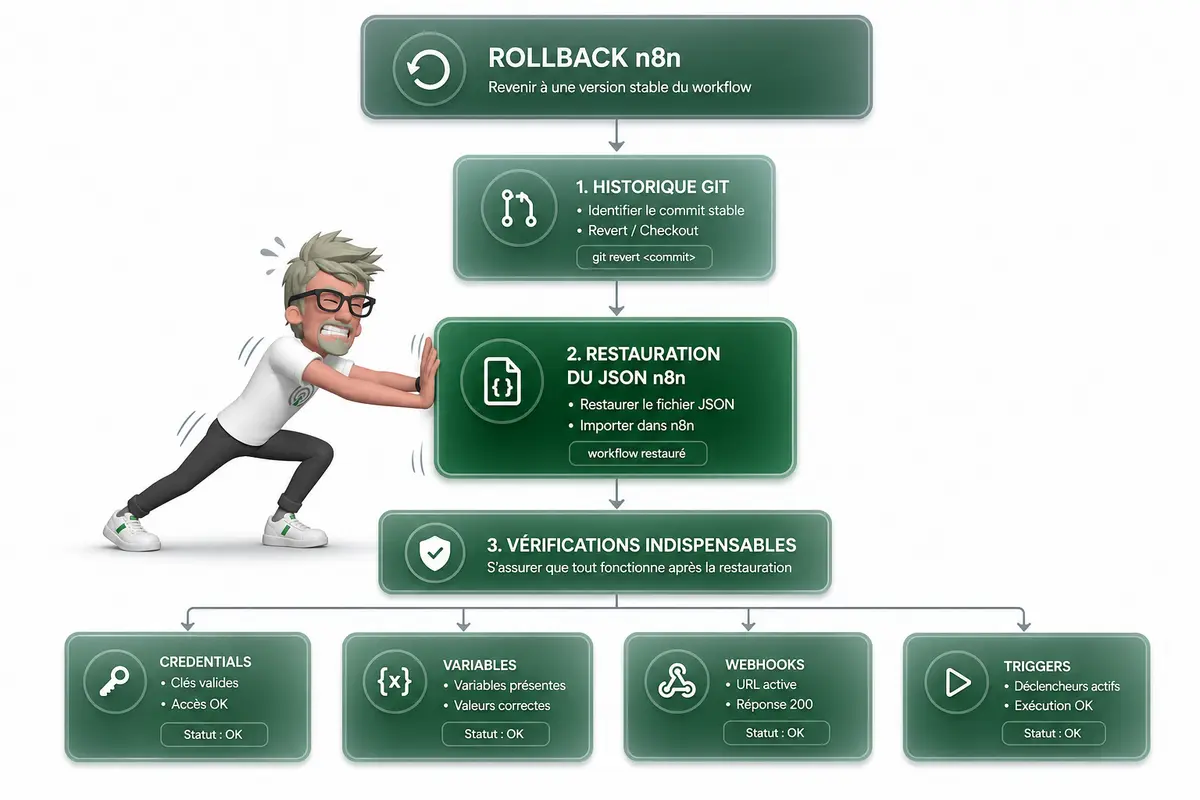
Pour n8n, restaurer le JSON du workflow ne suffit pas toujours. Je vérifie aussi les credentials, les variables d’environnement, les webhooks, les triggers actifs et les exécutions en attente. Sinon on croit avoir rollback, mais la prod reste bancale.
- Le bon fichier de workflow a été restauré et redéployé.
- Les credentials attendus sont présents et valides.
- Les variables d’environnement utilisées par le workflow existent encore.
- Les webhooks pointent vers la bonne URL.
- Les triggers nécessaires sont actifs, et les mauvais triggers sont désactivés.
- Les exécutions en attente ont été vérifiées ou purgées si besoin.
- Un test réel a été lancé avec une donnée maîtrisée.
- L’incident est documenté avec le commit restauré et la cause probable.
Que change Temporal dans la comparaison ?
Temporal ne versionne pas les workflows de la même façon que n8n, parce qu’il gère aussi des workflows en cours d’exécution et leur rejouabilité.
Dans n8n, je versionne surtout une définition de workflow. C’est une configuration avec des nodes, des connexions, des paramètres, parfois des credentials référencés. Le besoin est assez concret : je veux savoir quelle version est publiée, comparer deux définitions, revenir en arrière si une modification casse une automatisation.
Temporal joue dans une autre catégorie. Un workflow Temporal peut tourner longtemps, parfois plusieurs jours, semaines ou mois. Et Temporal doit pouvoir le rejouer. Le replay, c’est le fait de relire l’historique d’une exécution pour reconstruire son état. Pour que ça marche, le code du workflow doit rester déterministe. Ça veut dire qu’avec le même historique, il doit reprendre les mêmes décisions.
C’est là que la comparaison devient intéressante, mais aussi limitée. Dans Temporal, changer le code d’un workflow déjà en cours peut casser le replay si le nouveau code ne correspond plus aux anciens événements. Temporal propose des mécanismes comme le patching et GetVersion. GetVersion permet de dire, en gros : pour les anciennes exécutions, garde l’ancien comportement, pour les nouvelles, utilise le nouveau. C’est une manière de faire cohabiter plusieurs chemins de code sans casser ce qui tourne déjà.
Dans n8n, je n’ai généralement pas ce problème au même niveau. Une exécution n8n est souvent courte. Le vrai risque, c’est plutôt de modifier un workflow publié, de casser une intégration, ou de ne plus savoir quelle version fonctionnait hier. J’ai déjà vu ça chez un client : un petit changement dans un node HTTP, aucune trace propre, et deux heures perdues à comprendre pourquoi les commandes ne partaient plus.
La bonne leçon à garder, ce n’est pas de copier Temporal dans n8n. Ce serait trop lourd. La vraie idée, c’est celle-ci : chaque changement doit rester compatible avec l’existant, ou alors il doit être isolé. Dans n8n, ça peut vouloir dire dupliquer un workflow avant une grosse refonte, tester sur une version non publiée, garder un export propre, et documenter ce qui change vraiment.
| Critère | n8n | Temporal |
| Objet versionné | Définition du workflow, configuration des nodes, connexions et paramètres. | Code du workflow, logique métier et comportement dans le temps. |
| Risque principal | Publier une mauvaise version ou perdre une définition qui fonctionnait. | Casser le replay d’une exécution longue déjà démarrée. |
| Mécanisme typique | Exports JSON, duplication, historique Git, workflow publié ou non publié. | Replay, patching, GetVersion, compatibilité entre ancien et nouveau code. |
| Usage recommandé | Tracer les versions publiées et pouvoir revenir vite à une définition stable. | Faire évoluer le code sans casser les exécutions déjà en cours. |
Et si vos workflows n8n devenaient enfin maintenables ?
Le n8n workflow versioning, ce n’est pas une couche de confort. C’est ce qui transforme une automatisation fragile en système maintenable. Je garde un historique clair, je compare les changements, je sépare dev, staging et production, et je peux revenir en arrière sans bricoler dans l’urgence. Git apporte la structure, les branches évitent le mélange des environnements, les commits racontent ce qui s’est passé. Temporal rappelle juste une chose utile : versionner, c’est aussi respecter ce qui tourne déjà. Le bénéfice pour vous est simple : moins de régressions, moins de stress, plus de contrôle sur vos automatisations business.
FAQ
- Pourquoi utiliser Git avec n8n ?
Git permet de garder un historique fiable des changements faits sur les workflows n8n. Je peux comparer deux versions, comprendre qui a modifié quoi, revenir à un état stable et éviter les modifications invisibles en production. - Est-ce que les credentials n8n doivent être stockés dans Git ?
Non. Les secrets, tokens, mots de passe et clés API doivent rester séparés du dépôt Git. Le versioning doit porter sur la définition du workflow, pas sur les informations sensibles. - Quelle stratégie de branches utiliser pour n8n ?
La stratégie la plus simple consiste à séparer les environnements avec des branches comme dev, staging et production. Je teste en dev, je valide en staging, puis je publie seulement une version approuvée en production. - Comment revenir à une ancienne version d’un workflow n8n ?
Je retrouve la version avec git log, je compare avec git diff, puis je restaure proprement avec git revert ou une récupération ciblée du fichier. Après ça, je vérifie les triggers, credentials, variables et webhooks avant de relancer. - Quelle différence entre n8n et Temporal sur le versioning ?
n8n versionne surtout des définitions de workflows d’automatisation. Temporal gère aussi la compatibilité des workflows déjà en cours d’exécution via des mécanismes comme le replay, le patching et GetVersion. Les deux sujets se rejoignent sur la fiabilité, mais ils ne répondent pas au même problème technique.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent fiabiliser leurs automatisations, leurs données et leurs process sans empiler du bricolage. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer vos workflows n8n, votre tracking ou vos projets IA, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.