

Pas complètement. L’IA aurait construit une singularité en temps fini pour Navier-Stokes 3D avec force extérieure lisse, mais le grand problème sans force reste ouvert. Ce qui m’intéresse ici, c’est moins l’annonce que la méthode derrière : humains, preuve formelle, agents IA, industrialisation.
Qu’est-ce que l’IA aurait vraiment résolu ?
L’IA n’a pas résolu toute la conjecture Navier-Stokes, elle aurait proposé une construction de singularité en temps fini pour les équations tridimensionnelles avec une force extérieure lisse.
C’est une nuance énorme. Le problème du millénaire posé par le Clay Mathematics Institute, c’est l’existence et la régularité des solutions des équations de Navier-Stokes en 3D. Dit simplement : si on part d’un fluide bien décrit au départ, est-ce que les équations donnent toujours une solution propre, sans explosion, pour tous les temps ? Ou est-ce qu’un comportement incontrôlable peut apparaître ?
Ici, le périmètre annoncé semble différent. On parle d’un système avec une force extérieure lisse. Une force extérieure, c’est une action ajoutée au fluide, comme si on poussait le système depuis l’extérieur. Lisse veut dire qu’elle n’est pas brutale ou irrégulière mathématiquement. Ça reste sérieux, mais ce n’est pas exactement le problème le plus connu, celui sans force extérieure, qui reste non tranché.
Formez-vous à l'IA Générative !
Exploiter l'IA générative et le prompt engineering est désormais indispensable pour automatiser vos tâches, accélérer votre création de contenu et booster votre productivité au quotidien... Passez à la vitesse supérieure avec nos formations IA Générative.
Une singularité, dans ce contexte, ce n’est pas un trou noir ou un mot magique. C’est un moment où certaines quantités deviennent incontrôlables en temps fini. Par exemple, la vitesse ou ses variations peuvent devenir trop grandes pour que la solution reste régulière. Pour la dynamique des fluides, ça compte, parce que Navier-Stokes est au cœur de la manière dont on modélise l’air, l’eau, les turbulences, les écoulements industriels. Mais ça ne veut pas dire qu’on vient de débloquer demain matin toute la météo, l’aéronautique ou la simulation des océans.
Je reste prudent. Une annonce mathématique de ce niveau doit être relue, vérifiée, formalisée, ou au minimum validée par des spécialistes. J’ai souvent vu en IA des annonces très fortes où le détail du périmètre change tout, et ici le périmètre est précisément le sujet.
| Cas | Statut | Enjeu mathématique |
| Équations 3D avec force extérieure lisse | Construction annoncée, à vérifier par la communauté | Montrer qu’une singularité peut apparaître dans un cadre forcé |
| Équations 3D sans force extérieure | Problème ouvert | Résoudre le problème du millénaire existence et régularité |
| Validation scientifique | Non automatique, même avec l’IA | Relire les preuves, vérifier les hypothèses, formaliser les arguments |
Pourquoi les humains restent-ils centraux ?
Les humains restent centraux parce que l’IA ne part pas de zéro. Elle s’appuie sur un terrain mathématique déjà préparé par des chercheurs, avec des années de définitions, d’intuitions, de contre-exemples, de méthodes analytiques et de preuves partielles. Dans un sujet aussi dur que Navier-Stokes, ça compte énormément.
Tristan Buckmaster, par exemple, a travaillé sur des problèmes très proches en dynamique des fluides, notamment autour des équations d’Euler et de Navier-Stokes. Ses travaux touchent à des constructions analytiques fines, à la régularité, aux solutions faibles, à ces zones où les équations peuvent avoir des comportements très contre-intuitifs. Levent Alpöge, lui, est aussi associé à ce mouvement où les mathématiques avancées rencontrent la formalisation, avec un intérêt pour la vérification rigoureuse d’arguments complexes. Le point important, c’est que ces chercheurs ne donnent pas juste une “idée vague” à une machine. Ils structurent le problème.
Lean entre ici comme un assistant de preuve. Pas comme une baguette magique. Lean ne “comprend” pas les maths comme un humain qui a passé dix ans sur un domaine. Il vérifie la cohérence logique d’un raisonnement quand les définitions, les lemmes, c’est-à-dire les petits résultats intermédiaires, et les preuves sont correctement encodés. Si on encode mal, Lean peut valider quelque chose de formellement cohérent mais inutile. C’est très puissant, mais c’est exigeant.
Le lien avec l’IA est assez simple. Les modèles peuvent proposer des pistes, repérer des structures, accélérer l’exploration, parfois retrouver des chemins qu’un humain n’aurait pas testés tout de suite. Mais il faut encore cadrer le problème, choisir les bonnes représentations, éliminer les fausses pistes et vérifier. Ce n’est pas l’IA contre les mathématiciens. C’est plutôt une extension de l’atelier de recherche.
Je le vois aussi dans les projets data et IA en entreprise. Le gain arrive rarement quand on remplace les experts. Il arrive quand on leur donne de meilleurs outils, plus rapides, plus précis, moins fatigants.
- Le mathématicien : Pose le problème, choisit les hypothèses, construit l’intuition, juge si une piste a du sens.
- L’IA : Propose des directions, explore des combinaisons, accélère la recherche de structures et d’arguments possibles.
- L’assistant de preuve : Vérifie la cohérence logique des définitions, des lemmes et des preuves formalisées.
Comment OpenAI a-t-elle changé l’échelle ?
OpenAI n’aurait pas “juste” eu une meilleure idée. OpenAI aurait surtout changé l’échelle du problème. L’idée, c’est de faire travailler environ 10 000 agents IA en parallèle, un peu comme une immense équipe de chercheurs concurrents, mais organisés en groupes spécialisés.
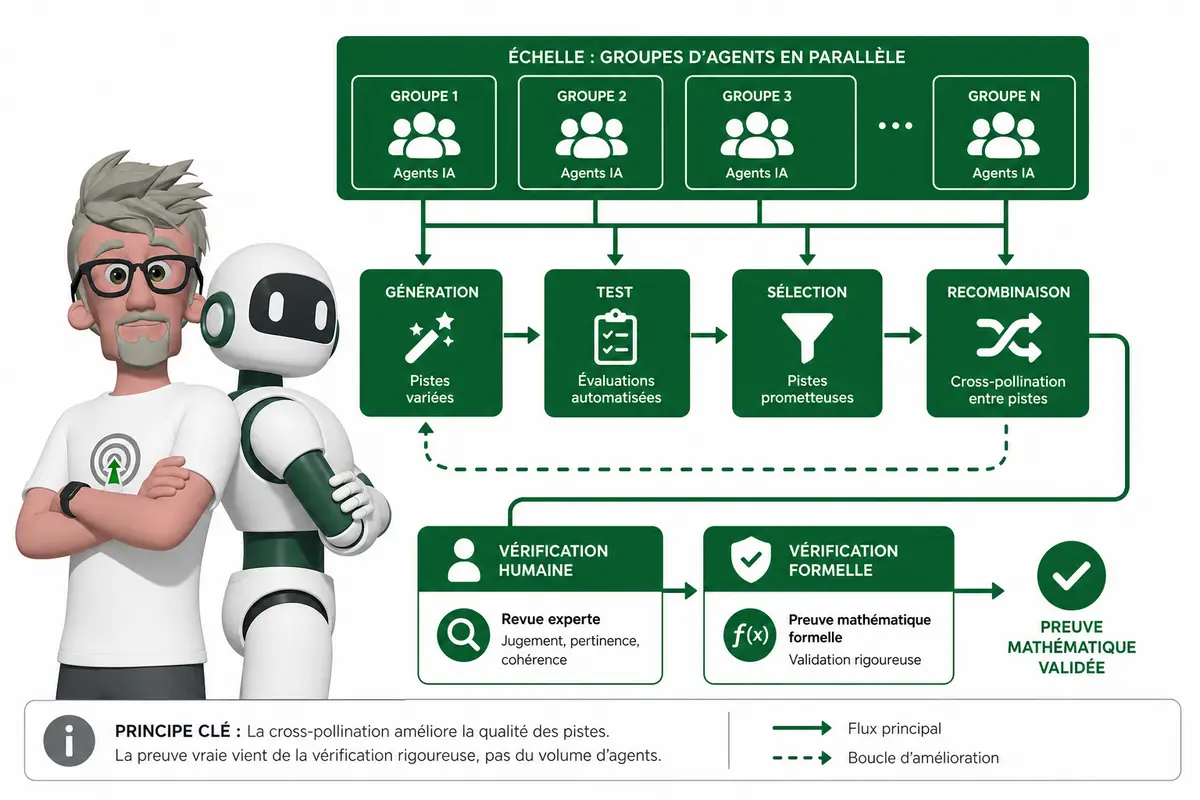
Concrètement, ça veut dire quoi ? Des agents explorent des pistes différentes. Certains testent des constructions mathématiques. D’autres cherchent des contre-exemples. D’autres reformulent une preuve partielle, ou essayent de recoller deux idées qui ne venaient pas du même endroit. Les résultats intermédiaires circulent. Une piste faible dans un groupe peut devenir utile dans un autre. C’est ça, la cross-pollination. Une idée pas suffisante seule peut déclencher quelque chose ailleurs.
Je vois souvent la même logique en automatisation low code ou dans des workflows IA. Quand on découpe un gros problème en petites tâches, qu’on trace ce qui marche, qu’on garde les sorties intéressantes et qu’on boucle vite, on augmente le nombre d’essais utiles. Pas le nombre d’essais au hasard. Le volume devient intéressant parce qu’il est structuré.
| Étape | Rôle des agents | Risque | Garde-fou |
| Génération | Proposer des pistes, des lemmes, des constructions | Produire beaucoup de bruit convaincant | Limiter le périmètre et garder les traces |
| Sélection | Repérer les idées qui semblent prometteuses | Favoriser une piste élégante mais fausse | Comparer plusieurs critères, pas juste la beauté |
| Vérification | Tester la solidité logique des résultats | Confondre plausibilité et preuve | Faire relire par des outils formels et des humains |
Le point important, c’est que plus d’agents ne garantit pas une preuve vraie. Ça augmente l’exploration, pas la certitude. Générer, c’est produire des idées. Sélectionner, c’est choisir celles qui méritent du temps. Vérifier, c’est établir qu’elles tiennent vraiment. Sur Navier-Stokes, cette dernière marche reste la plus dure.
Et c’est là que la suite devient sensible. Quand une machine explore autant, mélange autant de fragments, réutilise autant de résultats intermédiaires, une question arrive très vite : d’où viennent les idées, les données, les preuves partielles ? La provenance devient critique.
D’où vient la controverse sur les données ?
La controverse vient d’une question simple : est-ce que l’IA a pu bénéficier de travaux non publiés, ou de données issues des recherches de Buckmaster et Alpöge ? C’est vraiment le cœur du sujet. Pas “est-ce que l’IA est magique ?”, pas “est-ce qu’elle a volé une preuve ?”. Juste une question de provenance.
La position attribuée à OpenAI est claire : l’organisation affirme ne pas avoir utilisé ces travaux non publiés. Il faut le dire proprement, sans transformer ça en accusation. À ce stade, le point intéressant n’est pas de juger à la place des chercheurs ou des équipes IA, c’est de comprendre pourquoi cette question met tout le monde sur les nerfs.
En recherche mathématique, la valeur ne se trouve pas seulement dans le résultat final. Elle est aussi dans les intuitions, les brouillons, les notations, les chemins abandonnés, les essais intermédiaires. Parfois, une formulation un peu bizarre dans un carnet vaut presque autant qu’un théorème publié, parce qu’elle ouvre une porte. En IA, c’est pareil. Un jeu de données, un choix de formalisation, une manière de découper le problème, un prompt de recherche bien construit, ça peut orienter fortement le modèle.
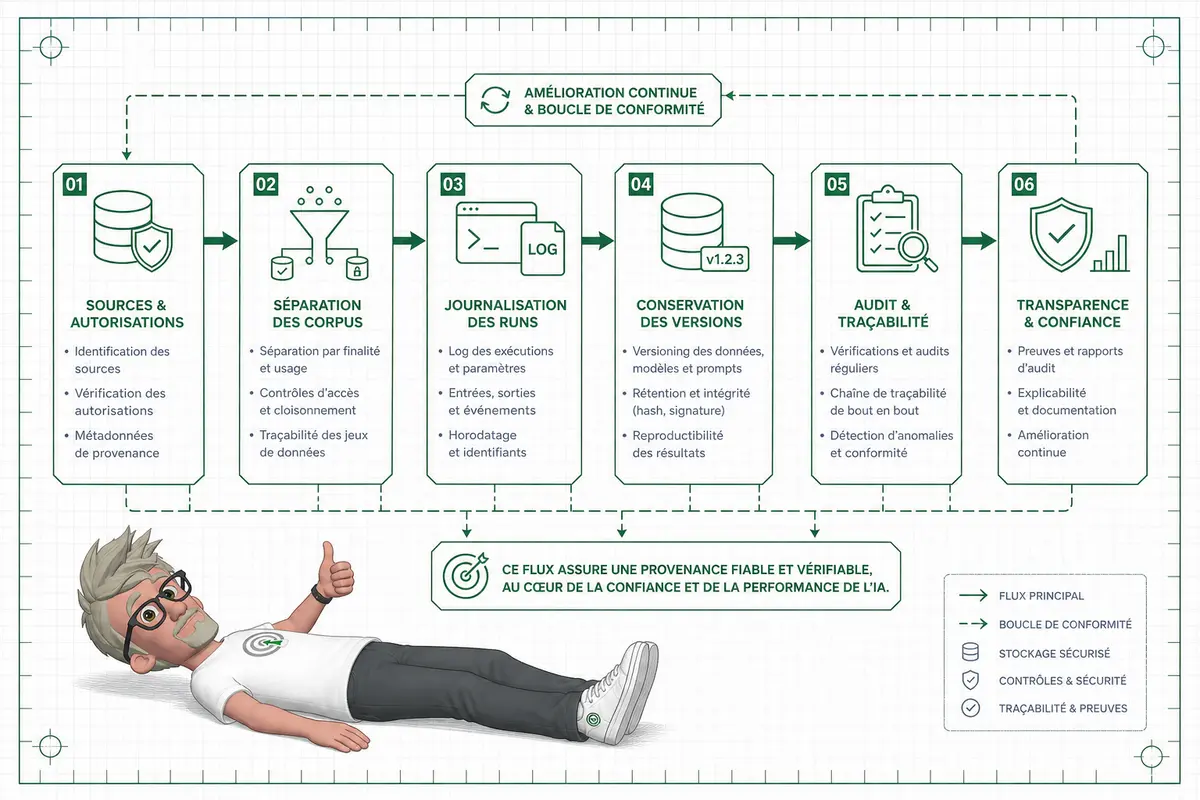
C’est là que la gouvernance IA devient très concrète. Il faut savoir d’où viennent les données, ce qui a été autorisé, ce qui ne l’a pas été, quels runs ont été lancés, avec quels paramètres, quels prompts, quels documents, quelles versions. Un run, c’est une exécution d’entraînement ou d’expérimentation. Si personne ne garde la trace, on se retrouve vite avec une zone grise. Et les zones grises, en R&D, ça finit souvent en conflit.
Je le vois souvent en entreprise. Les problèmes d’IA ne viennent pas toujours du modèle. Très souvent, ils viennent du flou sur ce qu’on a le droit d’utiliser. Un fichier partagé “juste pour tester”, une base client copiée trop vite, une note interne injectée dans un outil externe. Le risque naît rarement d’une mauvaise intention. Il naît du manque de cadre.
- Tenir un registre des sources avec l’origine, la licence, le propriétaire et les droits d’usage de chaque document ou dataset.
- Séparer les corpus autorisés et non autorisés pour éviter qu’un fichier sensible se retrouve dans un entraînement ou un test.
- Journaliser les runs avec la date, le modèle, les paramètres, les prompts, les données utilisées et les résultats produits.
- Documenter les prompts de recherche surtout quand ils contiennent des hypothèses, des notes internes ou des pistes non publiées.
- Auditer régulièrement les sources pour vérifier que les données utilisées correspondent bien aux autorisations obtenues.
- Conserver les versions des datasets, scripts, notebooks et configurations pour reconstruire une expérience si besoin.
- Définir une règle simple avant le projet : ce qui est public, ce qui est interne, ce qui est confidentiel, et ce qui est interdit.
Que faut-il retenir pour la recherche et le business ?
Je retiens surtout une chose : l’IA n’a pas “résolu” Navier-Stokes au sens magique du terme. Elle a montré qu’elle pouvait devenir une infrastructure de recherche massive, capable d’explorer, proposer, critiquer, formaliser et accélérer une partie du travail scientifique. Mais elle ne remplace pas la validation. Elle ne remplace pas les mathématiciens. Elle ne remplace pas la gouvernance.
La portée exacte de l’annonce est là. On n’est pas face à une vérité scientifique tombée du ciel. On est face à un système qui combine plusieurs briques : des modèles d’IA, des agents concurrents, des humains capables de juger, et parfois une preuve formelle avec Lean. Lean, c’est un assistant de preuve. En gros, il oblige à écrire un raisonnement mathématique dans un langage que la machine peut vérifier ligne par ligne. C’est très puissant, mais ça demande encore un énorme travail de traduction, de rigueur et de supervision.
Ce point est important, parce qu’il évite deux erreurs classiques. La première, c’est de croire que le modèle “comprend” tout et qu’on peut lui faire confiance les yeux fermés. La deuxième, c’est de rejeter le résultat parce qu’il y a eu de l’IA dans la boucle. La bonne question, c’est plutôt : quel système a produit ce résultat, avec quelles sources, quels contrôles, quels logs, quelles validations ?
Pour le business, je vois la même logique. L’avantage ne vient pas juste du modèle. Il vient du système autour du modèle. Les agents, les workflows, les critères de sélection, la validation humaine, l’audit, la qualité des données, tout ça compte autant que le modèle lui-même. J’ai vu ça chez des clients : deux équipes utilisent le même LLM, l’une gagne du temps, l’autre produit du bruit. La différence, c’est rarement le prompt magique. C’est le process.
Un exemple simple : une équipe R&D peut automatiser sa veille scientifique, extraire des hypothèses, les faire scorer par plusieurs agents spécialisés, puis demander à un expert de valider les meilleures. Là, l’IA ne décide pas toute seule. Elle prépare le terrain, elle réduit le volume, elle force la comparaison, elle garde une trace.
| Leçon côté Navier-Stokes | Pratique concrète en entreprise |
| Une annonce doit être bornée précisément | Définir ce que l’IA a le droit de produire, recommander ou décider |
| Les mathématiciens restent indispensables | Garder des experts métier dans la boucle de validation |
| Lean vérifie le raisonnement formel | Mettre des contrôles automatiques, des tests et des règles qualité |
| Les agents concurrents explorent plusieurs pistes | Faire scorer une idée par plusieurs agents avec des rôles différents |
| Les données peuvent créer une controverse | Tracer les sources, vérifier les droits, mesurer la qualité des corpus |
| Le système compte plus que le modèle isolé | Construire des workflows auditables avec logs, critères et validation humaine |
Alors, on parle d’une preuve ou d’un nouveau modèle de recherche ?
Je retiens surtout une chose : l’annonce est forte, mais elle ne ferme pas le dossier Navier-Stokes. Le cas avec force extérieure lisse n’est pas le grand problème sans force que beaucoup ont en tête. La partie vraiment intéressante, c’est la façon de travailler : des mathématiciens qui préparent le terrain, des assistants de preuve comme Lean, des milliers d’agents IA qui explorent en parallèle, et une exigence énorme sur la traçabilité. Pour vous, le bénéfice est clair : mieux comprendre ce que l’IA peut vraiment accélérer, sans confondre vitesse d’exploration et validation finale.
FAQ
- L’IA a-t-elle vraiment résolu le problème Navier-Stokes ?
Pas dans sa version la plus connue. L’annonce porte sur une singularité en temps fini pour les équations de Navier-Stokes 3D avec une force extérieure lisse. Le problème sans force extérieure, celui que beaucoup associent au problème du millénaire, reste ouvert. - Pourquoi la force extérieure change-t-elle autant le sujet ?
Parce qu’elle modifie le cadre mathématique. Une solution ou une singularité construite avec une force extérieure ne répond pas automatiquement au cas sans force. En maths, le périmètre exact compte énormément. Une petite condition peut changer complètement la portée du résultat. - Quel rôle joue Lean dans ce type de recherche ?
Lean sert à formaliser et vérifier des preuves mathématiques. Il ne remplace pas l’idée mathématique, mais il peut aider à contrôler la logique d’une démonstration quand les définitions et les étapes sont correctement encodées. C’est un garde-fou puissant, pas un bouton magique. - Pourquoi parle-t-on de milliers d’agents IA ?
L’intérêt est l’exploration massive. Des agents peuvent tester plusieurs pistes, partager des résultats intermédiaires, recombiner des idées et éliminer plus vite les impasses. Mais ça ne prouve rien tout seul. La vérification reste indispensable. - Que peut retenir une entreprise de cette histoire ?
Le vrai levier, ce n’est pas juste d’utiliser un modèle IA. C’est de construire un système autour : données propres, agents spécialisés, validation humaine, logs, audit et critères de décision. C’est là que l’IA devient utile pour le business, pas dans le buzz.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent utiliser l’IA sérieusement, avec des workflows propres, des données traçables et des résultats vérifiables. J’ai travaillé pour des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer vos projets IA, data ou automatisation, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.