

L’Agentic Context Engineering améliore un agent IA sans réentraîner le modèle. Il apprend en gardant des leçons courtes dans un playbook, puis les réutilise. Le vrai sujet, c’est simple : comment faire progresser un agent sans casser ce qu’il sait déjà faire.
Qu’est-ce que l’Agentic Context Engineering ?
L’Agentic Context Engineering, ou ACE, est une méthode qui permet à un agent IA de s’améliorer en éditant son contexte, pas les poids du modèle.
Dit plus simplement, je ne touche pas au cerveau profond du modèle. Je ne relance pas un entraînement coûteux. Je donne à l’agent un espace de mémoire propre, structuré, qu’il peut mettre à jour après une tâche, une erreur, ou une bonne décision.
Cet espace, on peut l’appeler un playbook. C’est une sorte de carnet de bord opérationnel. Il contient des entrées courtes, nommées, faciles à réutiliser. Par exemple : “Quand l’API renvoie une erreur 429, attendre puis relancer”, ou “Pour ce client, toujours vérifier le champ TVA avant de générer la facture”. Rien de magique. Juste des leçons utiles, écrites dans un format que l’agent peut relire et appliquer plus tard.
Le point important, surtout côté business et technique, c’est qu’on ne parle pas de fine-tuning. Le fine-tuning, c’est quand on réentraîne un modèle avec de nouvelles données pour modifier son comportement interne. Ici, on ne change pas les poids du modèle, c’est-à-dire les paramètres appris pendant son entraînement. On adapte son comportement par le contexte.
Formez-vous à l'IA Générative !
Exploiter l'IA générative et le prompt engineering est désormais indispensable pour automatiser vos tâches, accélérer votre création de contenu et booster votre productivité au quotidien... Passez à la vitesse supérieure avec nos formations IA Générative.
Et ça change pas mal de choses.
- On peut améliorer un agent sans attendre un cycle d’entraînement lourd.
- On peut garder une trace des erreurs fréquentes et éviter de les répéter.
- On peut spécialiser l’agent sur vos process, vos outils, vos règles métier.
- On peut faire évoluer son comportement presque en temps réel.
Je l’ai vu chez des clients qui testaient des agents pour traiter des demandes support ou piloter des workflows internes. Le vrai problème n’était pas que le modèle “ne savait pas”. Le problème, c’est qu’il oubliait les petites règles apprises en route. Avec un playbook, ces règles ne disparaissent pas à chaque nouvelle conversation.
C’est particulièrement utile pour les agents qui utilisent des outils, appellent des API, manipulent des fichiers, prennent des décisions répétées. Ils ont besoin d’apprendre de ce qui vient de se passer, pas seulement de répondre joliment.
Mais il y a un piège. Si on laisse un agent modifier son contexte, il faut le faire proprement. Sinon, il peut écraser des infos utiles, garder de mauvaises conclusions, ou remplir sa mémoire de bruit.
Pourquoi faut-il éditer le contexte avec prudence ?
Il faut éditer le contexte avec prudence parce qu’une mauvaise mise à jour peut supprimer une règle utile, créer du bruit ou rendre l’agent moins fiable. C’est un point simple, mais je l’ai vu casser des agents qui marchaient très bien la veille.
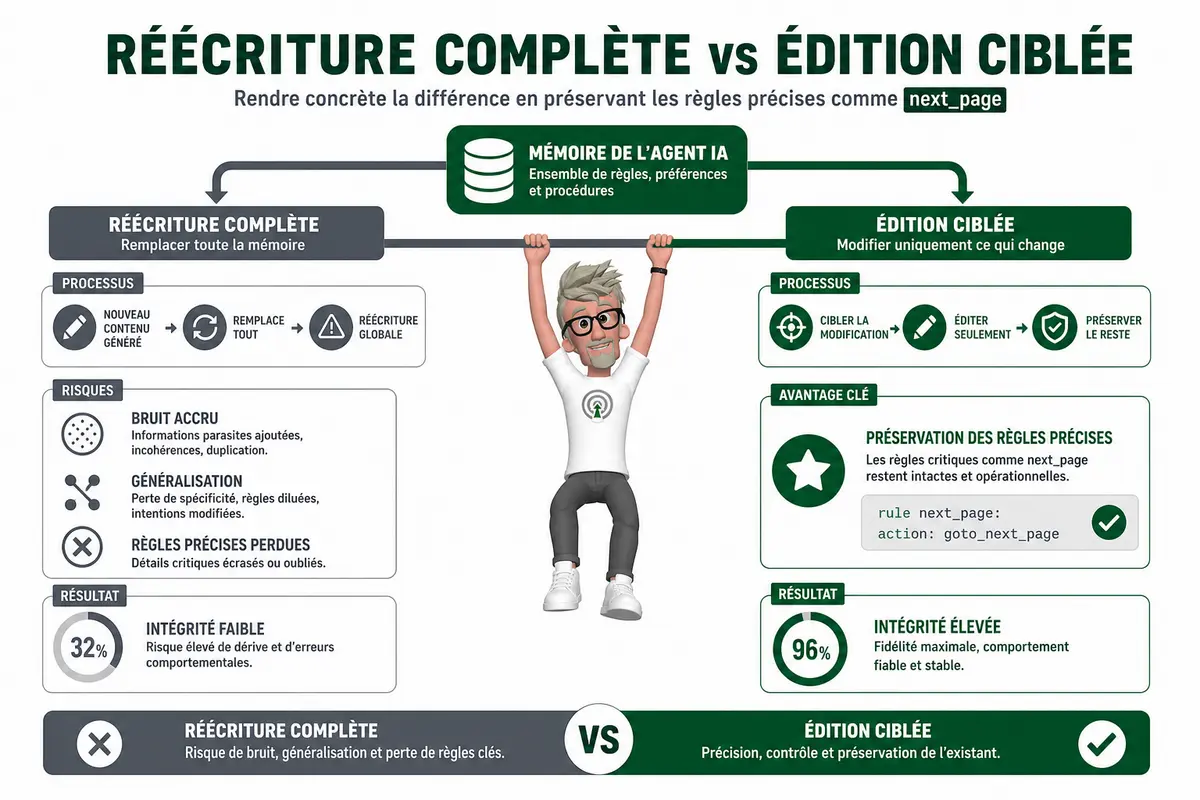
Le piège classique, c’est le système de mémoire qui réécrit tout le contexte après chaque retour utilisateur ou chaque erreur. Sur le papier, ça paraît intelligent. L’agent apprend, il résume, il met à jour sa mémoire. Dans la vraie vie, il peut écraser des informations encore valables, mélanger une exception avec une règle générale, ou remplacer une consigne précise par une phrase molle.
Par exemple, imaginons un agent qui interroge une API avec des résultats paginés. Il apprend une règle importante : Quand la réponse contient un champ next_page, je dois continuer à appeler la page suivante pour ne pas oublier des résultats. C’est clair, actionnable, facile à réutiliser.
Si l’agent réécrit toute sa mémoire après un échec, il peut transformer ça en règle vague du type : Je dois faire attention aux réponses API et vérifier tous les champs utiles. Ça sonne bien, mais ça sert beaucoup moins. Le champ next_page disparaît. La leçon précise disparaît avec lui. Et au prochain appel, l’agent peut oublier la pagination.
La logique ACE, pour Agentic Context Engineering, c’est justement d’éviter ce grand ménage permanent. Je préfère garder des entrées petites, ciblées, faciles à modifier. Une entrée = une leçon précise. Si elle devient obsolète, je la supprime. Si deux entrées disent presque la même chose, je les fusionne. Si elle est encore utile, je la garde telle quelle.
| Réécriture complète | Édition ciblée |
| Peut écraser une règle encore valable. | Préserve les apprentissages utiles. |
| Crée souvent des formulations trop générales. | Garde des règles courtes et concrètes. |
| Ajoute du bruit dans le contexte. | Limite la mémoire à ce qui sert vraiment. |
| Rend l’agent moins prévisible. | Améliore la fiabilité dans le temps. |
Le bon contexte, ce n’est pas une mémoire qui grossit à chaque interaction. C’est plutôt un carnet propre, avec des notes utiles, relues parfois, corrigées quand il faut, mais jamais réécrites sans raison.
Comment fonctionne la boucle ACE ?
ACE fonctionne avec une boucle en trois rôles : Generator, Reflector et Curator. Je le vois comme une équipe miniature autour de l’agent IA. Une partie tente, une partie observe, une partie range ce qui mérite d’être gardé.
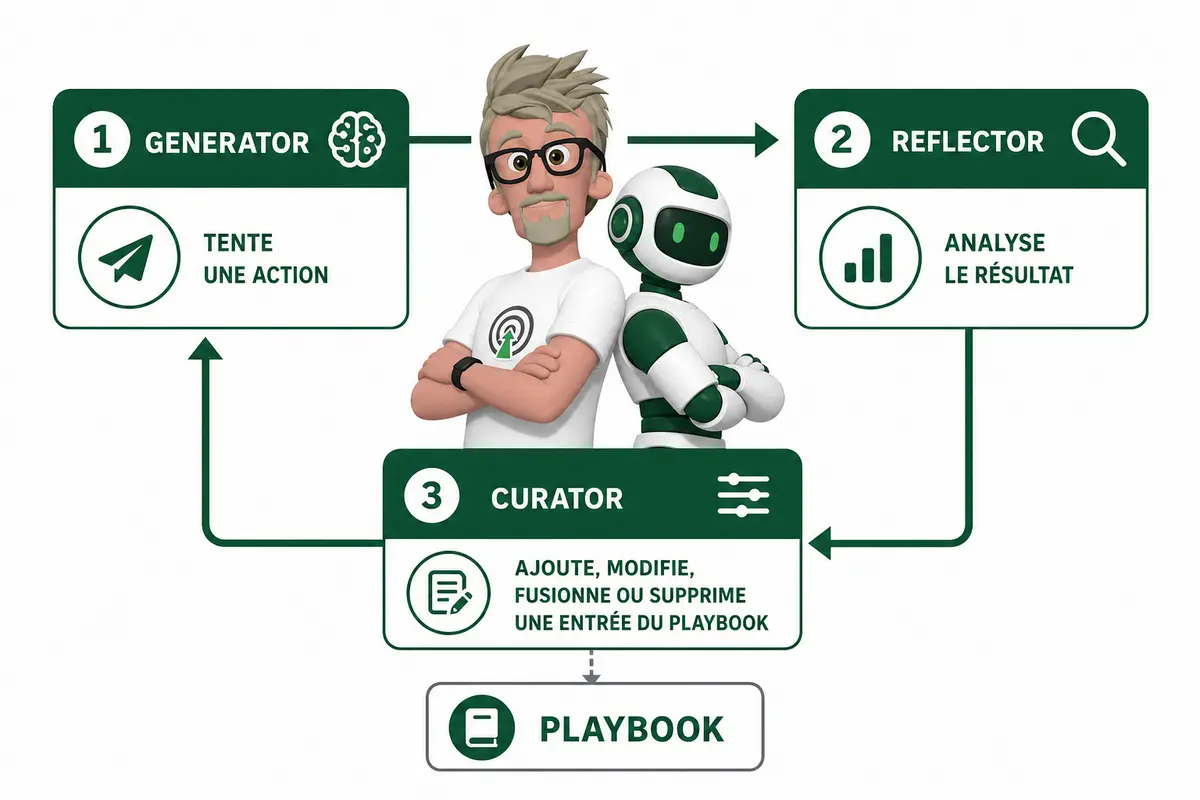
- Generator : C’est la partie qui tente la tâche. Elle produit une réponse, exécute une action, écrit du code, cherche une solution.
- Reflector : C’est la partie qui analyse l’essai. Elle regarde les retours, les erreurs, les blocages, puis elle extrait une leçon utile.
- Curator : C’est la partie qui transforme cette leçon en mise à jour courte, propre et réutilisable dans le playbook.
Le playbook, ici, c’est simplement le contexte de travail de l’agent. Une sorte de carnet de règles, de préférences, d’exemples et de corrections. Pas un nouveau modèle. Pas un réentraînement. Juste une mémoire opérationnelle mieux tenue.
La boucle ressemble à ça dans la vraie vie : l’agent fait une tentative, il reçoit un retour, il comprend ce qui a marché ou pas, puis il met à jour son playbook. Cette mise à jour peut prendre plusieurs formes. Il peut ajouter une nouvelle règle, modifier une consigne existante, fusionner deux règles qui disent presque la même chose, ou supprimer une entrée devenue inutile.
Le point important, c’est que l’agent ne touche pas aux poids du modèle. Les poids, c’est la connaissance interne apprise pendant l’entraînement. ACE améliore plutôt le contexte autour du modèle. C’est de l’amélioration continue par contexte, pas de la magie noire.
J’ai vu ça chez un client sur des prompts d’analyse commerciale. Le vrai saut de qualité n’est pas venu d’un prompt plus long. Il est venu des petites corrections gardées proprement après chaque retour métier.
Mais il y a une limite très simple. Si le feedback est pauvre, flou ou absent, l’agent apprend moins bien. “C’est mauvais” n’aide presque pas. “La réponse oublie les clients inactifs depuis 90 jours” aide beaucoup plus.
Au fond, cette boucle sert à une chose : conserver uniquement ce qui est réutilisable.
Que met-on dans le playbook ACE ?
Le playbook ACE stocke des règles d’usage d’outils, du code réutilisable et des conseils de dépannage. Je le vois comme une mémoire de travail propre, pas comme une poubelle à prompts. Si on met tout dedans, on finit avec un assistant qui lit trop, hésite trop, et applique des consignes dépassées.
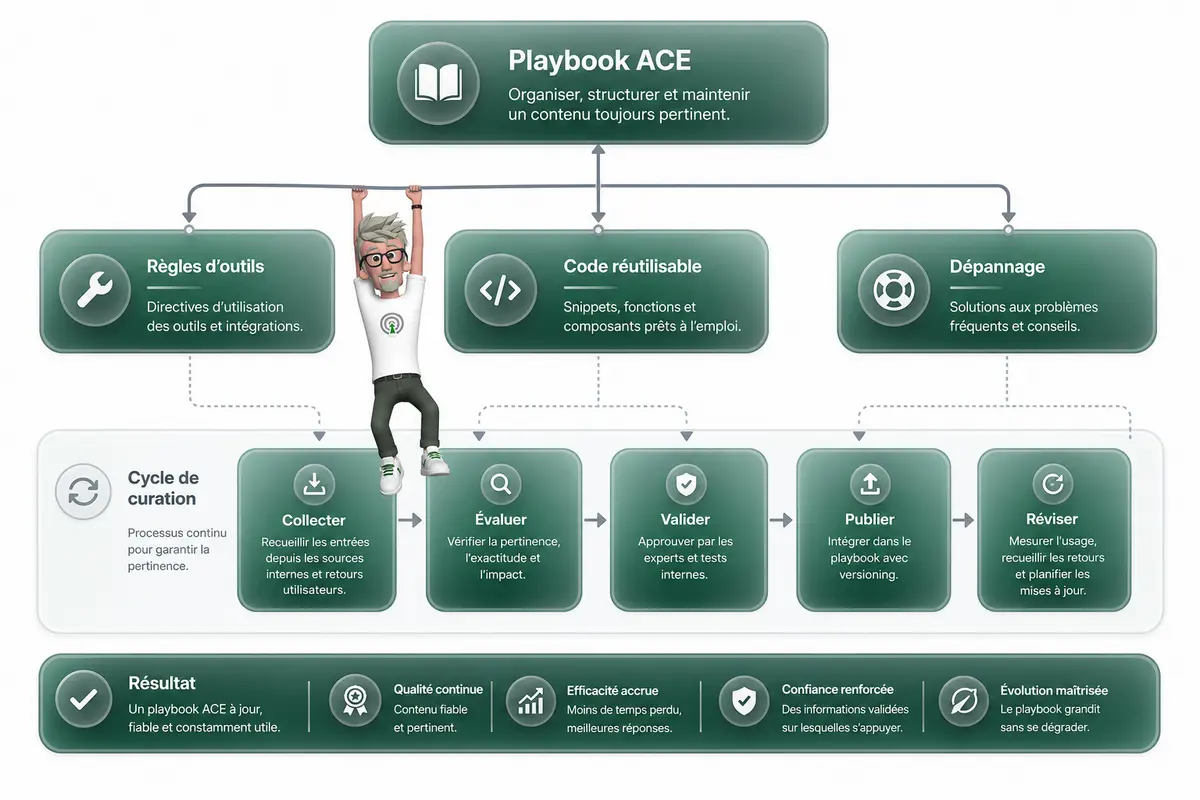
Les règles d’usage d’outils disent à l’agent quand il doit appeler un outil, et surtout quand il ne doit pas oublier de le faire. Ça peut couvrir des cas simples comme “Si une donnée doit être vérifiée, utilise l’outil prévu avant de répondre”. Ça peut aussi préciser comment gérer une réponse paginée, donc une réponse découpée en plusieurs pages. Là, la règle rappelle à l’agent qu’il doit continuer à récupérer les pages suivantes avant de conclure. C’est bête, mais c’est souvent là que les erreurs arrivent.
Le code réutilisable sert à garder des fragments utiles quand ils peuvent resservir sur des tâches proches. Pas besoin d’y stocker tout un projet. L’idée, c’est plutôt de conserver une fonction, une requête, une transformation ou une logique déjà validée. Chez un client, j’ai déjà vu une équipe gagner du temps juste parce qu’elle arrêtait de redemander à l’IA de reconstruire la même logique à chaque ticket.
Le dépannage garde la trace des erreurs rencontrées et des corrections à appliquer la prochaine fois. Si une approche casse, si un outil renvoie un format inattendu, si une étape doit être faite avant une autre, ça mérite parfois une entrée. Pas pour raconter l’histoire. Pour éviter de refaire la même erreur.
| Type d’entrée | Utilité | Risque si mal géré |
| Règles d’outils | Guider l’appel des outils, éviter les oublis, gérer les réponses paginées. | L’agent appelle trop d’outils, ou pas les bons. |
| Code réutilisable | Réutiliser des fragments fiables sur des tâches proches. | Le playbook accumule du code obsolète ou trop spécifique. |
| Dépannage | Capitaliser sur les erreurs et les corrections validées. | L’agent applique une correction hors contexte. |
Une entrée vit comme n’importe quelle connaissance utile. Je l’ajoute quand elle résout un vrai problème. Je la modifie quand le contexte change. Je la fusionne quand deux entrées disent presque la même chose. Je la supprime quand elle n’aide plus.
La contrainte clé, c’est la longueur. Plus le playbook grandit, plus il faut curer. Curer, ça veut dire trier, raccourcir, supprimer. Un bon playbook ACE n’est pas celui qui contient le plus de choses. C’est celui qui garde juste ce qu’il faut pour mieux agir.
Quels résultats donnent les benchmarks ACE ?
Les benchmarks montrent un truc assez clair : ACE améliore les performances dans plusieurs configurations, surtout quand le feedback donné à l’agent est exploitable. C’est là que ça devient intéressant, parce qu’on ne parle pas juste d’ajouter plus de contexte au hasard, mais de construire un contexte qui apprend quoi garder, quoi corriger, et quoi réutiliser.
La différence importante, c’est entre adaptation offline et adaptation online. L’adaptation offline construit le playbook avant le test, à partir d’exemples déjà disponibles. Le playbook, c’est la mémoire opérationnelle de l’agent, une sorte de fiche de bonnes pratiques qu’il va consulter pour mieux agir. L’adaptation online, elle, met à jour ce playbook après une prédiction sur un item. L’agent tente une action, reçoit un signal, puis ajuste son contexte pour les prochaines tâches.
| Mode | Ce qui se passe |
| Offline | Le playbook est préparé avant l’évaluation, avec des exemples et du feedback déjà connus. |
| Online | Le playbook évolue pendant l’évaluation, après chaque prédiction ou interaction utile. |
AppWorld est un des terrains de test mentionnés. C’est un environnement où un agent doit manipuler des applications, suivre des pages, lire des résultats, faire des actions cohérentes. Un exemple parlant : si l’agent oublie de suivre next_page, il peut rater une partie des résultats. ACE peut intégrer ce genre de leçon dans le playbook, du style “quand les résultats sont paginés, continuer avec next_page avant de conclure”. Ça paraît bête, mais dans les tâches agentiques, ce sont souvent ces détails qui font tomber la performance.
Les résultats indiquent aussi qu’ACE fait mieux que GEPA ou Dynamic Cheatsheet dans plusieurs cas. Je reste prudent ici, parce que les écarts dépendent beaucoup de la présence de labels et de la qualité du feedback. Si le signal dit clairement ce qui a échoué, l’agent apprend mieux. Si le feedback est vague, bruité, ou trop pauvre, l’amélioration devient moins stable.
Les tests d’ablation vont dans le même sens. Le système complet surpasse les variantes sans adaptation multi-époque, donc sans plusieurs cycles d’amélioration, et sans Reflector dédié, c’est-à-dire le composant chargé d’analyser les erreurs et de formuler les corrections utiles. Autre observation intéressante : un warmup offline améliore les performances online. En clair, l’agent démarre mieux quand il a déjà un playbook propre avant d’apprendre en direct.
La limite, elle est assez classique. Le contexte peut grossir trop vite. Le feedback peut être faible. Et sans bon signal, l’apprentissage devient moins fiable. J’ai vu le même problème chez des clients avec des agents internes : quand les retours sont flous, l’agent accumule des règles moyennes, parfois contradictoires. ACE aide, oui, mais il ne transforme pas un mauvais feedback en vérité magique.
Alors, ACE change vraiment la façon de faire apprendre un agent ?
Je retiens surtout qu’ACE apporte une idée très pratique : améliorer un agent IA sans toucher aux poids du modèle. Le système apprend en gardant des leçons courtes dans un playbook, puis il les réutilise quand une tâche similaire revient. La boucle Generator, Reflector, Curator donne un cadre propre pour éviter les mises à jour brouillonnes. Les benchmarks montrent des gains, surtout quand le feedback est bon, avec des limites réelles quand le signal manque ou quand le playbook grossit trop. Pour vous, le bénéfice est clair : des agents plus adaptatifs, sans basculer tout de suite dans des entraînements lourds.
FAQ
- Qu’est-ce que l’Agentic Context Engineering ?
L’Agentic Context Engineering est une méthode qui permet à un agent IA de s’améliorer en modifiant son contexte, pas les poids du modèle. L’agent garde des leçons utiles dans un playbook et les réutilise sur des tâches futures similaires. - ACE est-il la même chose qu’un fine-tuning ?
Non. Le fine-tuning modifie les poids du modèle. ACE garde le modèle intact et agit sur le contexte. C’est plus léger, plus rapide à ajuster, mais ça dépend beaucoup de la qualité des règles stockées dans le playbook. - Pourquoi ACE utilise-t-il un playbook ?
Le playbook sert à conserver des leçons courtes, nommées et réutilisables. Ça évite de réécrire tout le contexte à chaque fois, ce qui pourrait supprimer des informations encore utiles ou créer des consignes trop floues. - Quels sont les trois composants de la boucle ACE ?
La boucle repose sur le Generator, qui tente la tâche, le Reflector, qui analyse l’essai et les retours, puis le Curator, qui transforme la leçon en mise à jour concise du playbook. - Quelles sont les limites de l’Agentic Context Engineering ?
ACE fonctionne moins bien quand le feedback est faible ou absent. Le playbook peut aussi devenir trop long, ce qui demande une bonne logique de fusion, de suppression et de curation pour garder un contexte utile.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des équipes comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor sur des sujets data, IA et automatisation très concrets. Si vous voulez rendre vos agents IA plus utiles, mieux suivis et mieux intégrés à vos process business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.