

Je structure les variables Google Tag Manager autour de données stables, de règles déclaratives et de tests ciblés. Le résultat : un conteneur plus clair et plus facile à maintenir. Voici comment cadrer les changements, fiabiliser les correspondances et limiter le JavaScript personnalisé.
Comment cadrer les changements dans GTM ?
Je cadre chaque changement GTM sur un périmètre de test étroit et je consigne le comportement existant avant de modifier le conteneur. Sans référence, il devient difficile de distinguer une régression d’un comportement déjà présent.
Je crée une référence datée qui décrit l’état du conteneur avant intervention. J’inventorie les éléments actifs concernés : variables, déclencheurs et balises. Pour chaque modification, je précise le résultat observable attendu, par exemple la valeur d’une variable ou l’envoi d’un événement dans une situation donnée.
Formez-vous à Google Tag Manager !
Apprenez grâce à nos formations Google Tag Manager une compétence précieuse pour tout professionnel du web. Cet outil permet de simplifier la gestion des balises, de gagner du temps, d'améliorer la précision des données et de personnaliser le suivi des événements. En maîtrisant GTM, vous pouvez optimiser vos campagnes marketing, améliorer les performances de votre site et prendre des décisions basées sur des données fiables et précises.
Je rassemble ces informations dans une spécification partagée, consultable par les personnes qui interviennent. Elle doit permettre de comprendre ce qui change, dans quelles conditions et avec quelles dépendances. J’y documente notamment :
- Le nom et le rôle des variables concernées, ainsi que leur type et leur valeur attendue.
- Les états ou situations testés, avec le résultat observé avant et celui attendu après le changement.
- Les dépendances avec les déclencheurs, les balises ou d’autres variables.
- La personne chargée de la revue et celle qui publie la modification.
- Les personnes qui ont accès au mode Preview, utilisé pour vérifier le comportement avant publication.
- La procédure de retour arrière, avec la version ou la configuration à rétablir si le résultat attendu n’est pas obtenu.
Je vérifie aussi que les variables intégrées activées dans le conteneur sont réellement utilisées. Ces variables sont fournies par GTM et peuvent exposer des informations comme l’URL de la page ou le texte d’un clic. N’activer que celles dont une balise ou un déclencheur a besoin réduit le nombre d’éléments à examiner et constitue une première mesure de maîtrise.
La revue se fait sur le périmètre défini, en comparant les observations du mode Preview au résultat attendu. La publication revient à la personne désignée dans la spécification. Si le comportement diffère, la procédure de retour arrière indique quoi rétablir, sans élargir le changement à d’autres éléments du conteneur.
Comment s’appuyer sur des données stables ?
Je m’appuie d’abord sur les données que l’application fournit : ses événements métier et une couche de données stable. Ce sont les sources qui décrivent le mieux ce qui s’est réellement passé. Reconstituer une information à partir d’un texte affiché ou d’un élément de présentation est plus fragile : une modification de l’interface peut casser le suivi sans que l’action métier ait changé.
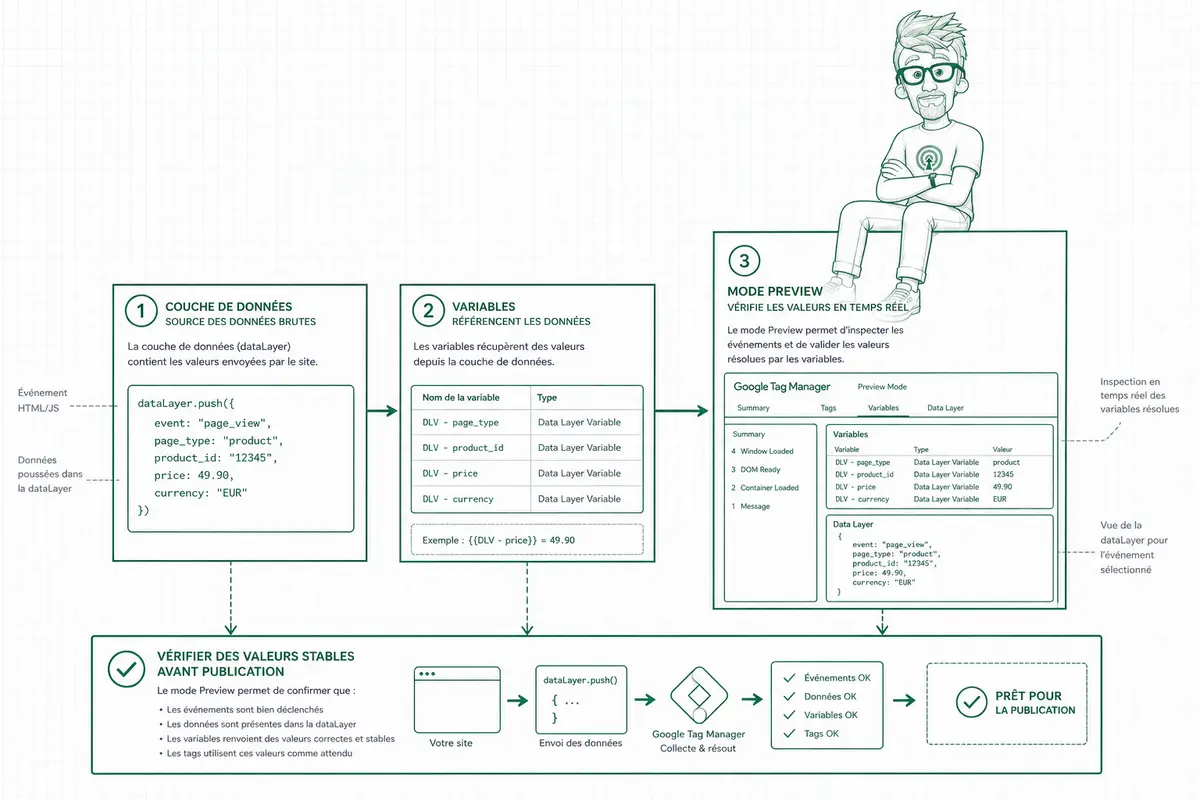
Je nomme chaque variable selon son rôle et sa portée. Le nom doit permettre de comprendre ce qu’elle contient et où elle s’applique, sans devoir ouvrir sa configuration. Je garde la même logique pour les composants associés, notamment les déclencheurs. Une variable liée à une donnée applicative doit refléter cette donnée, pas une interprétation de l’interface.
Je fais correspondre les données de l’application avec les variables de couche de données dans Google Tag Manager. Avant de modifier une variable, je vérifie ce qui en dépend en amont et en aval : d’où vient la valeur, et quels déclencheurs ou balises l’utilisent. Une modification apparemment locale peut avoir des effets sur plusieurs suivis. J’évite donc les changements dont la portée n’est pas claire.
Je travaille dans l’environnement le plus sûr disponible et je traite une couche logique à la fois. Les déclencheurs doivent être précis : ils doivent reconnaître le bon événement, mais aussi prévoir les exclusions nécessaires pour éviter les déclenchements indésirables. C’est le prolongement du cadrage et des tests en mode Preview du chapitre précédent : je vérifie que les données observées correspondent au besoin, puis que chaque déclencheur réagit au bon moment. Si la donnée de référence n’est pas stable ou si ses dépendances restent floues, je clarifie ce point avant de publier.
Quand utiliser des tables de correspondance ?
J’utilise des tables de correspondance et des tables d’expressions régulières pour centraliser les transformations réutilisables et les rendre transparentes. Une table de correspondance associe une valeur connue à une autre, par exemple un nom de catégorie applicatif à une valeur attendue par un outil de mesure. Une table d’expressions régulières transforme des valeurs qui suivent un même motif. Je préfère ces mécanismes à des règles répétées dans plusieurs variables : les changements restent visibles et plus faciles à vérifier.
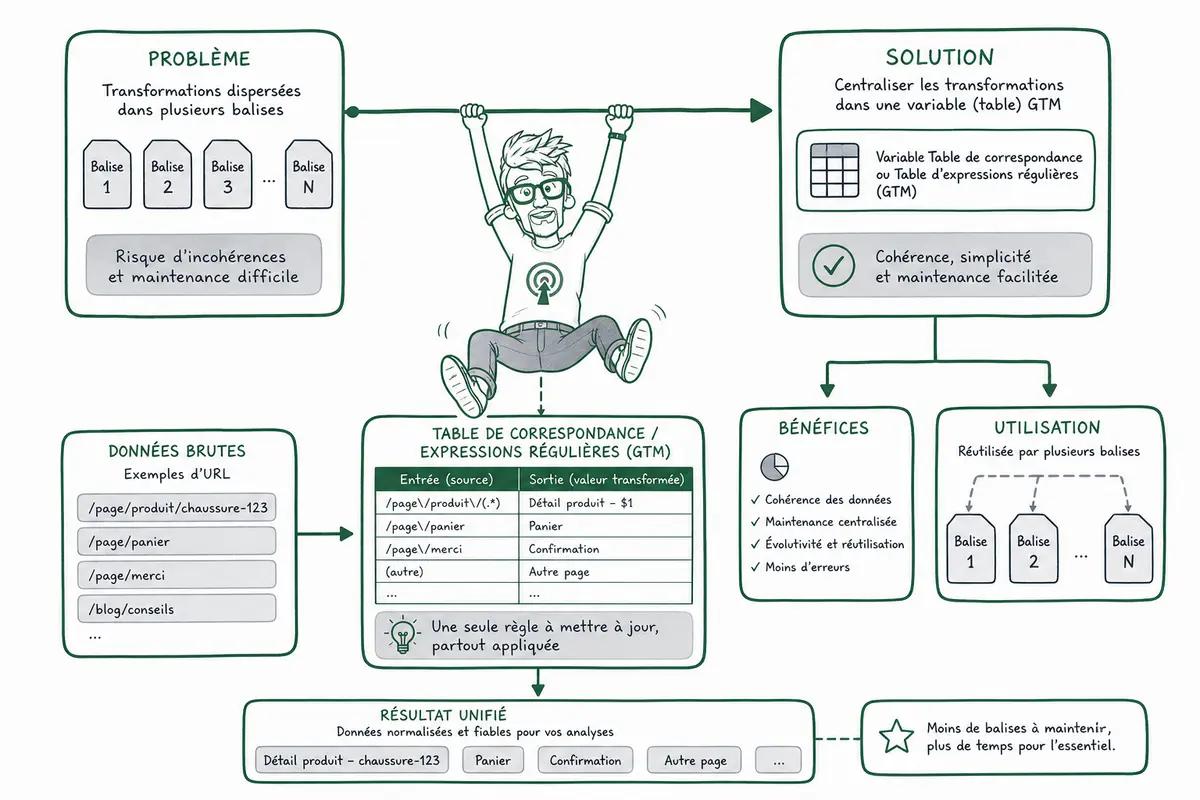
Chaque valeur doit pouvoir être suivie de sa source jusqu’à sa destination : donnée applicative, variable GTM, transformation éventuelle, puis balise ou plateforme destinataire. Je pars des données applicatives stables définies au chapitre précédent. Si un nom ou un format change, la transformation doit être explicite, pas dissimulée dans une balise. J’ai déjà vu des écarts de mesure causés par une valeur renommée dans une règle locale, alors que les autres balises continuaient d’utiliser l’ancien nom.
Avant publication, je vérifie les points qui peuvent modifier le sens ou la portée de la donnée :
- Noms et types. La variable lit-elle la bonne clé, et reçoit-elle le type attendu, par exemple un nombre plutôt qu’un texte ?
- Portée et calendrier. La valeur est-elle disponible au bon niveau et au bon moment, notamment avant le déclenchement de la balise ?
- Identifiants et devise. Les identifiants sont-ils cohérents avec la destination, et la devise est-elle présente et correcte lorsqu’elle est nécessaire ?
- Consentement et valeurs vides. La donnée est-elle utilisée conformément au consentement recueilli ? Que produit la règle si la source est absente ou vide ?
Je ne collecte ni ne transmets de données sans utilité pour la mesure prévue. Une table ne rend pas une donnée légitime à elle seule : les exigences de consentement s’appliquent toujours, y compris aux transformations. Je garde aussi les modifications assez limitées pour les examiner dans Preview, le mode de prévisualisation de GTM, et contrôler les valeurs réellement envoyées.
| Contrôle | Vérification |
| Source et destination | La valeur peut être suivie de la donnée applicative jusqu’à la balise destinataire. |
| Transformation | La correspondance ou l’expression régulière est centralisée et compréhensible. |
| Format et disponibilité | Les noms, types, portée, calendrier, identifiants et devise sont vérifiés. |
| Consentement et absence de valeur | La transmission respecte le consentement et le comportement des valeurs vides est connu. |
Quand réserver le JavaScript personnalisé ?
Je réserve le JavaScript personnalisé aux cas où aucune option déclarative plus sûre ne convient. Dans Google Tag Manager, je vérifie d’abord si une variable de couche de données ou une table de correspondance répond déjà au besoin. Ces options couvrent souvent les besoins courants du conteneur sans ajouter de logique personnalisée.
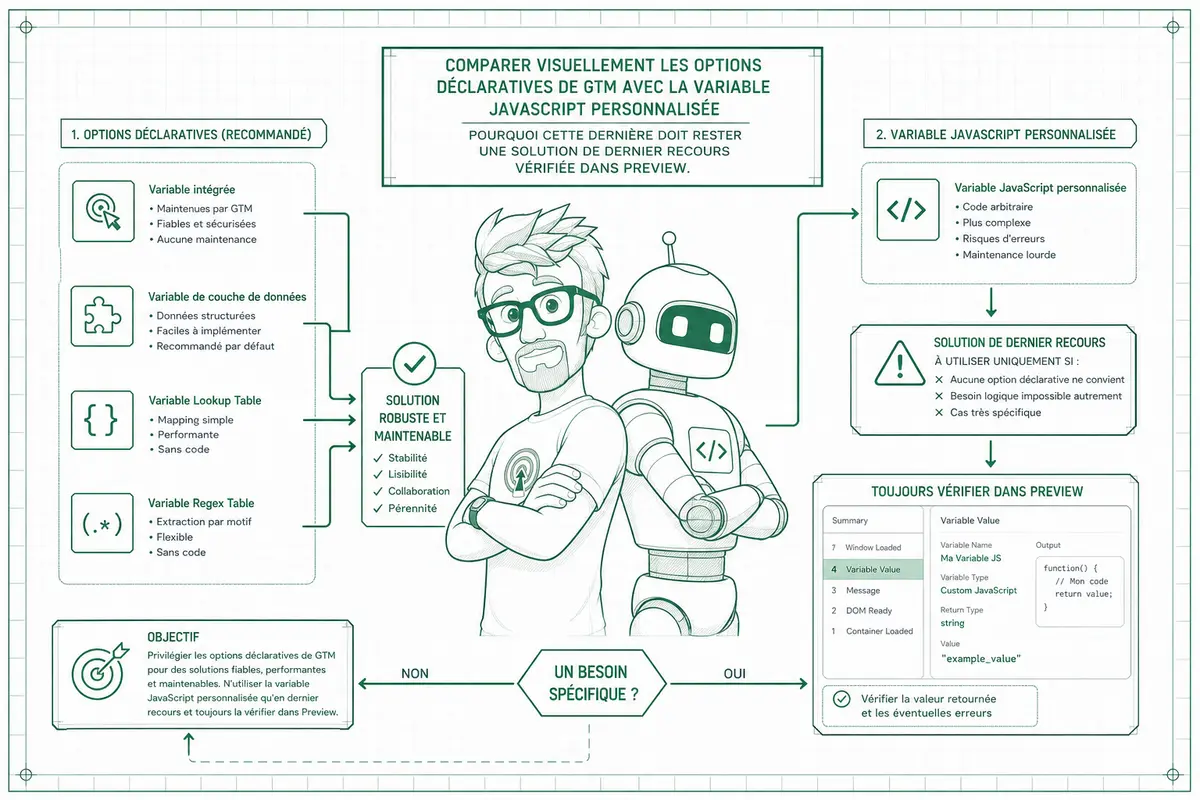
Une variable de couche de données récupère une valeur déjà transmise au conteneur par le site ou l’application. Une table de correspondance permet d’associer une valeur à une autre, selon des règles définies dans l’interface. Si l’une de ces options suffit, je la privilégie : le fonctionnement est plus facile à lire et à reprendre par une autre personne.
Le JavaScript personnalisé peut être pertinent quand le besoin ne peut pas être traité par ces mécanismes. Je garde alors la modification aussi limitée que possible. Une logique plus large que nécessaire est plus difficile à vérifier, et peut rendre le conteneur moins compréhensible.
Avant de publier, je vérifie le résultat en mode Preview, l’outil de prévisualisation de GTM qui permet d’observer le comportement du conteneur. Je contrôle aussi les dépendances, c’est-à-dire les éléments qui reposent sur cette variable, les exclusions qui peuvent empêcher son utilisation et la possibilité de revenir à l’état précédent. Ces vérifications évitent de traiter une modification isolément alors qu’elle peut affecter d’autres éléments du conteneur.
Je n’ajoute pas de contrôles techniques spécifiques au JavaScript au-delà de ce qui peut être vérifié dans le contexte du conteneur. L’essentiel est de choisir l’approche la plus simple qui couvre réellement le besoin. Une variable bien choisie reste plus claire, plus réutilisable et plus facile à maintenir qu’une logique personnalisée utilisée par défaut.
Votre conteneur est-il prêt à évoluer ?
Des variables GTM maintenables commencent par un périmètre de test clair, une référence datée et un retour arrière prévu. Ensuite, appuyez-vous sur des événements métier et des données d’application stables plutôt que sur des éléments de présentation. Nommez les composants selon leur rôle, gardez les déclencheurs précis et centralisez les transformations dans des tables de correspondance quand c’est adapté. Vérifiez les dépendances, les valeurs sensibles et le consentement dans Preview, avec des changements assez petits pour être examinés. Le JavaScript personnalisé reste une option de dernier recours lorsqu’aucune solution déclarative plus sûre ne convient. Vous obtenez ainsi un conteneur plus compréhensible, plus réutilisable et plus simple à faire évoluer.
FAQ
- À quoi servent les variables dans Google Tag Manager ?
Elles permettent de centraliser des valeurs utilisées par les composants du conteneur, notamment pour relier des données applicatives à leurs destinations. - Pourquoi utiliser une couche de données stable ?
Elle fournit une source applicative faisant autorité. C’est préférable à la reconstruction de données à partir de textes ou d’éléments de présentation. - Quand choisir une table de correspondance ?
Quand une transformation réutilisable peut être centralisée et rendue transparente, avec une valeur traçable de sa source à sa destination. - Que faut-il vérifier avant de publier une modification GTM ?
Le comportement de référence, les dépendances, les paramètres attendus, les exclusions et les résultats en Preview. Il faut aussi prévoir un responsable et une procédure de retour arrière. - Faut-il utiliser du JavaScript personnalisé pour les transformations ?
Seulement lorsqu’aucune option déclarative plus sûre ne convient. Les changements doivent rester limités et testables.
A propos de l’auteur
Je suis Franck Scandolera, expert en tracking avancé, analytics engineering et automatisation. Je dirige webAnalyste et l’organisme Formations Analytics. J’accompagne des équipes sur la fiabilité de leur mesure, la structuration de leurs données et l’évolution de leurs dispositifs analytics, notamment pour Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.