

BigQuery propose désormais une suite de fonctions renvoyant des tables (TVF pour table-valued function) dédiées à l’analyse augmentée, conçues pour automatiser l’analyse complexe de données à grande échelle. L’analyse augmentée associe l’IA, le machine learning et des méthodes statistiques pour automatiser la découverte d’informations clés et l’explication de modèles.
À quoi servent ces TVF ?
Ces TVF servent à automatiser une partie du diagnostic analytique dans BigQuery, sans sortir les données vers un notebook ou un outil BI séparé. Une TVF, pour table-valued function, c’est une fonction SQL qui renvoie un tableau. Pas juste une valeur. Donc je peux l’utiliser comme une table normale, la filtrer, la joindre, la chaîner avec d’autres requêtes.
BigQuery augmented analytics, c’est cette couche d’analyse avancée dans BigQuery qui combine IA, machine learning et méthodes statistiques dans des fonctions SQL prêtes à l’emploi. L’idée est simple : au lieu d’écrire beaucoup de SQL, de préparer un dataset dans Python, puis de revenir dans le dashboard, je reste dans BigQuery et je lance une analyse directement sur mes données.
Chez les clients, je vois souvent le même sujet. Le vrai problème n’est pas de faire un dashboard. Ça, on sait faire. Le vrai problème, c’est de comprendre vite pourquoi une courbe a bougé. Une baisse de conversion, une hausse du churn, un panier moyen qui décroche, un coût média qui explose. Là, ces fonctions deviennent utiles parce qu’elles donnent une première lecture exploitable, sans passer trois jours à découper les données à la main.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
| Fonction TVF | Ce qu’elle permet d’identifier | Question métier à laquelle elle répond |
|---|---|---|
| AI.KEY_DRIVERS | Identifie les principaux facteurs expliquant une hausse ou une baisse d’une métrique entre deux périodes ou deux groupes. | Pourquoi le chiffre d’affaires a-t-il fortement augmenté ce trimestre par rapport au trimestre précédent ? |
| AI.CAUSAL_EFFECT | Quantifie l’impact d’une action ou d’un événement en comparant les résultats observés à une situation de référence attendue. | Quelle part de l’augmentation du chiffre d’affaires provient de notre changement de tarification plutôt que de la croissance organique ? |
| ML.CORRELATION | Évalue le sens et la force de la relation entre des paires de métriques numériques. | Une augmentation de la durée des sessions utilisateurs est-elle corrélée à une valeur vie client plus élevée ? |
| ML.DETECT_CHANGE_POINTS | Identifie les dates ou périodes précises au cours desquelles une métrique change significativement par rapport aux tendances environnantes. | À quelles périodes la latence de notre plateforme a-t-elle connu des changements durables et structurels ? |
| ML.TREND | Isole la tendance de fond — croissance ou baisse — des fluctuations ponctuelles et du bruit. | Quelle est la tendance de fond de mon chiffre d’affaires sur l’année écoulée, en faisant abstraction des pics et des baisses exceptionnels ? |
| ML.SEASONALITY | Détecte les cycles récurrents et prévisibles selon les heures, les jours, les semaines, les mois ou les trimestres. | Quels jours de la semaine enregistrent systématiquement la charge serveur la plus élevée ? |
Pour un analyste, un analytics engineer ou une équipe data pressée, ça change surtout le rythme. Je pose une question sur une variation de métrique, je lance une TVF, je récupère un tableau exploitable, puis je continue l’analyse avec du SQL classique. Le gros intérêt arrive quand je les chaîne. Je détecte une rupture, j’isole la tendance, je regarde les segments qui expliquent le mouvement, puis je teste un effet causal. Là, BigQuery ne sert plus seulement à stocker et requêter. Il aide à comprendre.
Comment préparer les données ?
La préparation consiste à créer une table propre, agrégée au bon niveau de temps, avec la métrique et les dimensions qui pourront expliquer la variation. Dans BigQuery augmented analytics, si la donnée est floue au départ, l’analyse derrière sera floue aussi. Je l’ai vu chez un client : Le modèle détectait bien une rupture, mais personne ne pouvait l’expliquer parce que les segments utiles n’avaient pas été préparés.
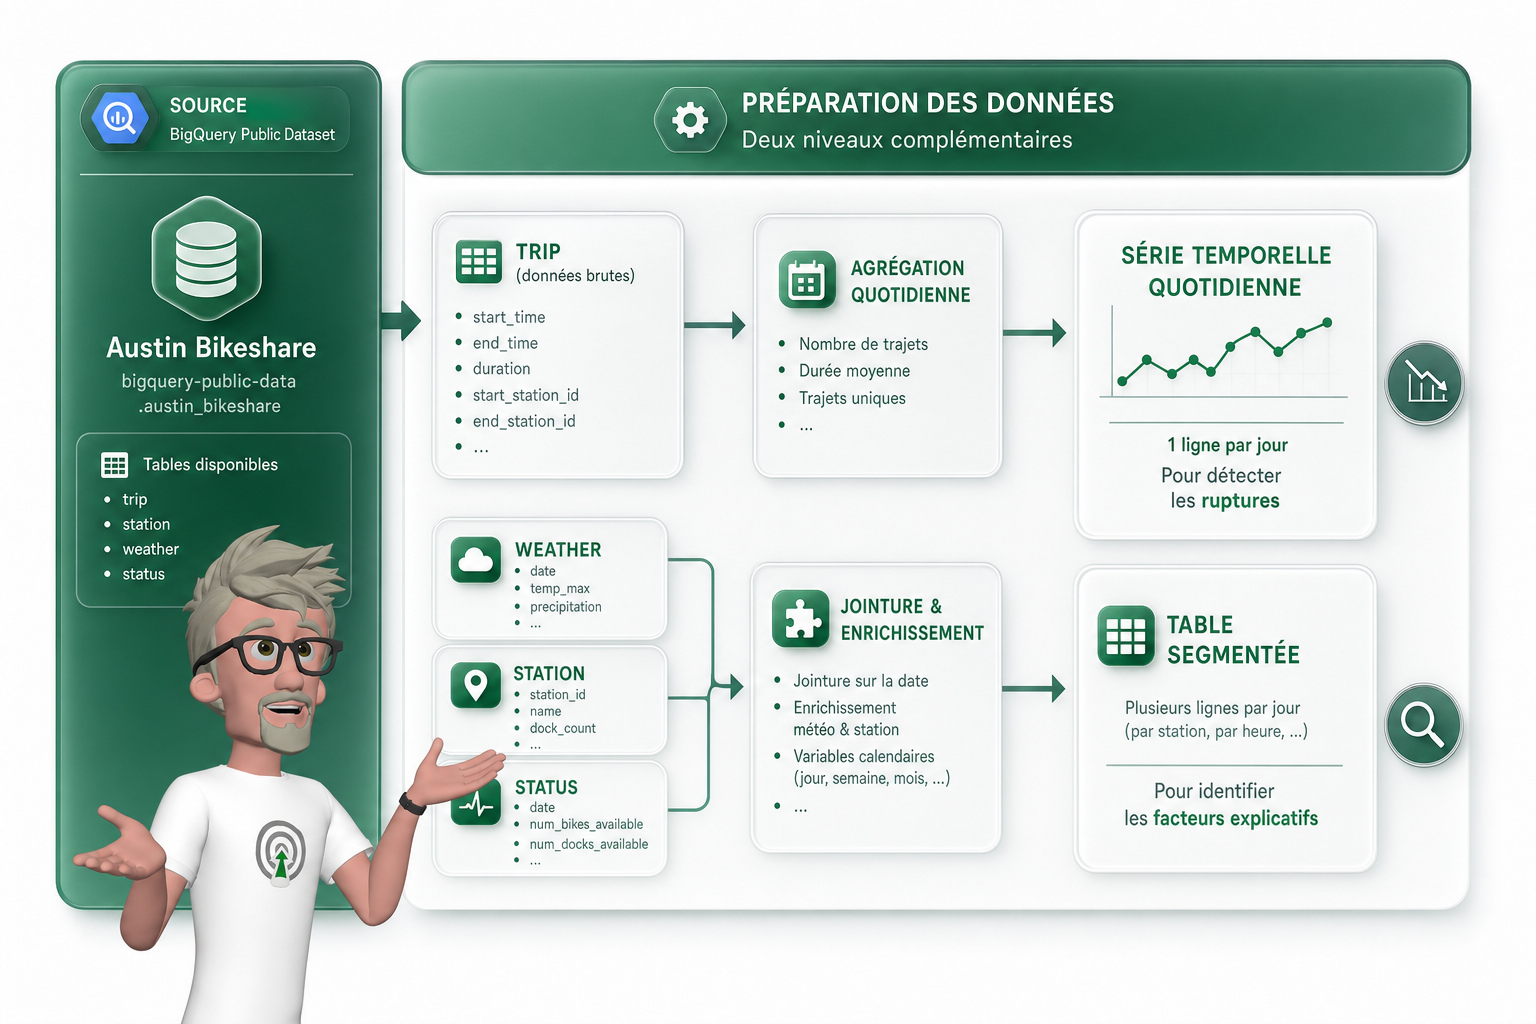
Avec le dataset public Austin Bikeshare, on a besoin de deux choses. D’abord une série temporelle quotidienne pour détecter une rupture dans le nombre de trajets. Puis une table segmentée pour chercher les drivers, c’est-à-dire les dimensions qui expliquent le changement : Type d’abonné, station de départ, station d’arrivée.
Ce premier SQL sert à créer une table simple, avec une ligne par jour. C’est le format le plus pratique pour détecter une variation dans le temps.
CREATE OR REPLACE TABLE `project.dataset.austin_daily_trips` AS
SELECT
  DATE(start_time) AS trip_date,
  COUNT(*) AS trips
FROM `bigquery-public-data.austin_bikeshare.bikeshare_trips`
WHERE start_time IS NOT NULL
GROUP BY trip_date;
Ici, trip_date devient la granularité temporelle. Trips devient la métrique à surveiller. C’est volontairement minimal. Moins il y a de bruit, plus la détection est lisible.
Ensuite, on prépare une table plus détaillée. Elle sert à comprendre pourquoi la métrique bouge. Par exemple, est-ce que la baisse vient d’un type d’abonné précis ? D’une station en particulier ? D’un trajet spécifique ?
CREATE OR REPLACE TABLE `project.dataset.austin_trip_segments` AS
SELECT
  DATE(start_time) AS trip_date,
  subscriber_type,
  start_station_name,
  end_station_name,
  COUNT(*) AS trips
FROM `bigquery-public-data.austin_bikeshare.bikeshare_trips`
WHERE start_time IS NOT NULL
GROUP BY
  trip_date,
  subscriber_type,
  start_station_name,
  end_station_name;
Les noms project et dataset sont à adapter à votre environnement BigQuery. Si vous utilisez ensuite des TVF, des fonctions table-valued qui retournent une table, leurs signatures exactes doivent être alignées avec la documentation BigQuery active dans votre projet. Google fait évoluer ces fonctions, donc je vérifie toujours la doc avant de figer un script.
- Granularité temporelle : Une ligne par jour, semaine ou mois, selon le niveau d’analyse attendu.
- Métrique claire : Une seule métrique principale, ici le nombre de trajets.
- Dimensions propres : Des colonnes utiles pour expliquer la variation, sans valeurs trop bruitées si possible.
- Période d’analyse cohérente : Une fenêtre assez longue pour comparer avant et après la rupture.
Comment repérer une rupture ?

ML.DETECT_CHANGE_POINTS sert à repérer les moments où une série change de comportement, par exemple une hausse soudaine et durable du nombre de trajets. Je commence souvent par là parce que tant qu’on ne sait pas où la métrique bouge, on cherche les causes dans le flou. Et là, on perd vite du temps à raconter une histoire qui colle mal aux données.
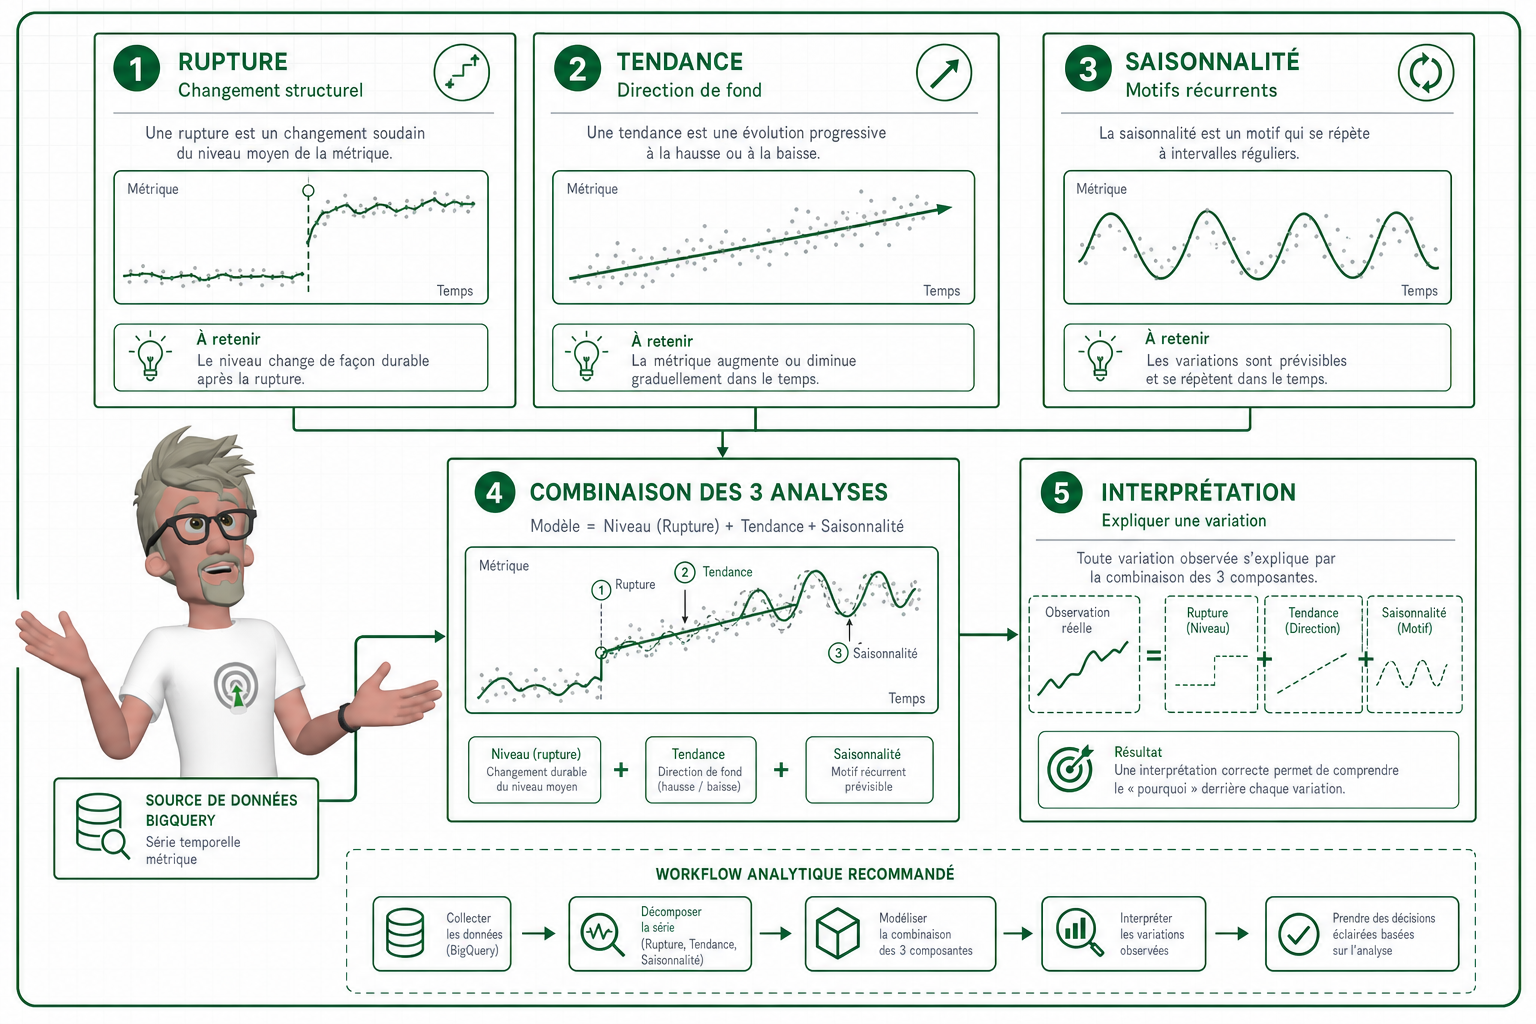
Le gabarit BigQuery ressemble à ça. Il part d’une table quotidienne avec une colonne de date et une colonne de valeur. Ici, j’utilise des trajets par jour, mais vous pouvez adapter ça à du chiffre d’affaires, des tickets support, des visites, des commandes, etc. À vérifier avec la signature officielle BigQuery au moment où vous l’utilisez, car ces fonctions évoluent.
-- Gabarit pour détecter les ruptures dans une série temporelle.
-- À adapter avec votre projet, votre dataset, votre table et vos colonnes.
SELECT *
FROM ML.DETECT_CHANGE_POINTS(
  TABLE `project.dataset.austin_daily_trips`,
  STRUCT(
    'trip_date' AS time_series_timestamp_col,
    'trips' AS time_series_data_col
  )
);
La lecture est assez simple. Vous cherchez la date probable de rupture, le niveau de confiance, et surtout le sens métier derrière. Une rupture, ce n’est pas juste un pic un mardi parce qu’il a plu ou parce qu’une promo a tourné. C’est plutôt un changement structurel, quelque chose qui modifie le comportement de la série pendant un moment. Chez un client retail, on avait vu une rupture nette après un changement de politique de livraison. Sans cette détection, l’équipe aurait continué à comparer les semaines comme si rien n’avait changé.
ML.TREND et ML.SEASONALITY complètent bien l’analyse. La tendance répond à la question “est-ce que ça monte ou ça descend globalement ?”. La saisonnalité répond à “est-ce qu’il y a un rythme qui se répète ?”, comme plus de trajets le week-end ou moins d’activité en août.
-- Gabarit pour isoler la tendance générale de la série.
SELECT *
FROM ML.TREND(
  TABLE `project.dataset.austin_daily_trips`,
  STRUCT(
    'trip_date' AS time_series_timestamp_col,
    'trips' AS time_series_data_col
  )
);
-- Gabarit pour repérer les cycles récurrents dans la série.
SELECT *
FROM ML.SEASONALITY(
TABLE `project.dataset.austin_daily_trips`,
STRUCT(
'trip_date' AS time_series_timestamp_col,
'trips' AS time_series_data_col
)
);La différence tient en une phrase. Une rupture dit “quelque chose a changé ici”. Une tendance dit “ça évolue dans ce sens”. Une saisonnalité dit “ça se répète avec un rythme”.
| Question posée | Fonction utile | Décision possible |
| Est-ce qu’un changement durable vient d’apparaître ? | ML.DETECT_CHANGE_POINTS | Analyser ce qui s’est passé autour de cette date. |
| Est-ce que la métrique monte ou baisse globalement ? | ML.TREND | Ajuster les objectifs, les stocks ou les équipes. |
| Est-ce qu’un cycle revient régulièrement ? | ML.SEASONALITY | Planifier selon les jours, mois ou périodes fortes. |
Comment trouver les moteurs ?

AI.KEY_DRIVERS sert à expliquer quels segments contribuent le plus à une variation observée. Dans le chapitre précédent, on a détecté une rupture. Là, on arrête de se dire “tiens, ça monte” et on commence à chercher “où ça monte vraiment”. C’est souvent le moment utile, parce qu’une variation globale cache presque toujours deux ou trois segments qui tirent le signal.
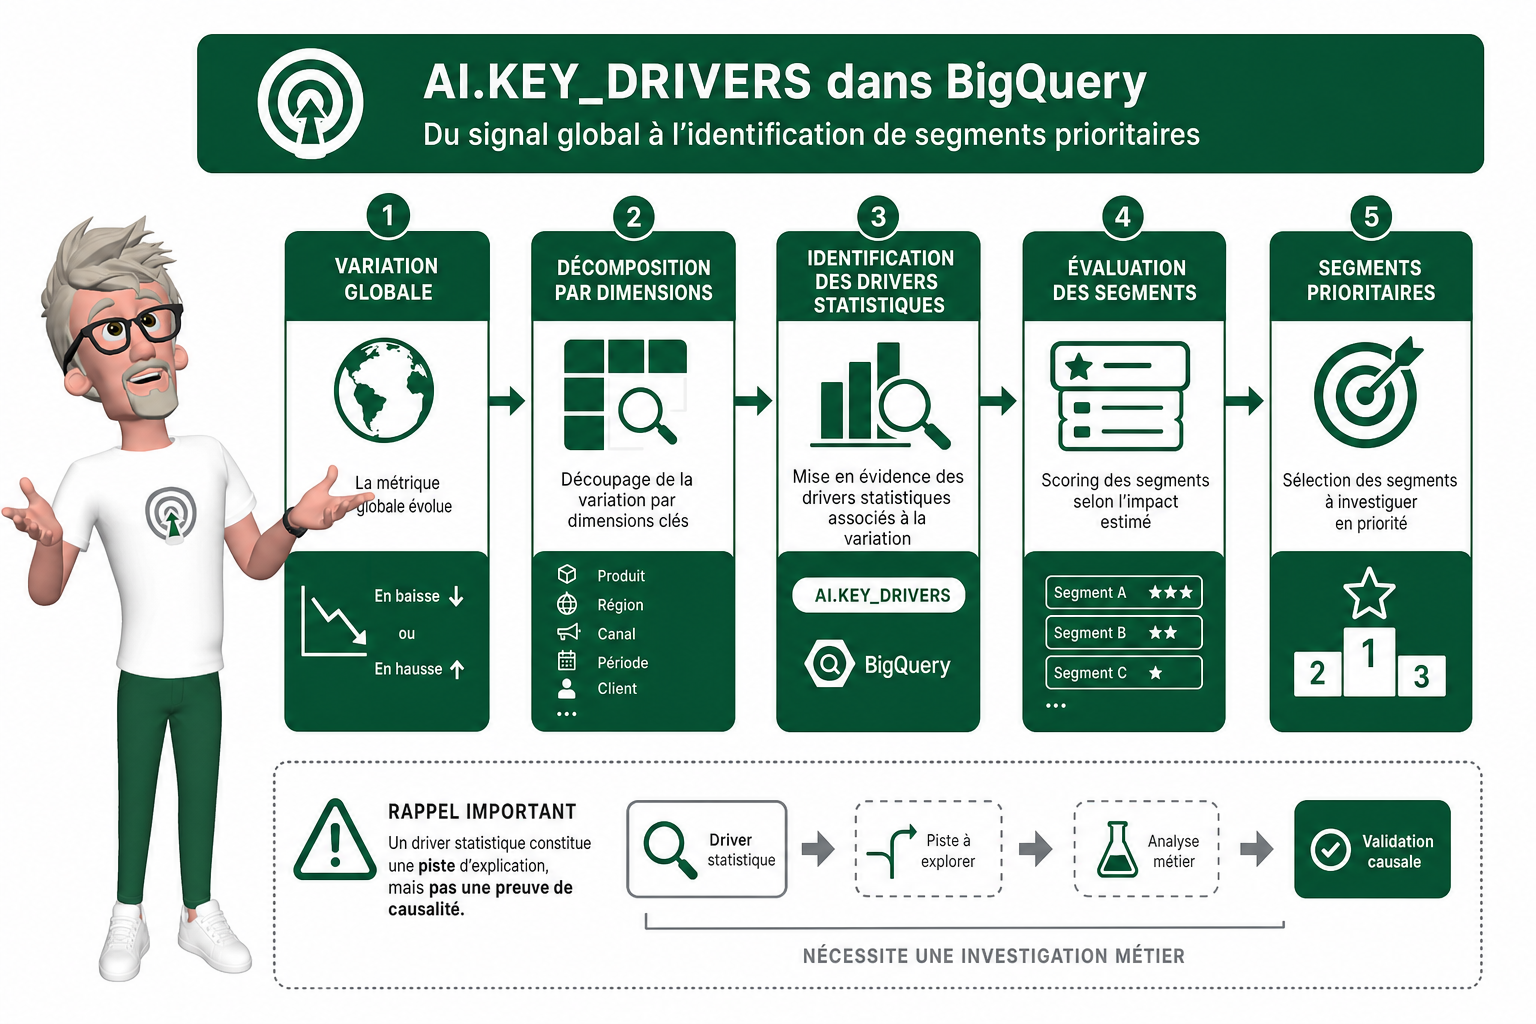
Dans l’exemple Austin Bikeshare, je peux regarder si la hausse autour de la rupture vient plutôt des abonnements étudiants UT, de certaines stations de départ, ou d’une combinaison des deux. Attention, je reste propre sur l’interprétation. La fonction mesure une contribution statistique dans les données, elle ne prouve pas que les étudiants UT “causent” la hausse.
Avant d’appeler AI.KEY_DRIVERS, je prépare une table simple avec un avant / après. Ici la date du 2016-08-01 est fictive. Je la remplace par la date de rupture trouvée juste avant.
CREATE OR REPLACE TABLE `project.dataset.austin_before_after_segments` AS
SELECT
  CASE
    WHEN DATE(start_time) >= DATE '2016-08-01' THEN 'after'
    ELSE 'before'
  END AS period,
  subscriber_type,
  start_station_name,
  COUNT(*) AS trips
FROM `bigquery-public-data.austin_bikeshare.bikeshare_trips`
WHERE DATE(start_time) BETWEEN DATE '2016-07-01' AND DATE '2016-09-01'
GROUP BY period, subscriber_type, start_station_name;
Ensuite, j’utilise ce gabarit d’appel. Je dis bien gabarit, parce que la syntaxe exacte peut bouger selon la version BigQuery disponible dans votre projet et les fonctions AI activées.
SELECT *
FROM AI.KEY_DRIVERS(
  TABLE `project.dataset.austin_before_after_segments`,
  STRUCT(
    'period' AS target_col,
    'trips' AS metric_col,
    ['subscriber_type', 'start_station_name'] AS dimension_cols
  )
);
La sortie sert surtout à prioriser. Je regarde les segments avec la plus forte contribution, leur poids relatif, puis je décide quoi creuser en premier. Par exemple, si “Student Membership – UT” ressort fort avec quelques stations proches du campus, je vais vérifier le calendrier universitaire, la rentrée, les changements d’offre, ou un éventuel déplacement de stations.
| Élément en sortie | Comment je l’utilise |
| Segment | Je vois quelle combinaison de dimensions ressort, par exemple type d’abonné + station. |
| Contribution | Je mesure combien ce segment pèse dans la variation observée. |
| Poids relatif | Je compare les pistes entre elles sans me perdre dans le bruit. |
Un driver n’est pas encore une preuve causale. C’est une piste priorisée. Et franchement, c’est déjà énorme, parce que ça évite de passer deux heures à explorer vingt graphiques au hasard.
Comment mesurer un effet causal ?
AI.CAUSAL_EFFECT sert à estimer si un événement ou une action a réellement eu un effet sur une métrique, au-delà d’une simple corrélation. Après avoir identifié un driver probable dans le chapitre précédent, je passe à ce test seulement si j’ai trois choses propres : une période avant/après, une intervention claire, et un signal pas trop bruité. Sinon, on risque surtout de se raconter une belle histoire.
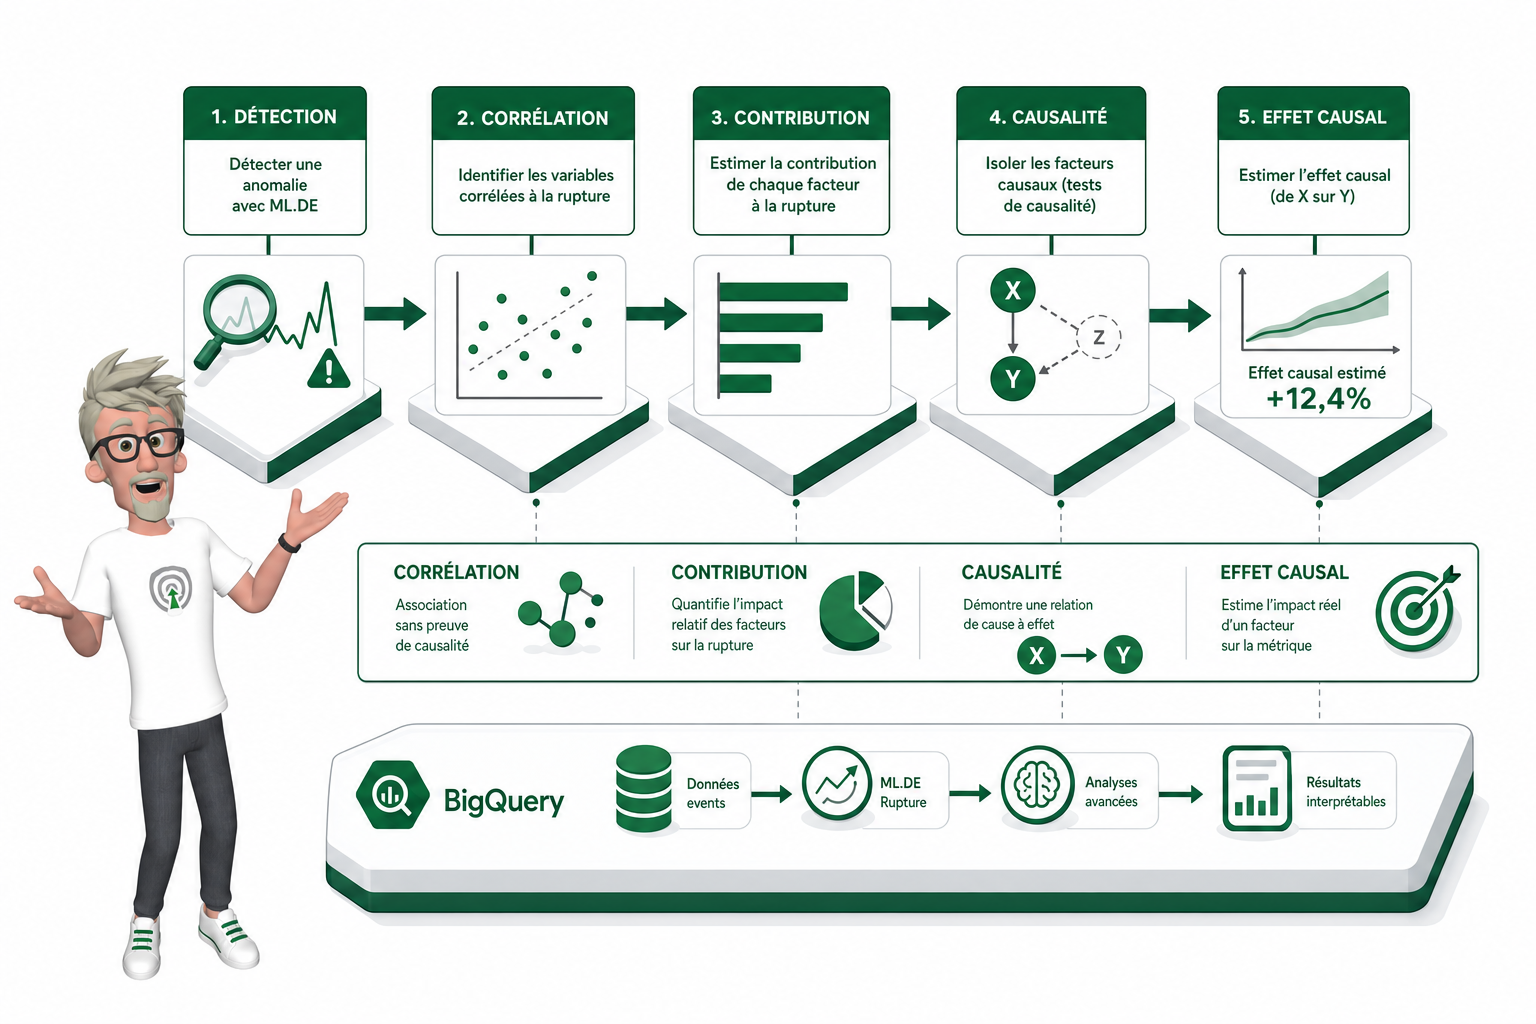
La différence est simple. ML.CORRELATION dit que deux variables bougent ensemble. Par exemple, les trajets augmentent quand les abonnements étudiants augmentent. AI.CAUSAL_EFFECT cherche plutôt à estimer l’impact d’une intervention. Par exemple, est-ce qu’une campagne rentrée étudiante lancée le 1er août a vraiment augmenté les trajets ? C’est beaucoup plus ambitieux, donc je reste prudent sur l’interprétation.
Ce premier gabarit sert à tester une corrélation entre le volume de trajets et le type d’abonné. C’est utile avant de parler causalité, juste pour voir si une relation statistique existe.
SELECT *
FROM ML.CORRELATION(
  TABLE `project.dataset.austin_trip_segments`,
  STRUCT(
    'trips' AS input_col,
    'subscriber_type' AS compare_col
  )
);
Ce second gabarit sert à estimer un effet causal autour d’une date d’intervention. Les noms exacts des paramètres sont à vérifier dans la documentation BigQuery, parce que ces fonctions évoluent, et j’ai déjà vu des équipes perdre du temps juste à cause d’une option renommée.
SELECT *
FROM AI.CAUSAL_EFFECT(
  TABLE `project.dataset.austin_daily_trips`,
  STRUCT(
    'trip_date' AS time_col,
    'trips' AS outcome_col,
    DATE '2016-08-01' AS intervention_date
  )
);
Le workflow complet se chaîne très bien dans BigQuery, ou dans un agent IA qui orchestre les requêtes. Je détecte d’abord une rupture. J’extrais ensuite la tendance et la saisonnalité, parce qu’un pic du lundi n’a rien à voir avec une vraie anomalie. Je cherche les drivers probables, je teste les corrélations, puis seulement après j’estime l’effet causal. À la fin, je génère un résumé exploitable, pas un roman statistique.
| Étape | TVF ou fonction | Livrable attendu |
| Détecter une rupture | AI.FORECAST ou analyse temporelle | Date probable du changement |
| Extraire tendance et saisonnalité | AI.FORECAST, décomposition temporelle | Signal nettoyé et contexte |
| Chercher les drivers | AI.GENERATE_TABLE ou requêtes analytiques | Variables candidates |
| Tester la corrélation | ML.CORRELATION | Relations statistiques plausibles |
| Estimer l’effet causal | AI.CAUSAL_EFFECT | Impact estimé de l’intervention |
| Résumer pour décider | AI.GENERATE ou agent IA | Synthèse claire avec limites |
Et si BigQuery faisait déjà une partie du diagnostic ?
BigQuery augmented analytics change surtout la vitesse d’analyse. On garde les données dans BigQuery, on lance des TVF SQL, et on obtient des pistes concrètes : rupture, tendance, saisonnalité, corrélation, drivers, effet causal. Ce n’est pas magique, il faut toujours une métrique propre, une bonne période et un minimum de jugement métier. Mais pour comprendre pourquoi une courbe monte ou descend, c’est beaucoup plus efficace que de multiplier les exports et les analyses manuelles. Le bénéfice pour vous est simple : moins de temps perdu à chercher, plus de temps pour décider quoi faire.
FAQ
- Qu’est-ce que BigQuery augmented analytics ?
C’est un ensemble de fonctions BigQuery de type TVF qui automatisent des analyses avancées directement en SQL. Elles aident à repérer des ruptures, tendances, saisonnalités, corrélations, drivers de variation et effets causaux. - Est-ce qu’il faut entraîner un modèle ML soi-même ?
Pas pour l’usage décrit ici. L’intérêt de ces fonctions, c’est justement de lancer des analyses avancées depuis BigQuery avec des appels SQL. Il faut surtout préparer une table propre, choisir la bonne métrique et contrôler l’interprétation. - Quelle est la différence entre un driver et une cause ?
Un driver indique un segment qui contribue fortement à une variation. Une cause demande une analyse plus stricte, avec une intervention identifiable et une comparaison avant/après crédible. Je traite donc AI.KEY_DRIVERS comme une priorisation, pas comme une preuve définitive. - Peut-on chaîner ces fonctions dans un pipeline SQL ?
Oui, c’est même le vrai intérêt. On peut détecter une rupture avec ML.DETECT_CHANGE_POINTS, analyser tendance et saisonnalité, chercher les drivers avec AI.KEY_DRIVERS, puis tester corrélation ou effet causal selon le besoin. - Est-ce utile avec un agent IA ou une interface conversationnelle ?
Oui, parce que les résultats sortent sous forme de tables BigQuery. Un agent peut enchaîner les requêtes, lire les sorties, générer un résumé et proposer la prochaine analyse. Ça rend l’exploration beaucoup plus automatisable.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, analytics engineering, automatisation No/Low Code avec n8n, IA appliquée aux entreprises et SEO/GEO. J’accompagne des équipes data, marketing et produit sur des sujets très concrets : fiabiliser la donnée, automatiser les analyses, connecter les outils et rendre les insights actionnables. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez mettre ce type d’analyse en place dans votre business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.