

Aucun des trois modèles ne s’impose sur toutes les tâches testées. Je compare leur suivi des consignes, la qualité de leurs maquettes HTML et leur traitement d’un dossier projet. Les résultats permettent de distinguer des usages, mais pas d’établir un classement général.
Comment les modèles ont-ils été testés ?
J’ai évalué les modèles sur des tâches pratiques, avec un seul essai par tâche. Ce n’était pas un benchmark répété, conçu pour mesurer leurs performances de manière statistique. Les résultats décrivent donc ce que j’ai observé dans ces conditions précises, pas une performance générale.
| Modèle | Configuration utilisée |
| GPT-6 Astra | ChatGPT Work, réglage Ultra. |
| Gemini 4 Argon | Gemini Chat, réglage High. |
| Claude Opus 5.5 | Claude Chat, réglage Max. |
J’ai relancé Gemini 4 Argon une fois sur un fichier CSV. Cette seconde exécution constitue une exception, pas une série de tests suffisante pour évaluer la reproductibilité de son résultat.
Les interfaces et réglages utilisés ne garantissent pas des conditions de calcul identiques. Les ressources disponibles, les outils accessibles et les paramètres propres à chaque produit peuvent différer. Je n’ai pas contrôlé ni égalisé ces facteurs. Le nombre d’essais est aussi trop faible pour distinguer une tendance stable d’une variation ponctuelle.
Formez-vous à l'IA Générative !
Exploiter l'IA générative et le prompt engineering est désormais indispensable pour automatiser vos tâches, accélérer votre création de contenu et booster votre productivité au quotidien... Passez à la vitesse supérieure avec nos formations IA Générative.
Cette comparaison reste utile pour observer le comportement des modèles sur les tâches testées et dans leurs interfaces respectives. Mais elle ne permet pas d’établir qu’un modèle est systématiquement meilleur qu’un autre. Un résultat peut dépendre de la tâche, de la formulation de la demande, du contexte fourni ou d’un détail d’exécution. Avec un seul essai, je ne peux pas isoler ces effets ni mesurer leur variabilité.
Je ne présente donc pas ces essais comme une mesure scientifique généralisable. Le faible nombre d’exécutions, les ressources de calcul non égalisées, les outils différents et les réglages propres à chaque interface empêchent d’en tirer un classement universel.
Quel modèle produit la meilleure maquette produit ?
Les trois modèles ont produit un fichier HTML autonome pour le tableau de bord ShiftBridge, et chaque version s’ouvre et s’affiche comme une maquette exploitable. La différence se joue surtout sur la finition, le respect du cahier des charges et la facilité de livraison.
J’ai vérifié les mêmes éléments d’usage : les filtres, les panneaux d’affectation et l’affichage sur mobile. Astra et Opus ont respecté la hauteur de bureau demandée. Argon a livré une page plus longue, avec un design plus basique ; certains boutons ne déclenchaient aucune action. Son code devait aussi être enregistré manuellement depuis la conversation, ce qui ajoutait une étape avant de pouvoir tester la maquette localement.
| Critère | Constat |
| Fonctionnalité | Les trois versions fournissaient un HTML autonome. L’interaction était toutefois incomplète sur certains boutons d’Argon. |
| Respect du cahier des charges | Astra et Opus respectaient la hauteur de bureau demandée. Argon s’en écartait avec une page plus longue. |
| Facilité de livraison | Le code d’Argon nécessitait un enregistrement manuel depuis la conversation. Cette étape rendait sa livraison moins directe. |
Je ne réduis donc pas le résultat à une question de rendu visuel. Une maquette peut s’afficher correctement sans que tous ses contrôles soient opérationnels ; elle peut aussi être convaincante, mais plus coûteuse à récupérer et à tester. Sur ce point, Astra et Opus étaient plus proches d’un livrable immédiatement vérifiable, tandis qu’Argon demandait davantage de reprise.
Cette comparaison reste liée aux limites de la méthode présentées précédemment : elle porte sur les sorties obtenues dans les conditions du test, pas sur une évaluation exhaustive des modèles. Je peux comparer les fichiers et les contrôles observés, mais pas en déduire une supériorité générale sur d’autres prompts, données ou contextes de développement.
Quel modèle interprète le mieux un dossier projet ?
J’ai évalué les réponses de GPT-6 Astra, Gemini 4 Argon et Claude Opus 5.5 au dossier Harbor Clinic. Les trois réponses sont satisfaisantes sur les points évalués : elles retiennent les données récentes malgré les éléments contradictoires présents dans le PDF et évitent les conclusions que le dossier ne permet pas de soutenir.
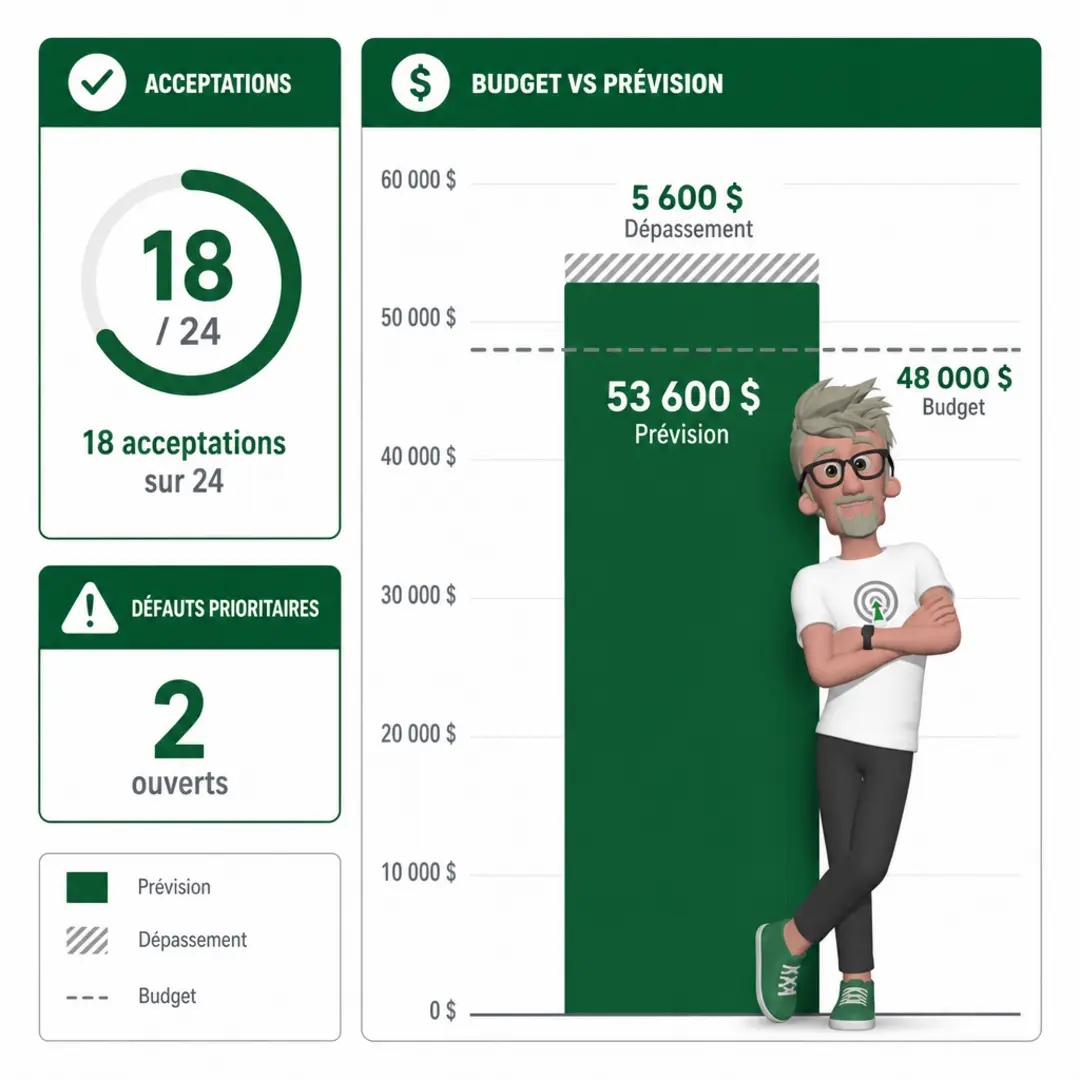
Les chiffres opérationnels à retenir sont 18 acceptations sur 24 et deux défauts prioritaires encore ouverts. Les trois modèles signalent aussi une prévision de 53 600 dollars, soit un dépassement de 5 600 dollars par rapport au budget. Ce point est important : le dépassement n’est pas masqué par les chiffres d’acceptation, et les défauts ouverts restent visibles dans l’analyse.
| Point vérifié | Résultat observé |
| Données récentes | 18 acceptations sur 24 et deux défauts prioritaires encore ouverts. |
| Budget | Les trois modèles identifient une prévision de 53 600 dollars, soit 5 600 dollars au-dessus du budget. |
| Statut des examens | Aucun ne confond les examens planifiés avec des approbations déjà obtenues. |
| Décision sur le pilote | Aucun ne recommande de l’autoriser prématurément. |
Claude Opus 5.5 relève un élément supplémentaire : l’examen de confidentialité n’était pas confirmé, et il tombait le jour de la décision. C’est une observation utile pour apprécier le calendrier et le risque de décision. Elle ne change pas le constat principal : les trois modèles ont correctement interprété les informations déterminantes du dossier.
Je ne transforme pas ce résultat en preuve de supériorité générale d’un modèle. Il porte sur un dossier précis, avec des critères précis. Sur cet exemple, les réponses sont toutes satisfaisantes ; Opus ajoute un signal pertinent, mais un seul cas ne suffit pas à établir qu’il interprète mieux tous les dossiers projet.
Que sait-on de leur analyse des données ?
Les éléments disponibles ne permettent pas de comparer les réponses de GPT-6 Astra, Gemini 4 Argon et Claude Opus 5.5 à une tâche d’analyse de données. La revue des réponses n’est pas disponible. Je ne peux donc attribuer aucun résultat, aucune recommandation ni aucun avantage à l’un de ces modèles.
La tâche demandée pour BrightPath était pourtant assez précise. Elle devait couvrir plusieurs angles de l’analyse d’acquisition :
- Comparer les données des quatre premières semaines avec celles des quatre dernières semaines.
- Expliquer l’évolution du taux de conversion, et pas seulement constater une hausse ou une baisse.
- Recommander comment affecter un budget supplémentaire de 1 000 dollars.
- Examiner les résultats par canal d’acquisition et le nombre d’apprenants activés.
Pour évaluer correctement les modèles, il faudrait disposer de leurs réponses à ces demandes, puis vérifier si elles s’appuient sur les données fournies, distinguent les périodes comparées et justifient leurs recommandations. Une bonne analyse devrait aussi relier les performances des canaux aux apprenants effectivement activés, plutôt que de se limiter aux conversions ou au volume d’acquisition.
Sans les réponses, je ne peux pas savoir si un modèle a calculé correctement les écarts, repéré une évolution pertinente du taux de conversion ou proposé une répartition cohérente des 1 000 dollars. Je ne peux pas non plus déterminer s’il a signalé les limites des données ou confondu corrélation et causalité. Attribuer des chiffres, des recommandations ou un vainqueur reviendrait à inventer des résultats.
Cette absence interdit donc toute conclusion comparative sur leurs capacités d’analyse de données pour ce cas précis. Elle ne prouve pas que les modèles sont incapables de réaliser cette analyse ; elle signifie simplement que leurs performances ne sont pas observables ici. Il faut les réponses originales, ainsi que les données utilisées, pour établir une comparaison fiable.
Que peut-on conclure de cette comparaison ?
Je peux conclure que ces essais comparent quelques résultats concrets, mais qu’ils ne permettent pas de désigner le meilleur modèle dans l’absolu. Ils montrent comment trois modèles ont répondu à des tâches précises, dans des conditions données. Ce n’est pas un classement général.
Sur les maquettes HTML, les trois modèles ont produit des résultats fonctionnels, avec des écarts de conformité aux consignes et de finition. Pour le dossier Harbor Clinic, les trois réponses étaient satisfaisantes. Opus a aussi signalé un risque de calendrier lié à la confidentialité, un point utile qui n’était pas simplement une différence de formulation. L’analyse BrightPath, elle, ne peut pas être comparée : je ne dispose pas des résultats nécessaires pour l’évaluer.
| Tâche | Conclusion possible |
| Maquettes HTML | Les trois résultats fonctionnaient, avec des différences de conformité et de finition. |
| Dossier Harbor Clinic | Les trois réponses étaient satisfaisantes ; Opus a aussi relevé un risque de calendrier lié à la confidentialité. |
| Analyse BrightPath | Pas de conclusion possible faute de résultats disponibles. |
La comparaison reste limitée par deux éléments. Les configurations n’étaient pas identiques, et le protocole reposait principalement sur un seul essai par tâche. Un résultat isolé ne permet pas de mesurer la régularité, ni de distinguer sûrement l’effet du modèle de celui des paramètres, du prompt ou du hasard.
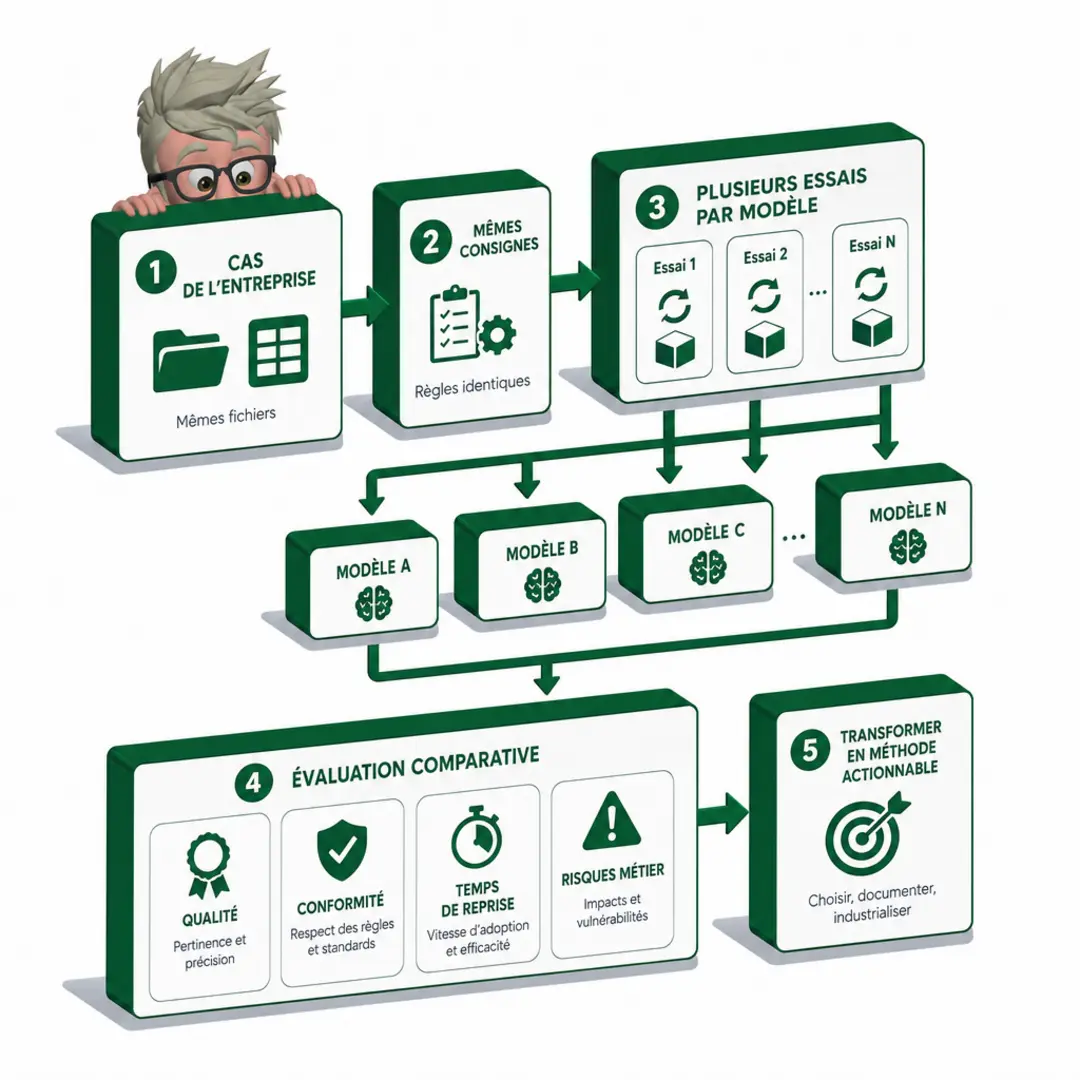
Je lirais donc ces résultats comme des indices d’adéquation, pas comme une recommandation de classement. Le bon choix dépend de vos tâches, de vos contraintes et du niveau de contrôle requis. Pour trancher, je testerais les modèles sur vos propres cas, avec les mêmes consignes et configurations, puis j’évaluerais la qualité, la conformité, le temps de reprise et les risques métier. Une tâche fréquente ou coûteuse à corriger mérite plusieurs essais : c’est là que les différences deviennent réellement utiles.
Quel modèle vaut la peine d’être testé sur vos tâches ?
Cette comparaison montre surtout l’intérêt d’évaluer les modèles sur des livrables concrets. Astra, Argon et Opus ont tous produit une maquette HTML fonctionnelle et traité correctement les principaux enjeux du dossier Harbor Clinic. Les écarts apparaissent dans la finition de l’interface et dans un point de vigilance supplémentaire relevé par Opus. En revanche, les résultats sur l’analyse des données BrightPath ne sont pas disponibles, et le protocole ne repose pas sur des essais répétés ni des conditions équivalentes. Je ne peux donc pas en tirer un vainqueur général. Testez chaque modèle sur vos propres consignes et fichiers : vous choisirez sur des résultats vérifiables et gagnerez du temps dans votre décision.
FAQ
- Quel modèle a produit la meilleure maquette HTML ?
Les trois modèles ont produit une maquette fonctionnelle. Astra et Opus respectaient la hauteur de bureau demandée. La version d’Argon était plus longue, plus basique, comportait des boutons inactifs et nécessitait un enregistrement manuel du code. - Les modèles ont-ils correctement traité le dossier Harbor Clinic ?
Les trois réponses ont été jugées satisfaisantes. Elles retenaient les données récentes, signalaient le dépassement budgétaire et ne présentaient ni les examens planifiés comme des approbations ni le pilote comme déjà autorisé. - Pourquoi Opus se distingue-t-il dans l’analyse du dossier ?
Opus a aussi relevé que l’examen de confidentialité non confirmé tombait le jour de la décision. Cet élément supplémentaire ne suffit pas à établir une supériorité générale. - Peut-on comparer leurs capacités d’analyse de données ?
Pas avec les résultats disponibles. La tâche BrightPath est décrite, mais la revue des réponses manque. Aucun classement ni résultat comparatif fiable ne peut être donné sur cette tâche. - Cette comparaison permet-elle de désigner un meilleur modèle ?
Non, elle couvre quelques tâches pratiques avec principalement un essai par tâche et des réglages différents. Elle aide à repérer des écarts concrets, mais pas à établir un classement universel.
A propos de l’auteur
Je suis Franck Scandolera, expert en automatisation IA et en applications métier intelligentes. J’évalue les modèles à partir de tâches opérationnelles, de leurs contraintes réelles et de la qualité des livrables produits.

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
- Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
- Data Engineering : BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
- Automatisation IA : n8n, Apps Script, scraping, API, LLM
- Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals