

BigQuery intègre des fonctions IA directement dans SQL, Redshift relie les données aux modèles de SageMaker AI et Bedrock, tandis que Fabric aide à écrire du T-SQL à partir du schéma. Je compare leurs usages, leurs limites et leurs conditions d’accès pour vous aider à choisir.
Comment BigQuery intègre-t-il l’IA dans SQL ?
BigQuery expose des fonctions d’IA directement dans les requêtes SQL. Avec AI.GENERATE, je peux utiliser Gemini pour analyser des données structurées ou non structurées, notamment du texte, des images, de l’audio, de la vidéo et des PDF. La fonction peut aussi produire une réponse conforme à un schéma fourni, ce qui aide à obtenir des résultats plus faciles à exploiter dans des traitements en aval.
AI.GENERATE_TEXT prend également en charge des modèles partenaires, dont Anthropic Claude, Mistral AI et Llama, ainsi que des modèles ouverts pris en charge. Le choix du modèle permet d’adapter l’inférence à différents besoins, sans sortir du cadre des requêtes BigQuery.
Pour la recherche sémantique ou les applications de type RAG, c’est-à-dire celles qui retrouvent des documents pertinents pour enrichir une réponse, BigQuery propose AI.EMBED et AI.GENERATE_EMBEDDING. Elles servent à produire des embeddings, des représentations numériques du contenu qui permettent de comparer son sens plutôt que ses seuls mots.
Formez-vous à l'IA Générative !
Exploiter l'IA générative et le prompt engineering est désormais indispensable pour automatiser vos tâches, accélérer votre création de contenu et booster votre productivité au quotidien... Passez à la vitesse supérieure avec nos formations IA Générative.
D’autres fonctions gérées couvrent des tâches plus ciblées : AI.IF pour des décisions conditionnelles, AI.SCORE pour l’évaluation, AI.CLASSIFY pour la classification et AI.AGG pour l’agrégation. Elles rapprochent ces opérations du SQL courant, même si leur comportement dépend des modèles et des paramètres disponibles.
Il faut toutefois distinguer les capacités documentées des limites. Le mode optimisé conçu pour traiter des millions ou des milliards de lignes est indiqué en préversion : il n’a donc pas le même statut qu’une fonctionnalité généralement disponible. Pour la vidéo, AI.GENERATE ne traite que les deux premières minutes. Cette limite compte si les contenus dépassent ce format, ou si une analyse exhaustive est nécessaire.
BigQuery mise donc sur des fonctions IA intégrées au langage de requête, avec un éventail allant de l’inférence multimodale aux embeddings. Redshift adopte une approche différente, que je vais comparer à son tour.
Comment Redshift utilise-t-il SageMaker AI et Bedrock ?
Redshift propose deux voies pour utiliser l’IA : entraîner des modèles avec SageMaker AI Autopilot, ou appeler des modèles de fondation hébergés dans Amazon Bedrock. La première sert surtout à produire des prédictions à partir de vos données. La seconde permet d’ajouter des capacités de génération et d’analyse de texte.
Avec Redshift ML, je peux lancer la création d’un modèle à partir de données stockées dans Redshift. SageMaker AI Autopilot teste automatiquement des approches de machine learning et entraîne un modèle. Une fois celui-ci créé, Redshift expose ses prédictions sous forme de fonctions SQL. On peut donc les utiliser dans des requêtes sans sortir le traitement du contexte SQL.
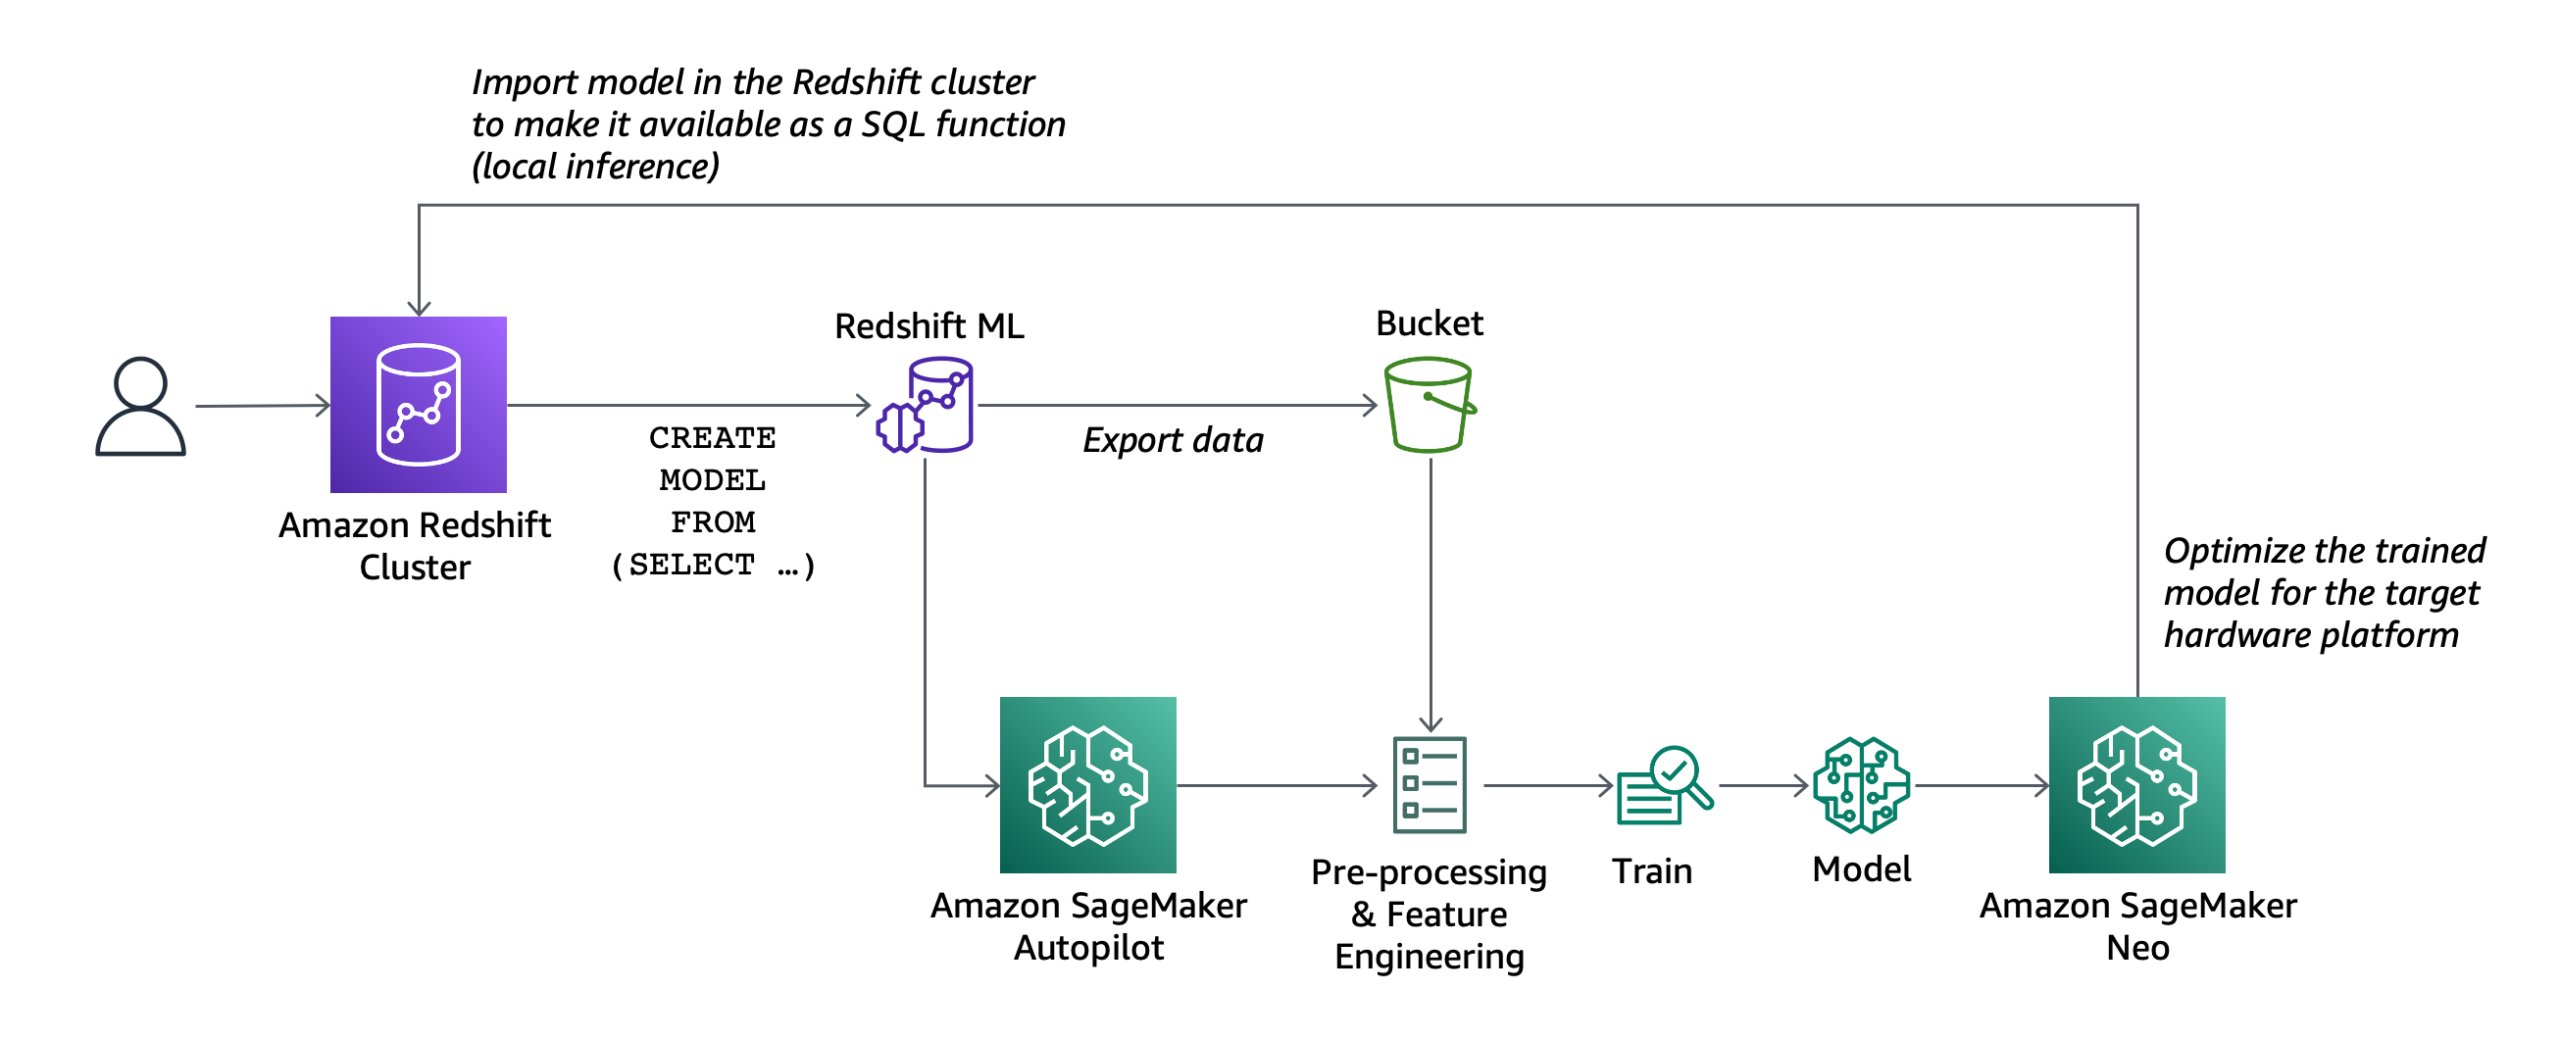
Les types de modèles documentés pour CREATE MODEL comprennent XGBoost, MLP (réseau de neurones multicouche), Linear Learner, K-means et Forecast. Redshift prend aussi en charge le BYOM, pour Bring Your Own Model : vous apportez votre propre modèle et l’utilisez soit en inférence locale, soit en inférence distante. L’inférence locale s’exécute dans Redshift ; l’inférence distante passe par un service externe.
Pour les tâches de langage, Redshift peut aussi s’appuyer sur des modèles de fondation d’Amazon Bedrock, comme Claude ou Amazon Titan. Ils peuvent servir à générer du texte, analyser le sentiment d’un avis ou traduire un contenu. C’est utile quand on veut intégrer ces traitements à un flux de données sans entraîner soi-même un modèle de langage.
Les coûts sont à distinguer. CREATE MODEL entraîne des coûts liés à SageMaker AI et au stockage dans S3. Pour les modèles créés et exécutés sur le cluster, l’inférence n’entraîne pas de frais Redshift supplémentaires. Je ne déduis pas de ces éléments un tarif global : les services utilisés et leur facturation restent à vérifier selon le scénario.
Fabric se positionne différemment dans cet usage : son objectif est davantage d’aider à écrire du T-SQL, le dialecte SQL de Microsoft, que de proposer cette même chaîne d’entraînement et d’inférence de modèles dans Redshift. Je compare donc ici des usages documentés, pas leurs performances ni leurs tarifs.
Que fait Copilot dans Fabric Data Warehouse ?
Copilot aide à écrire et à comprendre du T-SQL dans Fabric Data Warehouse, notamment à partir du langage naturel et du schéma. Le T-SQL est le dialecte SQL utilisé dans l’environnement Microsoft. Copilot peut convertir une demande formulée en langage naturel en requête SQL, compléter du code déjà commencé et proposer les actions Fix pour corriger une requête et Explain pour en expliquer le fonctionnement. Ses suggestions peuvent aussi tenir compte du schéma du warehouse.
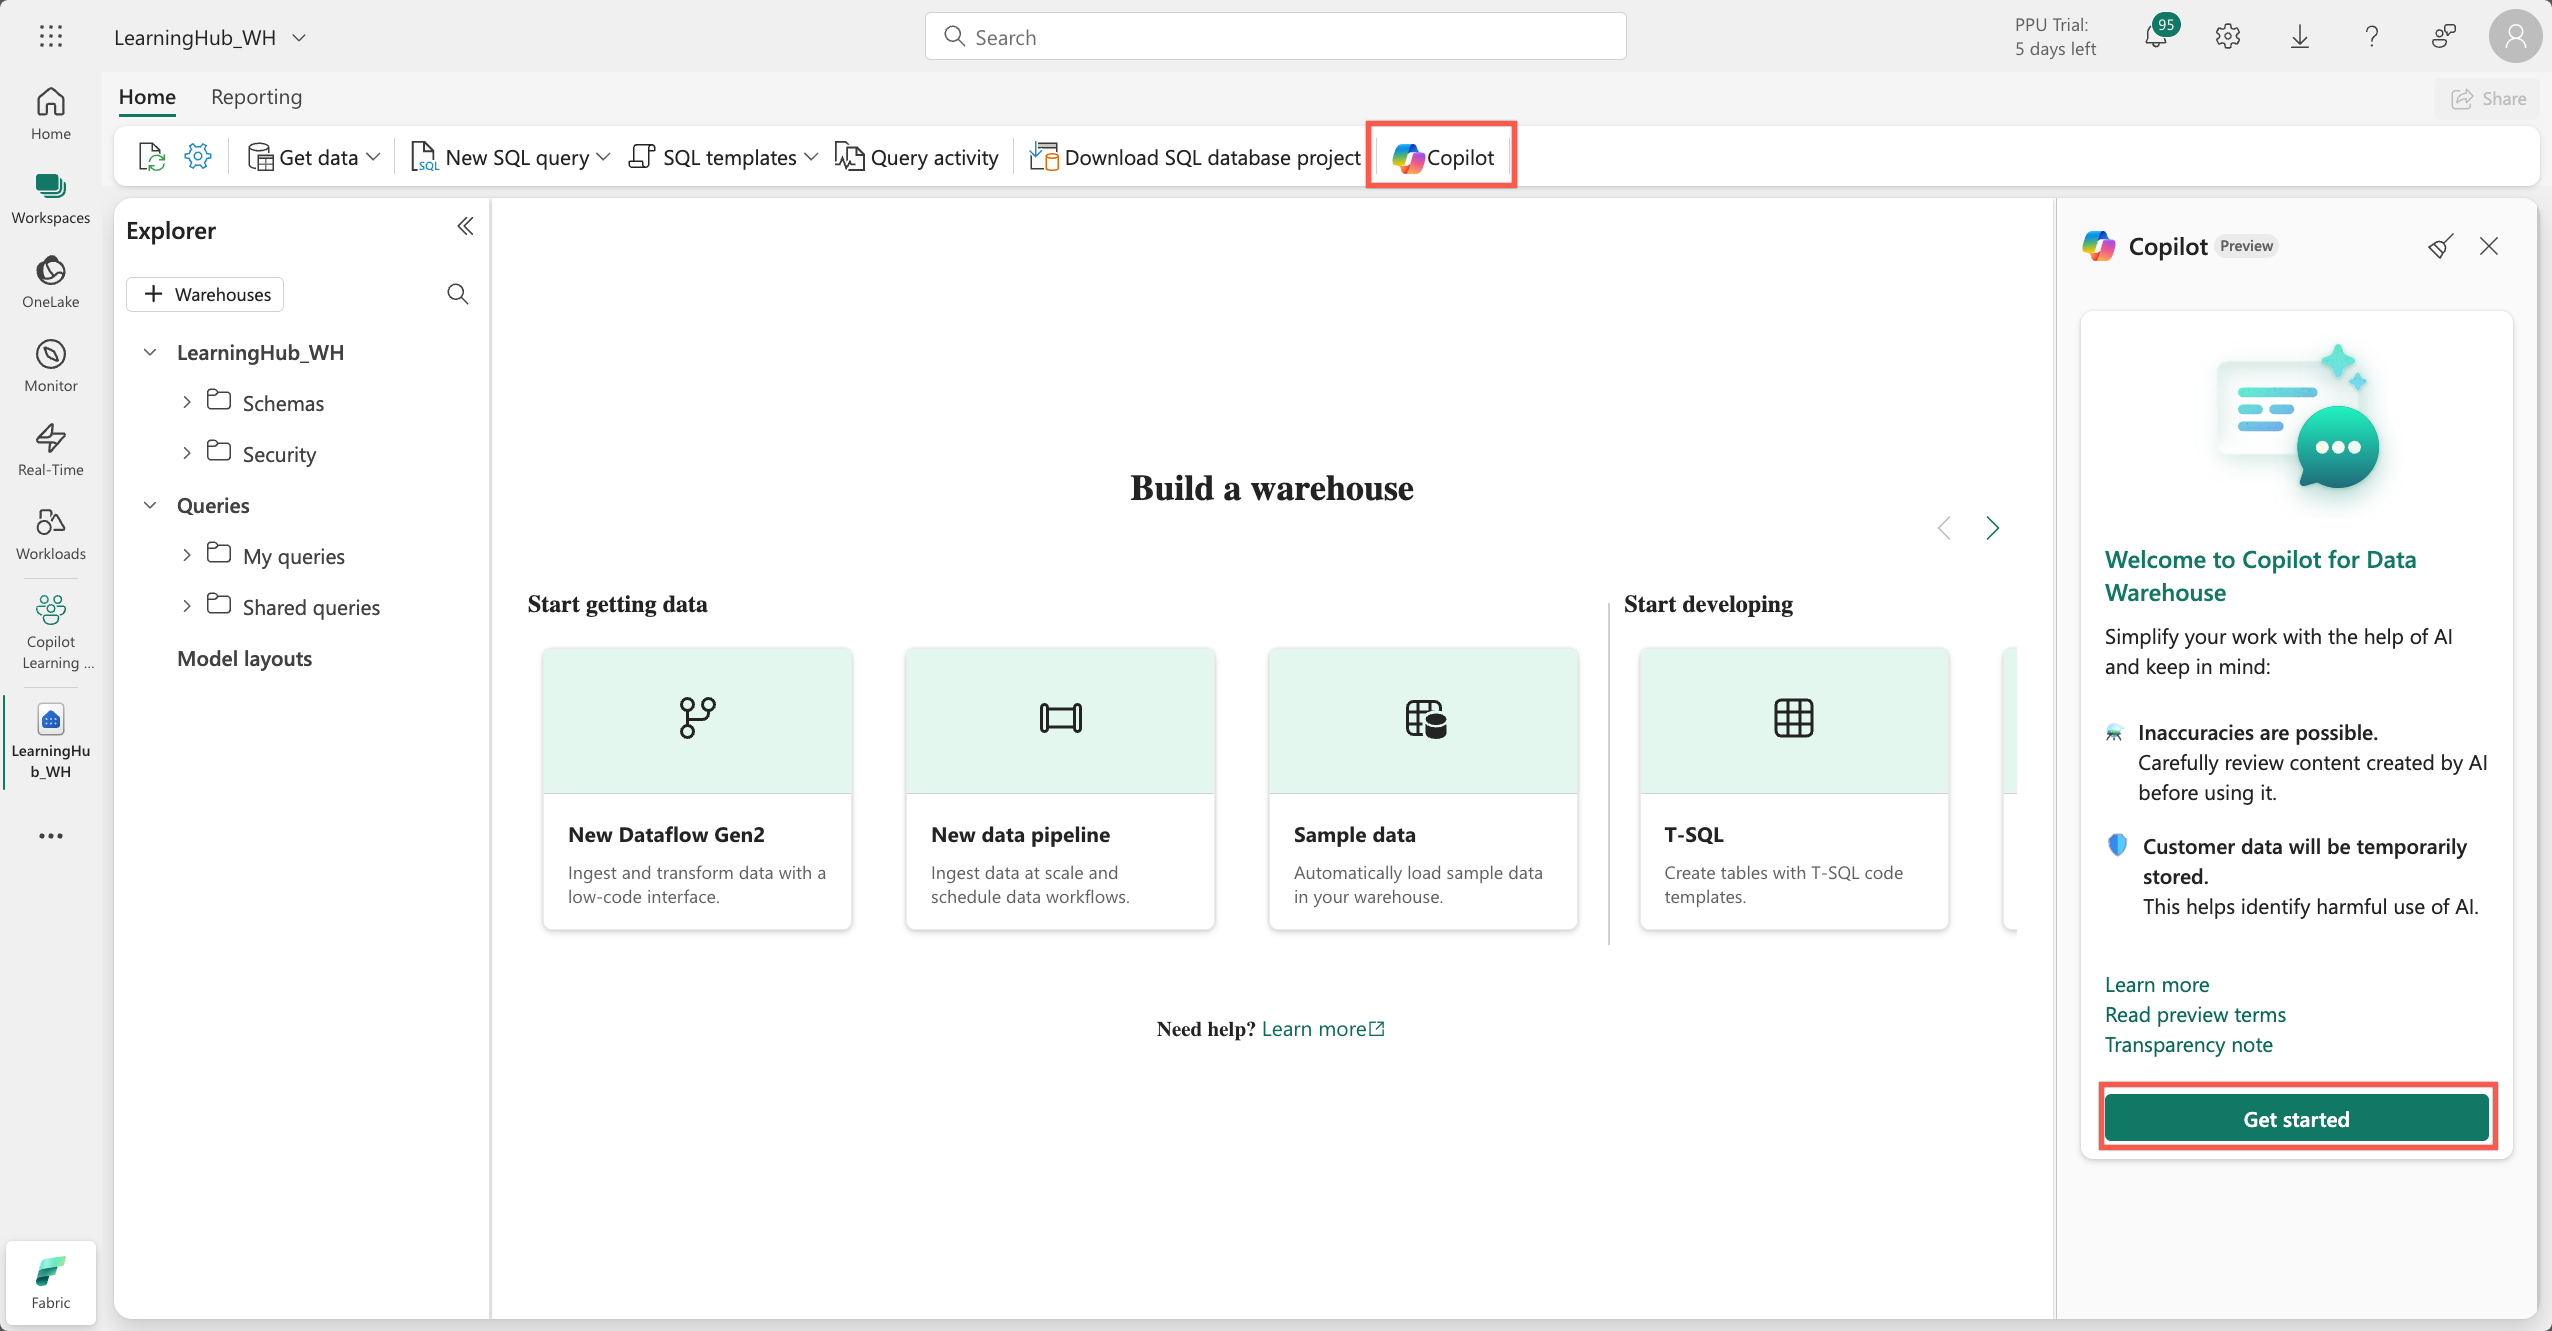
Pour générer du T-SQL, Copilot s’appuie sur les noms des tables et des vues, les noms des colonnes, ainsi que les métadonnées des clés primaires et étrangères. Ces informations décrivent la structure et les relations entre les objets. Copilot n’utilise pas les données contenues dans les tables pour produire ces suggestions. La génération à partir du langage naturel prend actuellement en charge l’anglais.
L’accès dépend de paramètres et de capacités précis. Un administrateur doit activer le paramètre correspondant au niveau du locataire. Le workspace doit utiliser une capacité payante F2 ou supérieure, ou P1 ou supérieure. Les SKU d’essai ne sont pas pris en charge.
Dans Fabric, l’assistance se concentre donc sur la rédaction et la compréhension du T-SQL, avec des suggestions fondées sur le schéma plutôt que sur le contenu des tables. C’est un point important pour comparer les trois approches : BigQuery, Redshift et Fabric ne donnent pas le même rôle à l’IA, ni les mêmes informations sur lesquelles elle s’appuie.
Quel outil choisir selon votre usage de l’IA ?
Le choix dépend du type de travail IA recherché, car BigQuery, Redshift et Fabric ont des approches différentes. Il faut surtout regarder ce que vous voulez faire dans votre entrepôt de données, et les limites qui peuvent affecter votre usage.
BigQuery propose des fonctions IA directement accessibles en SQL. Elles permettent notamment de traiter différents types de données, avec des fonctions d’analyse multimodale. Certaines fonctions disposent d’un mode optimisé indiqué en préversion : son statut peut donc évoluer. Pour l’analyse vidéo avec AI.GENERATE, la durée est limitée à deux minutes.
Redshift couvre plusieurs usages. Redshift ML permet d’entraîner des modèles prédictifs avec SageMaker AI. Redshift peut aussi interagir avec des modèles de Bedrock et prendre en charge des modèles apportés par l’utilisateur, une approche appelée BYOM (« Bring Your Own Model »). L’entraînement avec Redshift ML peut générer des coûts liés à SageMaker AI et à Amazon S3. Ils sont à prendre en compte avant de lancer des entraînements.
Fabric Data Warehouse se distingue ici par l’assistance à la rédaction de T-SQL. Copilot peut s’appuyer sur le schéma de la base pour contextualiser ses suggestions, mais il ne s’agit pas de la même approche que l’entraînement de modèles ou l’analyse multimodale. Son usage dépend de conditions de capacité Fabric, et la prise en charge documentée concerne l’anglais.
Ces différences ne permettent pas d’établir un classement de performance ni de désigner une plateforme qui conviendrait à tous. Le choix dépend de vos tâches IA, de votre environnement et des contraintes que vous pouvez accepter.
| Plateforme | Approche IA | Point d’attention |
| BigQuery | Fonctions IA en SQL, dont l’analyse multimodale | Mode optimisé de certaines fonctions en préversion ; vidéos limitées à deux minutes avec AI.GENERATE |
| Redshift | Entraînement prédictif avec SageMaker AI, modèles Bedrock et BYOM | Coûts SageMaker AI et S3 liés à l’entraînement Redshift ML |
| Fabric Data Warehouse | Assistance à la rédaction de T-SQL contextualisée par le schéma | Conditions de capacité pour Copilot ; prise en charge documentée de l’anglais |
Quel outil correspond le mieux à votre usage ?
BigQuery se distingue par des fonctions IA directement accessibles en SQL, avec des usages multimodaux et des outils pour les embeddings et la classification. Redshift relie les données aux modèles entraînés avec SageMaker AI, aux modèles de fondation Bedrock et aux modèles BYOM, avec des coûts d’entraînement à prendre en compte. Fabric privilégie l’aide à l’écriture de T-SQL à partir du schéma, sous réserve de conditions de capacité et d’une génération actuellement limitée à l’anglais. Les informations disponibles ne permettent pas de classer ces plateformes en performance ni d’affirmer des nouveautés propres à 2026. Votre meilleur choix dépend donc de vos usages. Cette comparaison vous aide à cibler l’option la plus cohérente avec votre environnement et vos besoins.
FAQ
- Quelle plateforme intègre le plus directement l’IA dans SQL ?
BigQuery propose des fonctions IA appelables dans les requêtes SQL, dont AI.GENERATE, AI.GENERATE_TEXT et des fonctions dédiées aux embeddings. - Redshift peut-il utiliser des modèles de fondation ?
Oui. Redshift peut utiliser des modèles de fondation Amazon Bedrock, notamment Claude ou Amazon Titan, pour des tâches comme la génération de texte, l’analyse de sentiment et la traduction. - Copilot dans Fabric analyse-t-il les données des tables ?
Pour générer du T-SQL, Copilot utilise les noms des tables, des vues et des colonnes, ainsi que les métadonnées des clés primaires et étrangères. Il n’utilise pas les données des tables pour ces suggestions. - Quelles sont les conditions d’accès à Copilot dans Fabric Data Warehouse ?
Un administrateur doit activer le paramètre de locataire. Il faut une capacité payante F2 ou supérieure, ou P1 ou supérieure. Les SKU d’essai ne sont pas pris en charge. - Peut-on comparer les performances de ces trois plateformes ?
Les informations présentées ne permettent pas d’établir un classement de performance. Elles décrivent surtout des approches, des fonctions et des conditions d’utilisation différentes.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA et automatisation. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor sur leurs sujets data et analytics. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.