

Avec l’IA dans BigQuery, je peux résumer des avis, extraire des informations structurées et retrouver des contenus proches par leur sens. Je détaille les fonctions SQL à utiliser, puis les points à vérifier sur la qualité des résultats, le rappel et les coûts.
Comment résumer ou structurer du texte ?
AI.GENERATE permet de produire un résumé, une classification ou des champs structurés à partir de données textuelles, directement en SQL dans BigQuery. La fonction renvoie un STRUCT, c’est-à-dire un résultat composé de plusieurs champs : le contenu généré, la réponse complète du modèle et un statut. Je vérifie ce statut avant d’utiliser la sortie, pour ne pas traiter comme valide une réponse qui ne l’est pas.
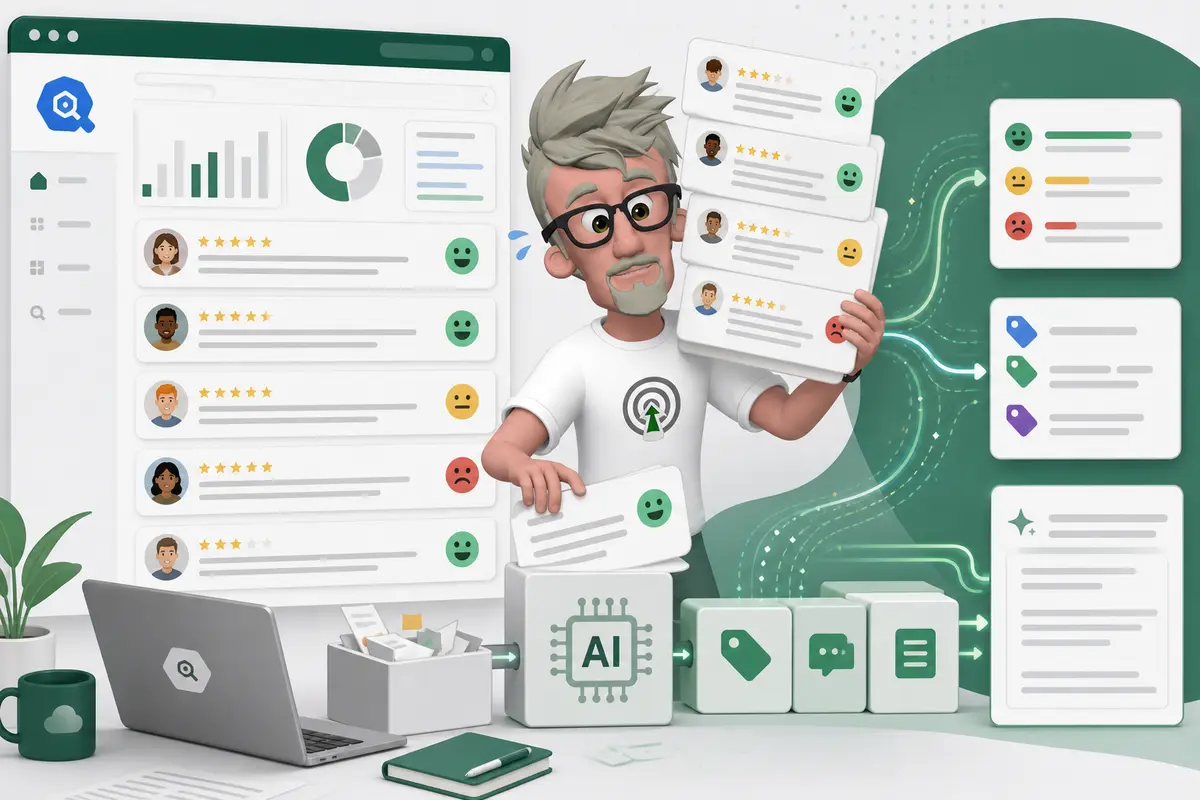
SQL pour résumer des avis
SELECT
  review_id,
  AI.GENERATE(CONCAT('Résume cet avis en une phrase : ', review_text)).result AS resume
FROM `mon-projet.analytics.avis`
LIMIT 20;
Dans cet exemple, CONCAT assemble la consigne et le texte de l’avis. AI.GENERATE envoie ce texte au modèle, et .result récupère le résultat généré. La requête lit la table avis du dataset analytics, dans le projet mon-projet, puis limite la sortie à 20 lignes. Adaptez ces noms à votre projet, votre dataset et votre table. Pour contrôler le statut, récupérez aussi le champ status renvoyé par AI.GENERATE.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
Pour demander une sortie structurée, je peux préciser les champs attendus avec le paramètre output_schema. Ici, le modèle doit produire un nom, un âge et un numéro de téléphone :
AI.GENERATE(
  'Extrais les informations demandées à partir de ce texte : ...',
  output_schema => 'name STRING, age INT64, phone_number STRING'
)
AI.GENERATE accepte aussi des références Cloud Storage et des combinaisons de textes, d’images, d’audio, de vidéo et de PDF. Pour une vidéo de plus de deux minutes, seules les deux premières minutes sont traitées.
Avec VPC Service Controls, une référence avec accès délégué peut échouer. La recommandation documentée est d’utiliser une référence directe créée avec OBJ.MAKE_REF(uri).
Une fois les contenus extraits ou résumés, on peut les représenter sous forme de vecteurs pour les rechercher par le sens. C’est l’étape suivante.
Comment transformer un texte en vecteur ?
AI.EMBED transforme un texte ou une image en embedding, c’est-à-dire en vecteur numérique. Ce vecteur représente le contenu sous une forme que BigQuery peut comparer : des contenus proches dans l’espace numérique ont tendance à être similaires. On peut utiliser ces vecteurs pour la recherche sémantique, les recommandations, la classification, le clustering ou la détection d’anomalies.
Créer un embedding à partir d’un texte
SELECT AI.EMBED('retour produit : taille trop petite', endpoint => 'text-embedding-005');
Dans cet exemple, AI.EMBED génère un vecteur pour le texte fourni, en utilisant l’endpoint indiqué. Un embedding ne conserve pas le texte sous forme de mots : il en produit une représentation numérique exploitable pour comparer des contenus.
La fonction documente plusieurs valeurs pour le paramètre task_type : RETRIEVAL_QUERY, RETRIEVAL_DOCUMENT, CLASSIFICATION et CLUSTERING. Il s’agit des valeurs disponibles ; je ne leur attribue pas ici de comportement particulier.
La documentation mentionne aussi embeddinggemma-300m comme modèle d’embedding intégré, actuellement en aperçu. Dans ce mode, les données restent dans BigQuery, les slots BigQuery sont utilisés et aucun coût Agent Platform n’est facturé. Si vous utilisez plutôt un endpoint hébergé, des frais Agent Platform s’appliquent.
Une fois les vecteurs générés, vous pouvez chercher les contenus les plus proches avec VECTOR_SEARCH. C’est ce qui permet de passer d’une représentation numérique à une recherche fondée sur le sens, plutôt que sur la présence exacte des mêmes mots.
Comment retrouver des contenus proches par le sens ?
VECTOR_SEARCH compare un vecteur de requête aux embeddings stockés dans une table BigQuery et renvoie les contenus dont le sens est le plus proche. Un embedding est une représentation numérique du texte : je peux le conserver dans une colonne de type ARRAY<FLOAT64>.
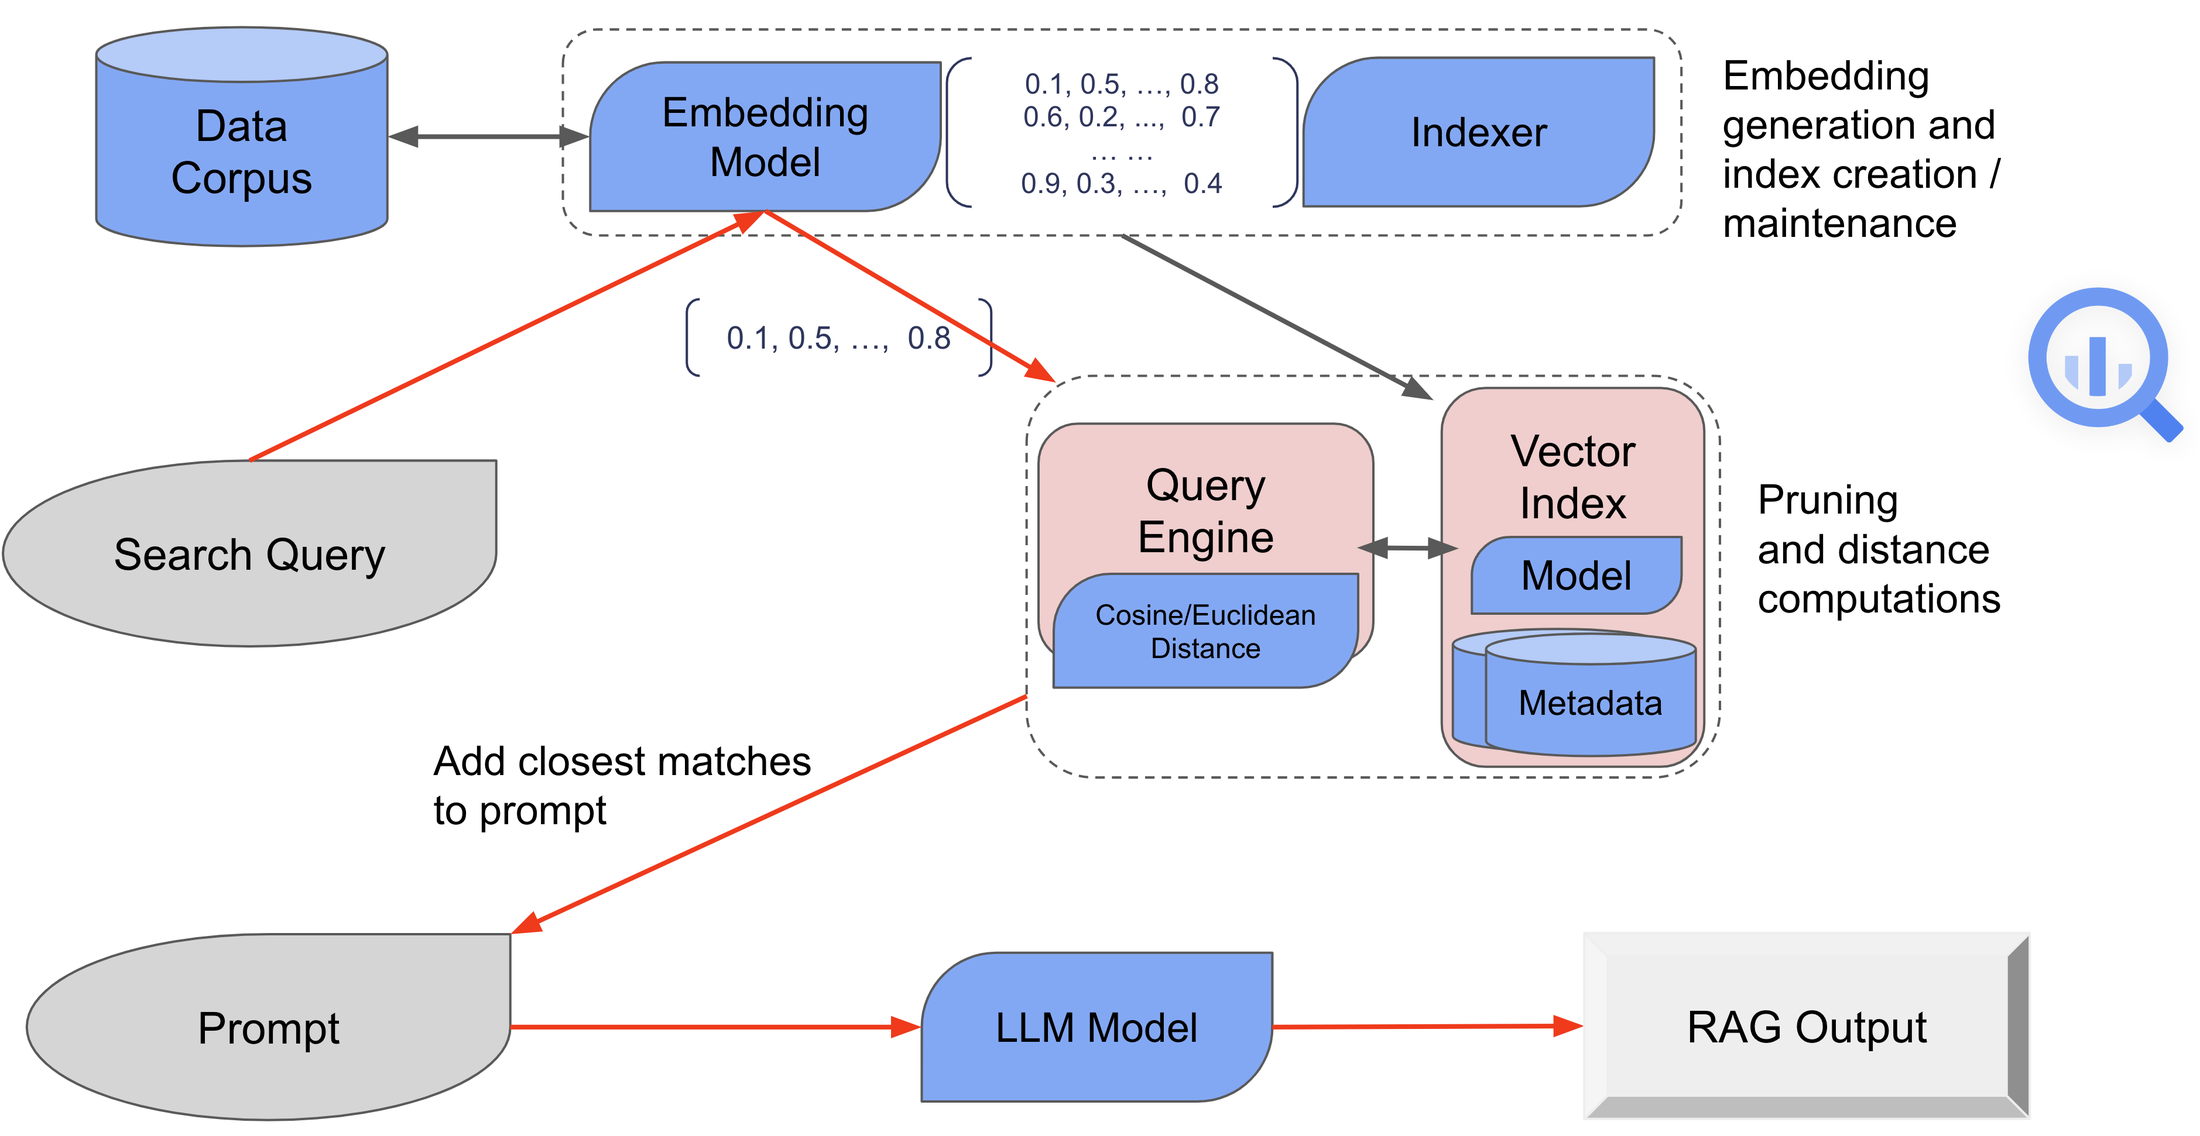
La table doit déjà contenir une colonne d’embeddings, ici nommée embedding. Dans l’exemple, AI.EMBED vectorise la requête à la volée avec le modèle text-embedding-005, puis VECTOR_SEARCH la compare aux vecteurs des documents.
Rechercher cinq documents proches d’une requête
SELECT query.query, base.document_id, base.texte, distance
FROM VECTOR_SEARCH(
  TABLE `mon-projet.analytics.documents`,
  'embedding',
  (
    SELECT
      'conditions de retour d’un achat' AS query,
      AI.EMBED(
        'conditions de retour d’un achat',
        endpoint => 'text-embedding-005'
      ).result AS embedding
  ),
  top_k => 5,
  distance_type => 'COSINE'
);
La table après TABLE contient les documents à comparer. La sous-requête fournit le texte recherché et son embedding. Le paramètre top_k => 5 demande les cinq résultats les plus proches. distance_type => ‘COSINE’ choisit la distance cosinus, une mesure de proximité entre vecteurs ; les résultats les plus proches ont une distance plus faible.
Les noms de projet, de table et de colonnes sont à adapter à votre environnement. Cet exemple illustre le principe ; je ne présente pas ce SQL comme testé tel quel.
La recherche sémantique peut aussi être combinée à un signal lexical, c’est-à-dire la présence de mots exacts dans le texte. Les deux approches se complètent : le sens aide à trouver des formulations différentes, tandis que les mots-clés restent utiles pour des références précises. Je ne donne pas ici de syntaxe de recherche hybride, car sa mise en œuvre dépend de votre requête et de vos données.
Quand le volume de données rend les recherches trop lentes, un index vectoriel peut être envisagé. Il peut accélérer les recherches, avec des compromis sur la précision et les coûts qu’il faut mesurer sur vos propres données.
Quand faut-il créer un index vectoriel ?
Un index vectoriel peut accélérer certaines recherches, mais son intérêt doit être vérifié sur vos données et vos requêtes réelles. Les deux options documentées ne répondent pas aux mêmes usages : le choix dépend notamment du nombre de vecteurs recherchés à la fois.
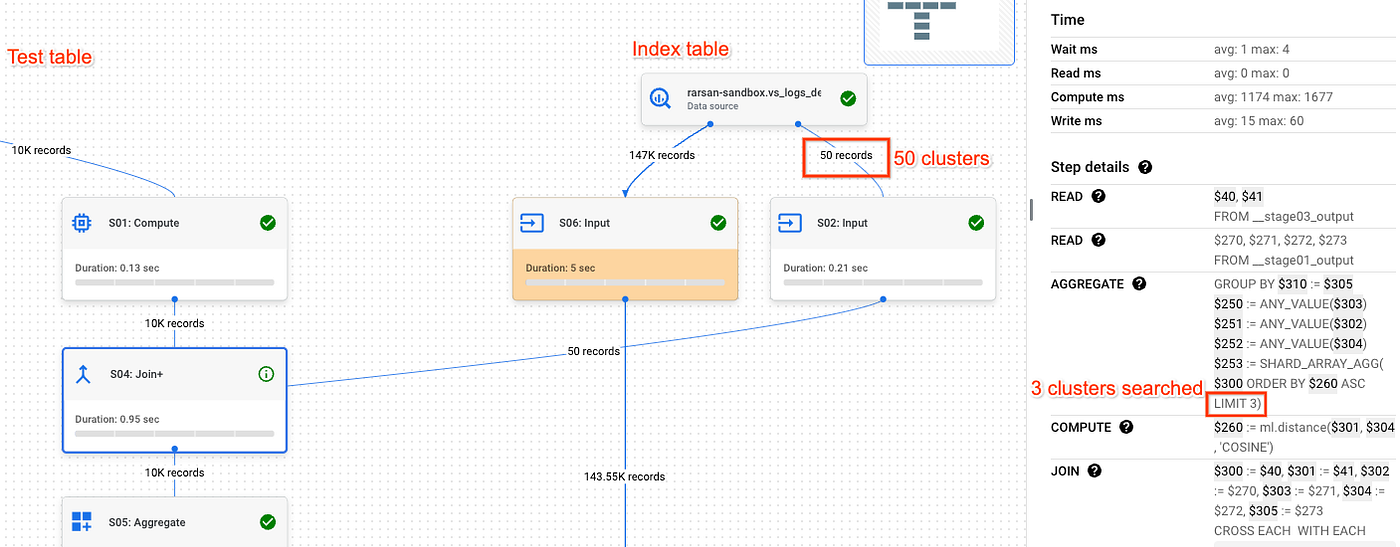
IVF convient aux petits lots de requêtes. TreeAH, qui s’appuie sur ScaNN, est recommandé pour des recherches par lots de centaines de vecteurs ou plus. Pour ces lots importants, TreeAH est décrit comme adapté aux tables de 200 millions de lignes ou moins. Ces indications orientent le choix, mais ne remplacent pas un test sur votre charge de travail.
Il faut aussi tenir compte de la précision. Une recherche avec index renvoie des résultats approximatifs : elle peut ne pas retrouver tous les voisins pertinents, et le rappel peut donc être inférieur à 100 %. Le rappel correspond à la part des résultats pertinents effectivement retrouvés. Pour une application où manquer un résultat a un coût, je le mesure sur un échantillon représentatif avant de retenir l’index.
La recherche vectorielle suit le modèle de facturation de BigQuery. À la demande, le coût dépend des octets analysés ; avec les éditions, il dépend des slots utilisés. Les calculs plus complexes peuvent coûter davantage. Je ne déduis donc pas le coût du seul nombre de lignes : je vérifie le comportement et la consommation sur les requêtes visées.
Avant d’intégrer ces résultats à des KPI, je teste le rappel sur mes propres données, je contrôle le statut renvoyé par AI.GENERATE et je vérifie les sorties produites. Un résultat calculé par l’IA n’est pas automatiquement une donnée validée.
| Usage | Fonction ou mécanisme | Point de vigilance |
| Petits lots de requêtes | IVF | Mesurer le rappel sur les données réelles. |
| Lots de centaines de vecteurs ou plus | TreeAH, fondé sur ScaNN ; adapté aux tables de 200 millions de lignes ou moins pour ces lots. | Les résultats sont approximatifs et le rappel peut être inférieur à 100 %. |
| Estimation des coûts | Octets analysés à la demande ou slots utilisés avec les éditions. | Les calculs plus complexes peuvent coûter davantage. |
Alors, quelle première utilisation tester dans BigQuery ?
BigQuery permet de traiter des textes avec AI.GENERATE, puis de convertir des contenus en vecteurs avec AI.EMBED. VECTOR_SEARCH sert ensuite à retrouver les documents les plus proches, et un index peut accélérer certaines recherches si le volume et le type de requêtes s’y prêtent. Je conseille de vérifier le statut et les réponses générées avant de les intégrer à des KPI, puis de mesurer le rappel et les coûts sur vos propres données. Commencez par un cas concret, comme des avis ou des tickets, et comparez les résultats à vos attentes. Vous saurez ainsi où l’IA vous fait gagner du temps sans perdre de vue la qualité des analyses.
FAQ
- À quoi sert AI.GENERATE dans BigQuery ?
AI.GENERATE permet de résumer, classifier ou extraire des informations structurées à partir de données. La fonction renvoie un résultat généré, la réponse complète du modèle et un statut. - Peut-on extraire des champs structurés avec AI.GENERATE ?
Oui. Le paramètre output_schema permet de définir des champs et leurs types, par exemple name STRING, age INT64 et phone_number STRING. - Quelle est la différence entre AI.EMBED et VECTOR_SEARCH ?
AI.EMBED produit un embedding à partir d’un texte ou d’une image. VECTOR_SEARCH compare les embeddings pour retrouver des contenus proches selon leur sens. - Les recherches avec un index vectoriel sont-elles exactes ?
Les résultats peuvent être approximatifs et le rappel ne pas atteindre 100 %. Il faut tester le rappel sur les données et les requêtes réelles. - Quels coûts faut-il surveiller ?
Un endpoint d’embedding hébergé entraîne des frais Agent Platform. La recherche vectorielle suit le modèle de calcul BigQuery : octets analysés à la demande ou slots utilisés avec les éditions. Les calculs plus complexes peuvent coûter davantage.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Data, IA, Analytics Engineering et automatisation No/Low Code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des équipes sur leurs usages data, notamment chez Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.