

Le comptage distinct approximatif dans Power BI accélère l’analyse, mais peut afficher un résultat différent du chiffre exact. Je montre comment mesurer ce compromis et laisser vos utilisateurs choisir entre rapidité et précision avec un paramètre de champ.
Pourquoi utiliser un comptage distinct approximatif ?
Un comptage distinct approximatif sert à accélérer certains calculs, mais son résultat n’est pas exact. Je l’utilise quand une estimation rapide suffit pour repérer une tendance, pas quand chaque unité compte.
Un comptage distinct mesure le nombre de valeurs différentes dans une colonne. Si une table contient plusieurs lignes pour chaque client, compter les clients distincts revient à compter chaque identifiant client une seule fois. C’est différent du nombre total de lignes, qui inclut les répétitions.
Avec un comptage exact, Power BI calcule le nombre réel de valeurs distinctes. Avec une approximation, le modèle sémantique renvoie une estimation de ce nombre : elle peut être légèrement supérieure ou inférieure au total réel. L’approximation concerne le résultat de ce calcul, pas les données elles-mêmes. Que votre modèle soit en mode Import ou Direct Lake, vos lignes ne sont ni modifiées ni supprimées. C’est la précision du chiffre affiché pour ce comptage qui change.
Le besoin est assez concret. Quand j’explore beaucoup de données, je veux parfois obtenir rapidement un ordre de grandeur pour voir si une tendance mérite d’être creusée. Une estimation peut alors être suffisante. Mais elle ne convient pas à toutes les situations. Pour fixer un objectif, valider un chiffre financier ou prendre une décision sensible, vos utilisateurs peuvent demander une valeur parfaitement exacte.
Je conseille donc de choisir en fonction de l’usage, pas seulement de la vitesse recherchée. L’approximation est utile pour explorer, à condition que les utilisateurs sachent qu’il s’agit d’une estimation et qu’une valeur exacte reste disponible quand ils en ont besoin. Le chapitre suivant compare les performances et la précision.
Quel est le compromis entre vitesse et précision ?
L’approximation peut réduire le temps de calcul et le temps CPU, mais elle peut aussi consommer davantage de mémoire et produire un résultat différent. Le gain de vitesse n’est donc pas gratuit.
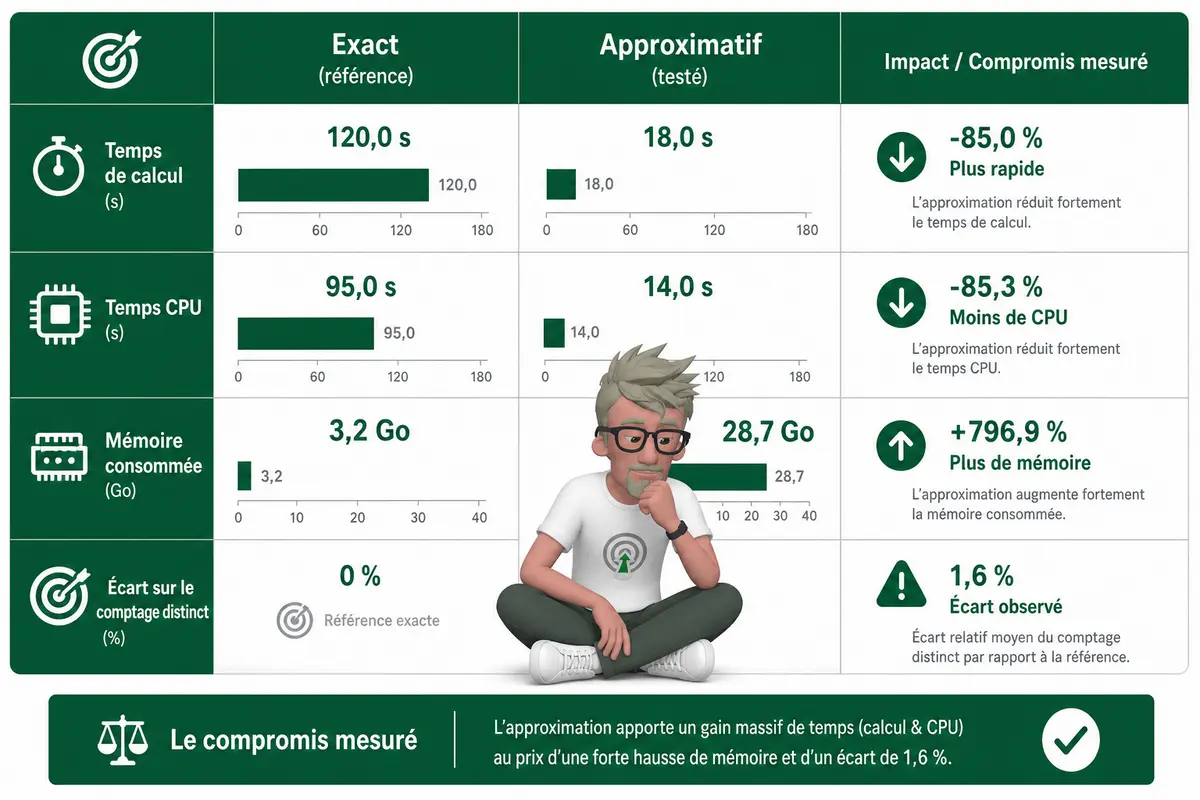
Sur un modèle Direct Lake contenant 1,4 milliard de lignes de données de taxis de New York, le comptage distinct exact par date prend environ 6 secondes. Il utilise 82 secondes de temps CPU et 206 294 Ko de mémoire. Le comptage approximatif prend environ 4 secondes et utilise 48 secondes de CPU, mais sa consommation mémoire monte à 1 063 476 Ko.
Dans ce test, le résultat approximatif s’écarte d’environ 1,6 % de la valeur exacte. Sur un graphique, les deux résultats peuvent sembler visuellement indiscernables. Mais une courbe qui paraît identique ne garantit pas que l’écart soit sans conséquence.
Si le chiffre sert à suivre une tendance générale, cette différence peut être acceptable. S’il déclenche une décision autour d’un seuil — un objectif commercial, une facturation ou un contrôle réglementaire, par exemple — même un faible écart peut changer la conclusion. Et quand les volumes sont répartis entre de nombreuses petites catégories, l’erreur peut être plus visible sur certains segments que sur le total.
Ces mesures décrivent un test précis, pas une règle générale. Les performances et la mémoire consommée dépendent du modèle, des données, de la requête et de l’environnement d’exécution. Il faut donc comparer les deux méthodes sur vos propres rapports, puis vérifier que le niveau d’erreur convient à l’usage métier.
| Critère | Comptage exact | Comptage approximatif |
| Temps de calcul | Environ 6 s | Environ 4 s |
| Temps CPU | 82 s | 48 s |
| Mémoire | 206 294 Ko | 1 063 476 Ko |
| Exactitude | Valeur de référence | Écart observé d’environ 1,6 % |
Comment laisser choisir le niveau de précision ?
Oui. Je laisse l’utilisateur choisir avec deux mesures et un paramètre de champ. Le comptage approximatif est sélectionné par défaut pour explorer rapidement les tendances ; le comptage exact reste disponible quand une décision exige un chiffre précis.
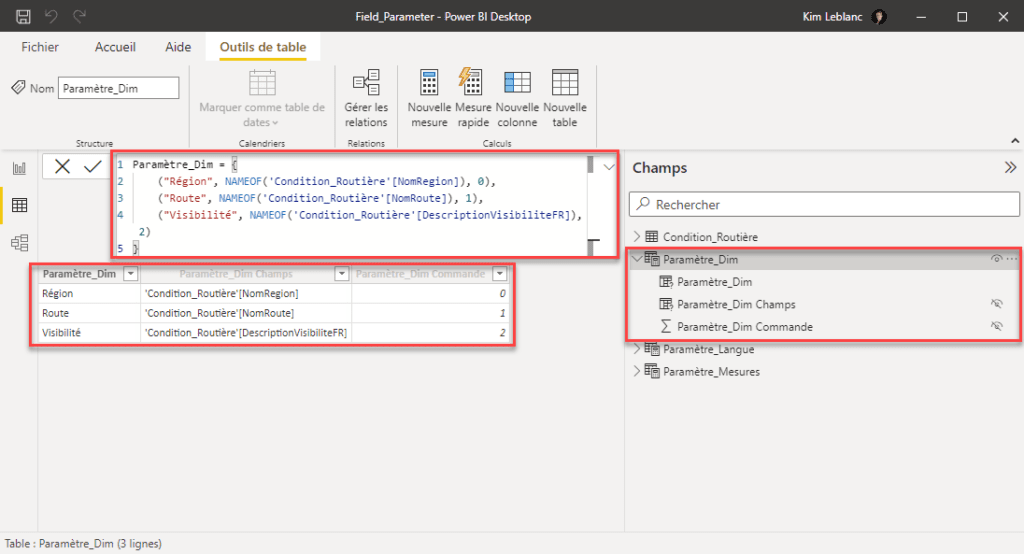
Dans cet exemple, j’utilise la table « Ventes » et la colonne « IdClient ». Remplacez ces noms par ceux de votre modèle. Vérifiez aussi qu’APPROXIMATEDISTINCTCOUNT est disponible dans votre environnement Power BI et compatible avec votre source de données.
// Compte exactement les clients distincts.
Clients exacts =
    DISTINCTCOUNT ( 'Ventes'[IdClient] )

// Produit une estimation du nombre de clients distincts.
Clients approximatifs =
    APPROXIMATEDISTINCTCOUNT ( 'Ventes'[IdClient] )
Créez ensuite un paramètre de champ qui référence les deux mesures avec NAMEOF. Dans Power BI Desktop, utilisez Modélisation > Nouveau paramètre > Champs, puis sélectionnez les mesures. La structure DAX générée ressemble à ceci :
Choix du comptage = {
    // L’estimation est proposée en premier.
    ("Approximatif", NAMEOF('Mesures'[Clients approximatifs]), 0),
    ("Exact", NAMEOF('Mesures'[Clients exacts]), 1)
}
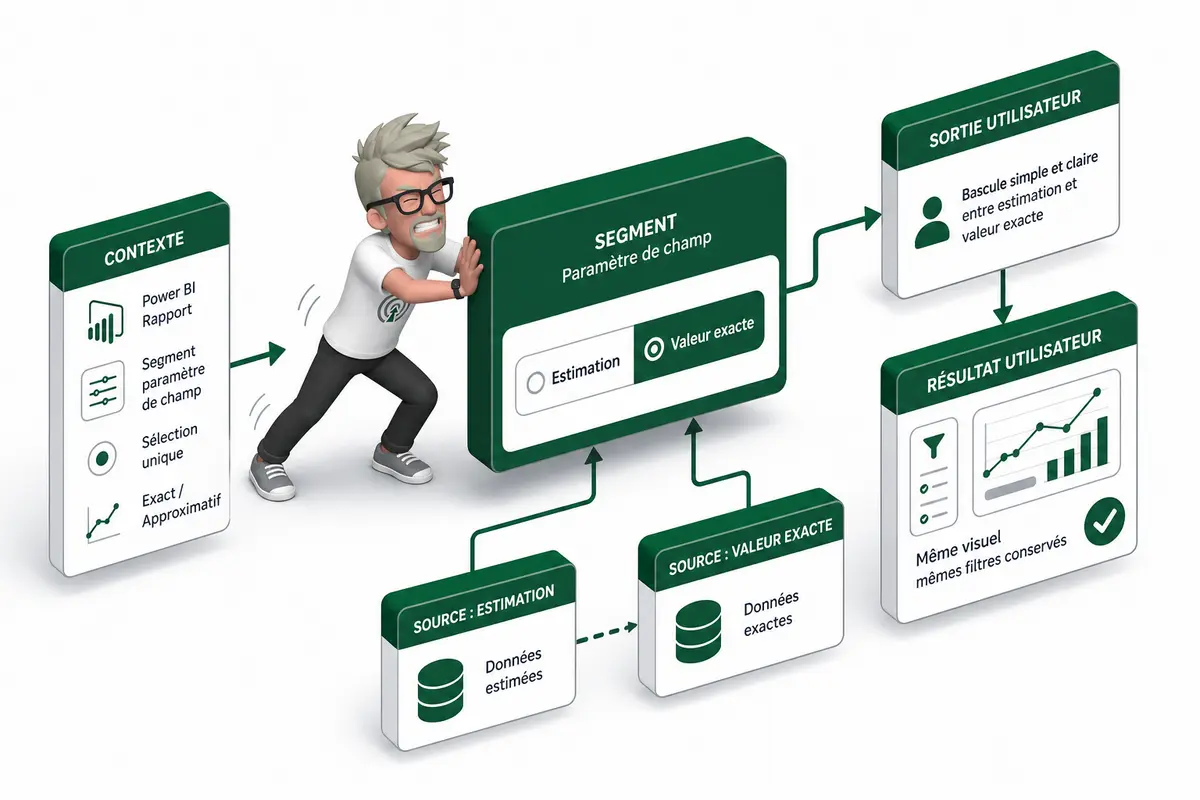
Adaptez « Mesures » au nom de la table qui contient vos mesures. Ajoutez « Choix du comptage » dans un segment, puis glissez ce même paramètre dans la zone Valeurs du visuel à piloter. Dans les options du segment, activez la sélection unique et choisissez « Approximatif ». Enregistrez le rapport dans cet état : il s’ouvrira alors sur l’estimation.
Le parcours reste simple : vous regardez d’abord les tendances avec le comptage approximatif, puis vous sélectionnez « Exact » si un chiffre doit soutenir une décision ou être communiqué comme valeur précise. L’estimation peut différer du résultat exact. Les performances dépendent du modèle, de la source et du contexte de calcul ; je ne partirais pas du principe que l’une des deux options sera toujours plus rapide.
Comment déployer ce choix sans brouiller les résultats ?
Je rends le choix visible et explicite dans le rapport, puis je vérifie les deux options dans les visuels concernés. Un résultat approximatif ne doit jamais se faire passer pour un résultat exact : l’utilisateur doit pouvoir comprendre ce qu’il regarde et changer de mode sans ambiguïté.
Je nomme les mesures et le paramètre avec des libellés qui indiquent clairement le niveau de précision. Par exemple, j’utilise « Clients distincts — exact » et « Clients distincts — estimation », puis un paramètre intitulé « Mode de comptage : exact ou approximatif ». J’évite les noms techniques comme « DISTINCTCOUNT_APPROX », qui sont parlants pour la personne qui a construit le modèle, mais pas forcément pour celle qui consulte le rapport.
Je teste les deux choix sur les mêmes visuels, avec les mêmes filtres et les mêmes segments. Je contrôle que le paramètre bascule bien entre les mesures et que les nombres affichés correspondent aux résultats attendus. Puis je mesure les performances sur le modèle concerné : un gain constaté ailleurs ne garantit rien pour vos données, votre volumétrie ou votre environnement.
Je relève les mêmes dimensions pour chaque option :
- La durée de calcul, pour voir combien de temps le visuel met à répondre.
- Le temps CPU, qui indique la charge de calcul sollicitée.
- La mémoire utilisée pendant la requête.
- L’écart entre le résultat approximatif et le résultat exact.
Je ne traite pas les chiffres d’un test comme des seuils universels. Ils servent à comparer les deux options dans votre contexte, avec vos usages réels. Si l’écart est acceptable et que le gain de performance est utile, l’approximation favorise l’exploration, notamment quand les utilisateurs filtrent souvent de gros volumes. Le choix exact reste disponible dès que la précision est indispensable, par exemple pour un chiffre communiqué officiellement ou utilisé dans une décision sensible.
Alors, quelle option choisir dans votre rapport ?
Le comptage distinct approximatif peut accélérer l’exploration dans Power BI, mais il ne renvoie pas toujours le chiffre exact. Le test présenté montre aussi un compromis moins évident : le calcul approximatif est plus rapide et utilise moins de temps CPU, mais consomme davantage de mémoire. Je préfère donc éviter d’imposer une seule option à tous les usages. Avec deux mesures et un paramètre de champ, vos utilisateurs peuvent parcourir les tendances rapidement, puis basculer vers le comptage exact lorsqu’ils en ont besoin. Les performances et l’écart doivent être vérifiés sur votre modèle. Vous gardez ainsi un rapport rapide sans renoncer à la précision nécessaire pour décider.
FAQ
- Qu’est-ce qu’un comptage distinct approximatif dans Power BI ?
C’est un calcul du nombre de valeurs distinctes qui fournit une estimation plutôt qu’un résultat garanti exact. Il peut accélérer l’analyse, mais le chiffre peut différer du comptage exact. - Quelle différence entre DISTINCTCOUNT et ApproximateDistinctCount ?
DISTINCTCOUNT sert à obtenir le comptage exact. ApproximateDistinctCount fournit une estimation. Le choix dépend de votre besoin de précision et des performances observées dans votre modèle. - De combien le résultat approximatif peut-il différer ?
Dans le test décrit, l’écart observé est d’environ 1,6 %. Ce chiffre concerne ce modèle et ce test ; il ne constitue pas une garantie pour tous les rapports. - Pourquoi le calcul approximatif peut-il consommer plus de mémoire ?
Le test Direct Lake présenté montre une consommation mémoire plus élevée pour le comptage approximatif : 1 063 476 Ko, contre 206 294 Ko pour le comptage exact. Il faut donc mesurer les ressources sur votre propre modèle. - Comment laisser les utilisateurs choisir entre les deux calculs ?
Créez une mesure exacte et une mesure approximative, puis exposez-les via un paramètre de champ dans un segment. Vous pouvez sélectionner l’approximation par défaut et laisser les utilisateurs passer au résultat exact lorsqu’ils en ont besoin.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, analytics engineering, tracking server-side, automatisation no/low-code et intégration de l’IA. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.