

Alteryx Live Query automatise l’extraction et la validation des factures PDF en s’appuyant sur Google BigQuery, sans déplacer les données gouvernées hors de l’entrepôt. Voici comment organiser le workflow, mobiliser Document AI ou Gemini et traiter les exceptions avec davantage de traçabilité.
Pourquoi automatiser le traitement des factures PDF ?
Automatiser le traitement des factures PDF réduit les manipulations manuelles et permet de repérer plus tôt les erreurs, les anomalies et les doublons. Avec Alteryx Live Query et BigQuery, le workflow peut extraire les champs utiles, les standardiser, puis les comparer aux historiques gouvernés sans déplacer systématiquement l’ensemble des données.
Le problème tient au format même des factures. Elles arrivent en PDF, avec des mises en page, des libellés et des niveaux de qualité différents. Une date peut être présentée de plusieurs façons, un montant peut apparaître dans plusieurs zones, et certaines pièces sont des scans plutôt que des documents texte. Pour les équipes financières et opérationnelles, cette variabilité complique la saisie, la validation et le rapprochement avec les commandes ou les factures déjà traitées.
L’extraction manuelle expose à des erreurs de saisie et à des omissions. Quand les contrôles sont répartis entre fichiers, outils et équipes, un doublon ou un écart de montant peut passer inaperçu. Le workflow vise à centraliser ces vérifications : extraire les informations pertinentes, appliquer des règles de normalisation, puis comparer les résultats aux données historiques disponibles dans BigQuery.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
Les bénéfices recherchés sont une part plus importante de traitement automatisé, un rapprochement plus rapide, moins d’exceptions à traiter manuellement, une meilleure traçabilité des contrôles et une limitation des déplacements de données grâce à Live Query. Ce sont des objectifs de conception, pas des résultats garantis : ils dépendent notamment de la qualité des PDF, des règles de contrôle et de la configuration du workflow.
Le chapitre suivant détaille le rôle de chaque composant : Cloud Storage conserve les fichiers entrants, Alteryx orchestre l’extraction et les contrôles, et BigQuery fournit les historiques gouvernés auxquels les factures sont comparées.
Comment s’organise l’architecture avec BigQuery ?
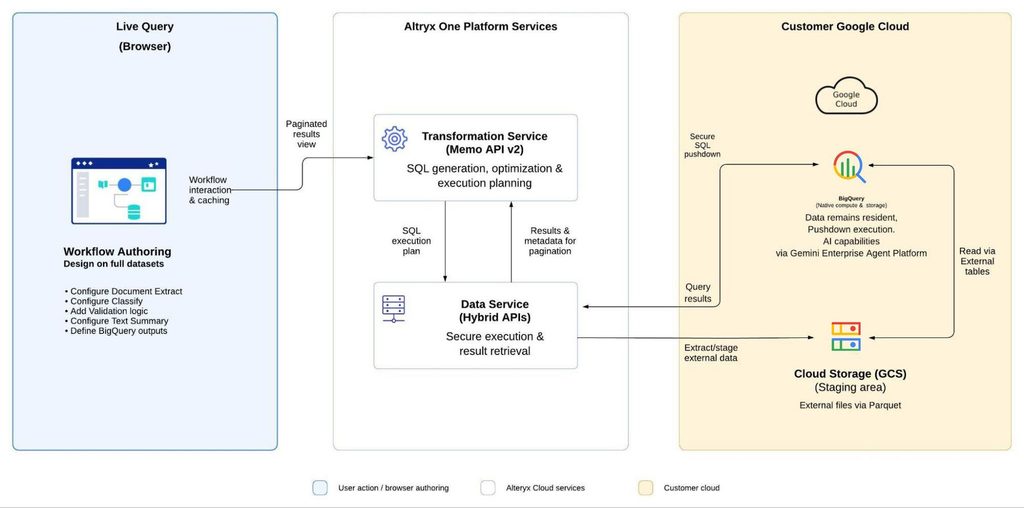
Les factures PDF sont hébergées dans Cloud Storage. Un workflow visuel créé dans Alteryx Live Query les traite, rapproche les résultats des données historiques conservées dans BigQuery, puis réécrit les sorties dans BigQuery. Les transformations s’exécutent directement dans BigQuery.
Chaque composant a un rôle distinct. Cloud Storage héberge les documents PDF. BigQuery conserve les historiques utilisés pour le rapprochement et les résultats produits. Live Query permet de créer le workflow dans le navigateur et d’exécuter les transformations directement dans BigQuery. Les services Alteryx coordonnent l’exécution et apportent de la traçabilité et de l’observabilité sur le traitement.
Cette organisation limite les déplacements de données : les transformations sont exécutées dans BigQuery, au plus près des données historiques et des résultats. Il ne s’agit pas d’affirmer qu’aucune donnée ne circule, mais de réduire les transferts nécessaires au workflow. Cette limitation facilite le contrôle des traitements et s’inscrit dans une logique de gouvernance des données : les documents, les historiques et les résultats restent associés aux composants prévus pour les héberger ou les traiter.
Les rôles se résument ainsi :
- Cloud Storage : hébergement des factures PDF.
- Alteryx Live Query : création du workflow dans le navigateur et exécution des transformations dans BigQuery.
- Services Alteryx : coordination de l’exécution, traçabilité et observabilité.
- BigQuery : conservation des historiques et des résultats, rapprochement des données et réécriture des sorties.
Comment extraire les données avec Document Extract ?
Dans Alteryx Live Query, l’outil Document Extract lit les factures PDF déposées dans Cloud Storage et en extrait les informations à l’aide d’un modèle choisi, comme Gemini ou Document AI. Le workflow est conçu visuellement dans Alteryx Live Query : on assemble les étapes de traitement sans écrire le flux sous forme de code.
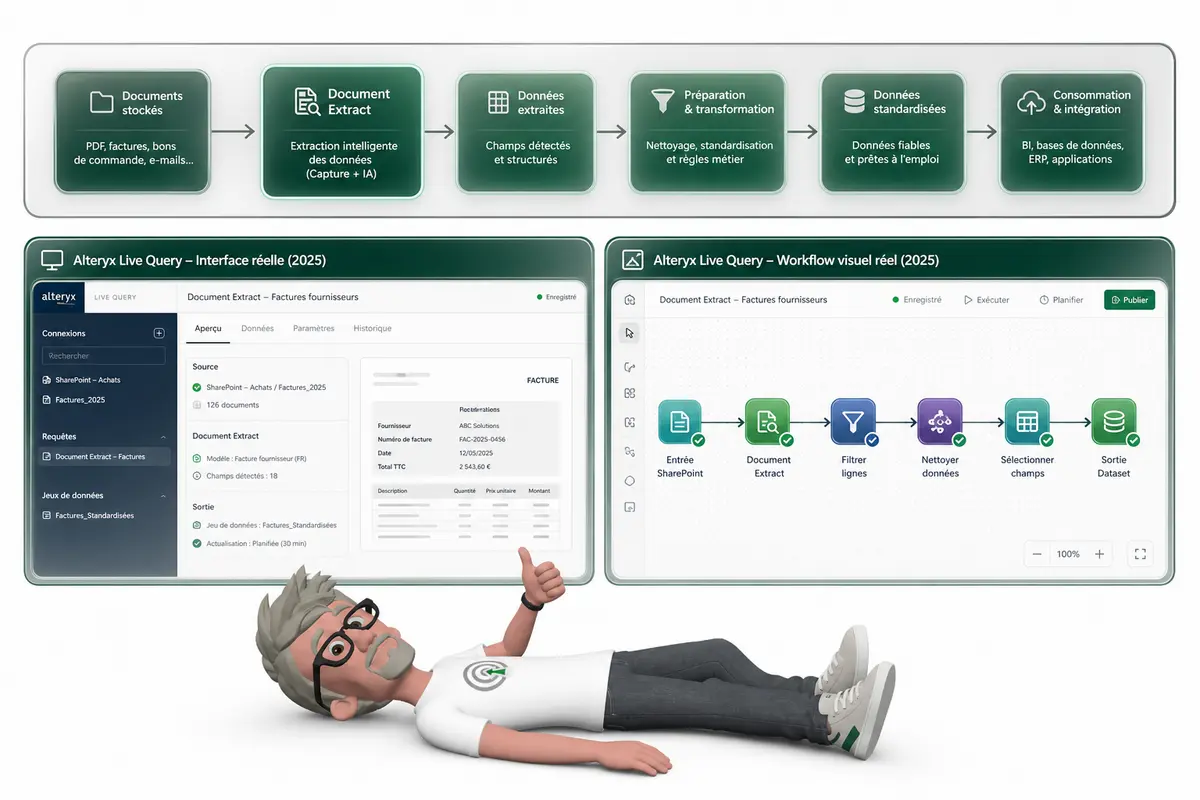
Le traitement suit le parcours du document, de son dépôt jusqu’à des résultats exploitables :
- Dépôt : Les factures PDF sont placées dans Cloud Storage, où elles deviennent accessibles au workflow.
- Sélection du modèle : Le workflow utilise un modèle d’extraction, par exemple Gemini ou Document AI.
- Extraction : Document Extract analyse le contenu des factures et en extrait les informations disponibles.
- Standardisation : Les résultats sont mis dans une forme cohérente afin de faciliter leur utilisation dans les étapes suivantes.
Cette standardisation compte parce que les factures n’ont pas toutes la même mise en page ni la même organisation. Les traiter avant le rapprochement évite de comparer directement des données présentées sous des formats différents. Le rapprochement consiste ici à vérifier la correspondance entre les informations extraites des factures et les données de référence.
Le modèle reste un choix du workflow : Gemini et Document AI sont deux possibilités, sans qu’il soit nécessaire de présumer de champs extraits, de paramètres ou d’appels d’API spécifiques. La logique métier dépend ensuite de la manière dont les résultats doivent être contrôlés et exploités.
Une fois les informations extraites et standardisées, l’étape suivante consiste à valider les résultats dans BigQuery. Cette vérification permet de repérer les données à examiner avant de les utiliser pour le rapprochement ou d’autres traitements.
Comment valider les factures et gérer les exceptions ?
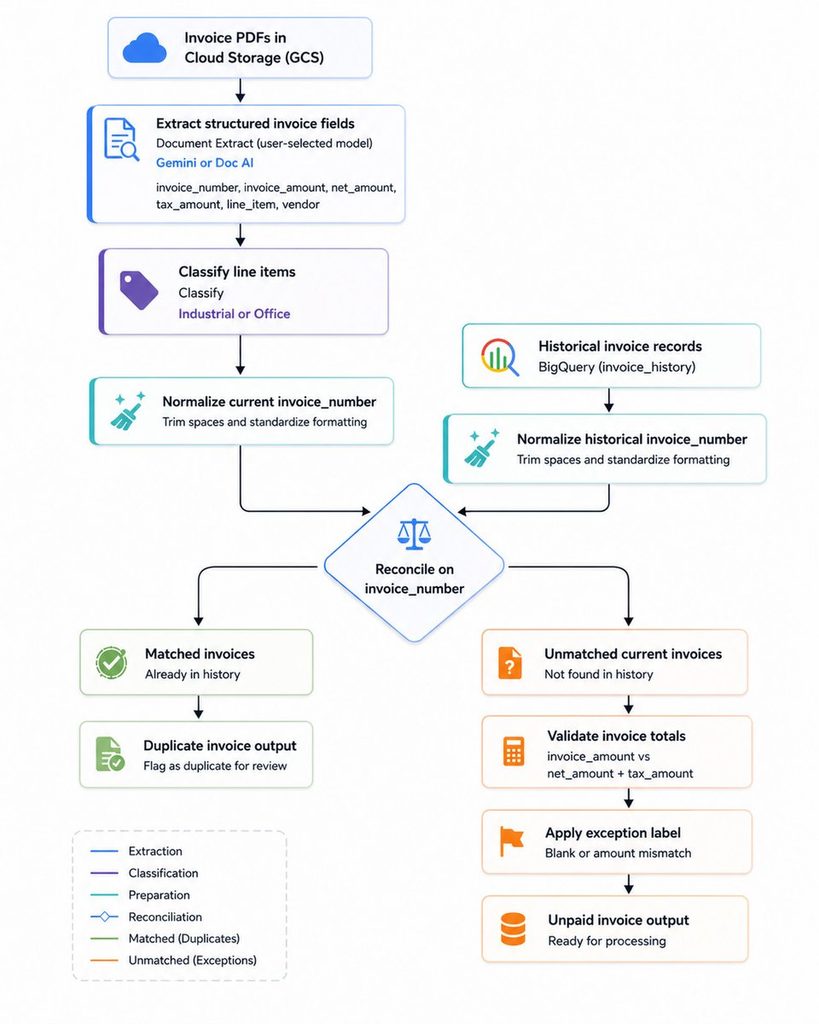
Les résultats extraits et standardisés sont comparés aux historiques de factures conservés dans BigQuery. Cette comparaison sert à repérer des anomalies et des doublons ; les résultats sont ensuite enregistrés dans BigQuery. L’objectif est d’accélérer le rapprochement et de réduire le traitement manuel des exceptions, pas de les supprimer.
Valider les champs extraits ne revient pas à détecter des exceptions. La validation porte sur les valeurs récupérées et standardisées : elle permet de vérifier qu’elles sont exploitables au regard des exigences configurées. Les règles précises dépendent du paramétrage et ne peuvent pas être déduites ici. La détection d’exceptions intervient dans un autre temps : elle compare les résultats aux factures historiques pour signaler les écarts ou les doublons à examiner.
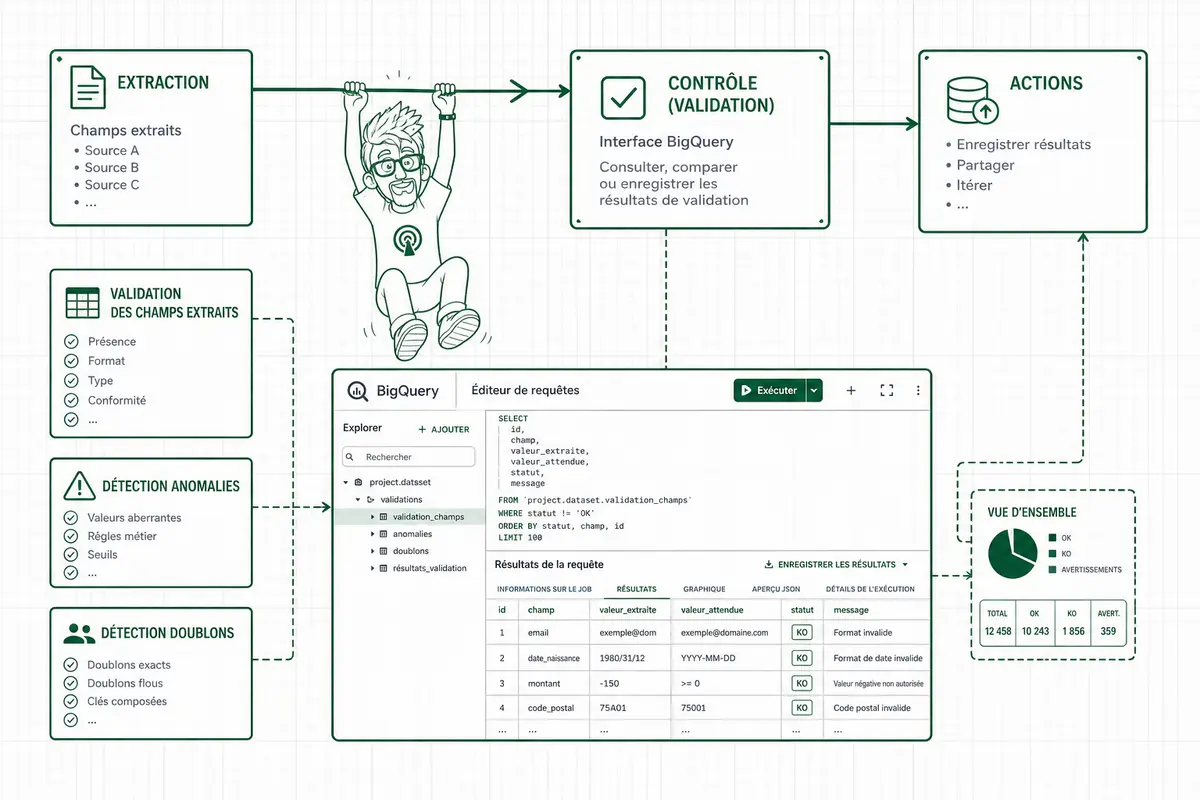
Les historiques apportent donc un contexte au rapprochement : une facture n’est pas évaluée uniquement à partir de son PDF, mais aussi par rapport aux données déjà conservées. Le résultat peut nécessiter une vérification humaine. Dans les projets que j’observe, c’est cette distinction qui évite de traiter chaque document comme une exception tout en gardant un contrôle sur les cas signalés.
Le traitement et l’enregistrement dans BigQuery s’inscrivent aussi dans une logique de gouvernance : les données restent dans l’environnement analytique prévu, ce qui facilite leur contrôle et limite les déplacements entre systèmes. Le flux ne garantit pas l’absence d’erreurs ; il rend le rapprochement plus systématique et les exceptions plus ciblées.
| Étape | Rôle |
| Extraire | Récupérer les données des factures PDF. |
| Standardiser | Mettre les résultats extraits dans un format exploitable. |
| Comparer | Confronter les résultats aux historiques de factures dans BigQuery. |
| Acheminer | Orienter les résultats vers la suite du traitement ou la gestion des exceptions. |
| Enregistrer | Conserver les sorties dans BigQuery pour le contrôle et l’exploitation. |
Que retenir pour votre workflow de factures PDF ?
Alteryx Live Query et BigQuery permettent de structurer un workflow de traitement des factures PDF sans déplacer les données gouvernées hors de l’entrepôt. Les documents sont déposés dans Cloud Storage, les champs sont extraits avec Document Extract et un modèle comme Gemini ou Document AI, puis standardisés et rapprochés des historiques BigQuery. Les anomalies et doublons peuvent ainsi être repérés, tandis que les résultats sont réécrits dans BigQuery. Alteryx apporte une conception visuelle, ainsi que des capacités de coordination, de traçabilité et d’observabilité. Le bénéfice pour vos équipes : un traitement plus automatisé, un rapprochement plus rapide et un meilleur contrôle des exceptions et des données.
FAQ
- À quoi sert Alteryx Live Query avec BigQuery ?
À concevoir visuellement et exécuter des workflows de transformation directement dans BigQuery, notamment pour traiter des factures PDF et rapprocher les résultats des données historiques. - Où sont stockées les factures PDF ?
Les factures sont déposées dans Google Cloud Storage avant d’être traitées par le workflow Alteryx Live Query. - Quels modèles peuvent extraire les champs des factures ?
Document Extract peut utiliser un modèle choisi, tel que Gemini ou Document AI, pour extraire les champs des documents. - Comment le workflow repère-t-il les anomalies et les doublons ?
Les résultats extraits et standardisés sont comparés aux historiques de factures conservés dans BigQuery afin de faire ressortir les anomalies et les doublons. - Les données gouvernées doivent-elles sortir de BigQuery ?
L’exécution des transformations directement dans BigQuery limite les déplacements de données et contribue à préserver la sécurité, la gouvernance et le contrôle.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur indépendant en data engineering, analytics et automatisation IA depuis plus de 15 ans. Fondateur de l’agence Le Web Analyste et de l’organisme Formations Analytics, j’accompagne les entreprises dans la conception de workflows data fiables, gouvernés et automatisés. Dispo pour aider les entreprises : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.