

BigQuery permet d’analyser les événements bruts de GA4 et de les rapprocher des données CRM, commerciales ou produit. Pour obtenir des analyses fiables, il faut d’abord cadrer les décisions, contrôler les données, gouverner les indicateurs et tester les rapports automatisés.
Que cadrer avant d’analyser GA4 ?
Avant toute analyse dans BigQuery, je définis les décisions que les données doivent éclairer et les règles qui rendent ces données exploitables. Sans ce cadrage, on risque de produire des rapports cohérents techniquement, mais inutiles pour trancher.
Je précise d’abord chaque métrique : sa définition, son périmètre, sa période et les événements GA4 qui la composent. Une « conversion », par exemple, doit correspondre à une règle explicite, pas à une interprétation différente selon le rapport. Je liste aussi les sources concernées : export GA4, données de ventes, dépenses publicitaires ou référentiels internes. Pour chacune, je désigne un responsable capable de confirmer la définition et de signaler les changements de collecte.
Avant de rapprocher les sources, je fixe les règles de correspondance : identifiant utilisé, niveau de détail, fuseau horaire et traitement des doublons ou des valeurs absentes. C’est souvent là que les écarts apparaissent. Un rapprochement au niveau utilisateur ne donne pas le même résultat qu’un rapprochement par session ou par transaction.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
Je vérifie ensuite que les données sont suffisamment récentes et complètes pour l’usage prévu. Ces contrôles doivent être documentés avec leurs conséquences :
- La date la plus récente disponible permet de repérer un retard d’arrivée des données.
- La présence des périodes et des événements attendus permet de détecter des absences ou une collecte interrompue.
- Les volumes et les champs nécessaires au calcul permettent de repérer une couverture partielle ou des valeurs manquantes.
Une période absente peut fausser une comparaison temporelle. Un événement manquant peut sous-estimer une conversion. Une source incomplète peut rendre un rapprochement non représentatif. Dans ces cas, je documente la limite et j’évite de présenter le résultat comme exhaustif.
Ce cadrage guide la suite : interroger les événements pertinents, créer des modèles SQL réutilisables, rapprocher GA4 des autres sources, puis automatiser les rapports. Les règles doivent être stabilisées avant l’automatisation, sinon une erreur de définition se répète à chaque exécution.
Comment interroger les événements GA4 ?
J’interroge les événements GA4 et leurs paramètres directement dans BigQuery, à partir d’un résultat attendu clairement défini : par exemple, vérifier la présence d’un événement sur une période ou extraire la valeur d’un paramètre. Avant d’écrire la requête, je cadre son usage.
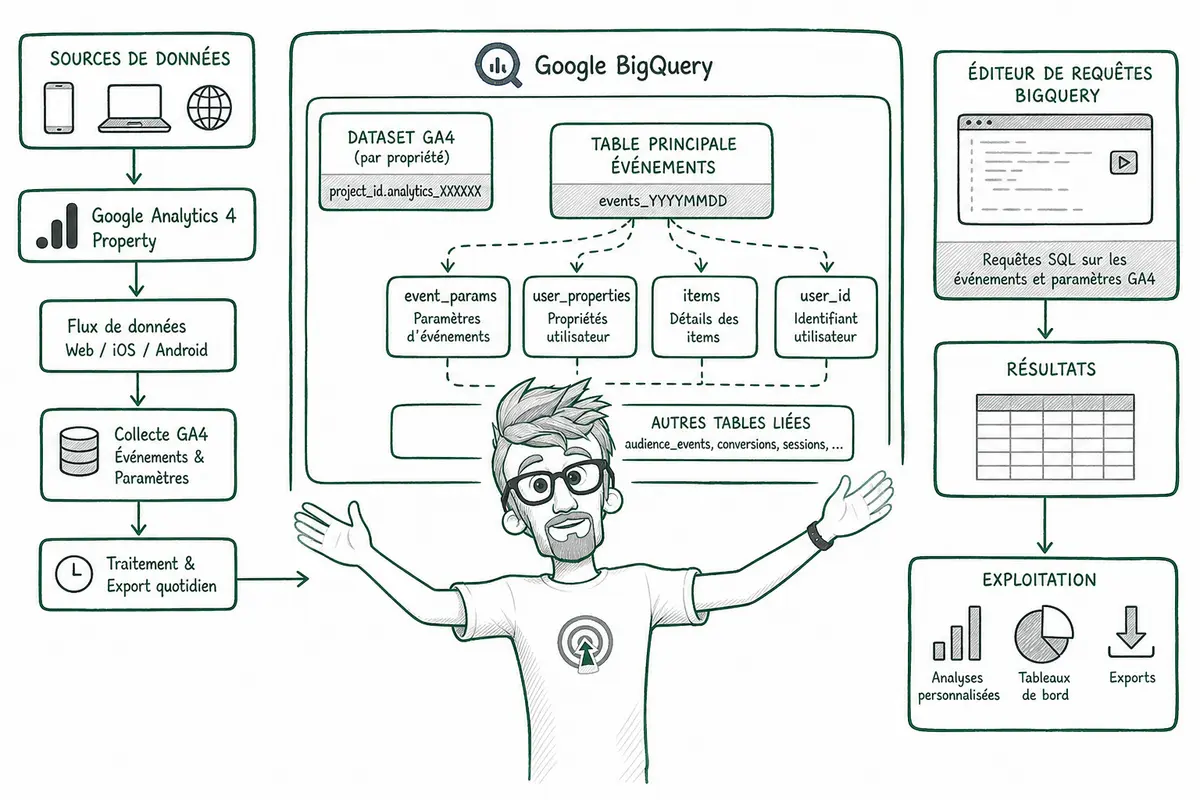
Je consigne quatre éléments : le responsable de la demande, les dépendances (tables disponibles, schéma, droits d’accès), le résultat attendu et la procédure de retour arrière. Une requête exploratoire reste en lecture seule. Si elle alimente une vue ou un modèle partagé, je conserve la version précédente et prévois son rétablissement.
Ce patron extrait un paramètre d’événement. Remplacez les identifiants entre chevrons par ceux de votre environnement et adaptez le type de valeur au paramètre recherché. Le schéma GA4 expose plusieurs champs possibles, comme string_value ou int_value.
SELECT
  event_date,
  event_name,
  (
    SELECT ep.value.string_value
    FROM UNNEST(event_params) AS ep
    WHERE ep.key = '<NOM_DU_PARAMETRE>'
    LIMIT 1
  ) AS parametre
FROM `<PROJET>.<DATASET>.<TABLE>`
WHERE event_name = '<NOM_DE_L_EVENEMENT>'
  AND event_date BETWEEN '<DATE_DEBUT_YYYYMMDD>'
                      AND '<DATE_FIN_YYYYMMDD>';
Je ne conclus rien avant d’avoir contrôlé la fraîcheur et l’exhaustivité. Je vérifie la date la plus récente disponible, la présence des tables attendues pour la période, les volumes par date et les éventuels retards de traitement. Je distingue aussi les données intrajournalières des tables quotidiennes lorsqu’elles sont présentes. Une journée incomplète peut faire apparaître une baisse artificielle.
Pour fiabiliser l’analyse, je compare les dates et les volumes à la couverture attendue, sans supposer qu’un total isolé prouve l’exhaustivité. Je documente les filtres, le fuseau horaire et la plage analysée, puis je teste la requête sur une période limitée.
Une fois validée, cette interrogation devient la base d’un modèle réutilisable : extraction standardisée des paramètres, conventions de nommage et contrôles de qualité. Le modèle doit rester explicite sur les champs réellement disponibles et les hypothèses de traitement.
Comment gouverner les indicateurs SQL ?
Je gouverne les indicateurs GA4 avec des modèles SQL réutilisables, organisés par couches et associés à des responsabilités explicites. La couche de préparation expose les événements et leurs champs ; la couche d’indicateurs applique une définition documentée, sans mélanger extraction et logique métier.
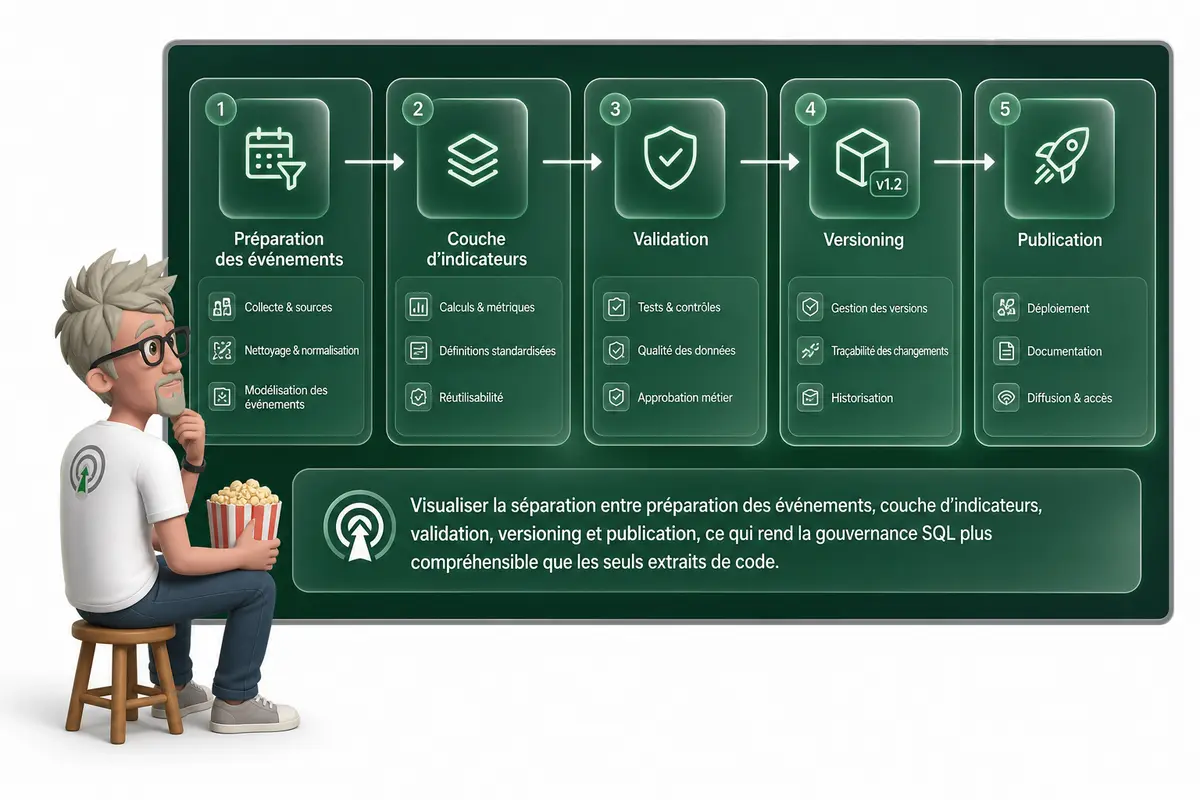
Les noms de modèles et le calcul ci-dessous sont illustratifs. Le décompte mesure des lignes d’événements GA4, pas un indicateur métier. Adaptez le projet, le jeu de données, les champs sélectionnés et le calcul à votre définition validée.
-- Modèle de préparation : expose les événements sans définir de KPI.
CREATE OR REPLACE VIEW `your_project.your_dataset.int_ga4_events` AS
SELECT
  event_date,
  event_name,
  user_pseudo_id
FROM `your_project.analytics_123456789.events_*`;

-- Modèle d'indicateur : calcule un volume de lignes par date et type d'événement.
-- Ce calcul technique ne définit pas, à lui seul, un indicateur métier.
CREATE OR REPLACE VIEW `your_project.your_dataset.mart_ga4_event_volume` AS
SELECT
  event_date,
  event_name,
  COUNT(*) AS nombre_de_lignes
FROM `your_project.your_dataset.int_ga4_events`
GROUP BY event_date, event_name;
Avant toute modification, je vérifie les dépendances en amont — export GA4, schéma des événements, transformations — puis en aval : tableaux de bord, exports et traitements planifiés. Je contrôle aussi le grain du résultat, c’est-à-dire ce que représente une ligne, ainsi que les filtres, fenêtres temporelles, règles de déduplication et fuseaux horaires définis par l’équipe. Ce sont ces choix qui fixent le sens d’un indicateur ; je ne les déduis pas du SQL.
Je versionne les requêtes et les définitions, puis je teste le changement sur un périmètre représentatif avant publication. Le retour arrière doit être opérationnel : conserver la version précédente, pouvoir la redéployer et vérifier que les consommateurs retrouvent les résultats attendus. Une modification de calcul peut changer la série historique, même si le nom de l’indicateur reste identique.
Cette gouvernance facilite le rapprochement avec le CRM, les ventes ou les données produit. Les équipes peuvent comparer des champs, des périodes et des grains explicitement définis, puis traiter les écarts de couverture ou d’identification au lieu de masquer des différences de calcul dans des requêtes isolées.
Comment rapprocher GA4 des données métier ?
Le rapprochement entre GA4 et vos données métier est fiable seulement si les clés, les périmètres et les conventions des sources sont vérifiés avant la jointure. Sans identifiant commun vérifiable, on ne peut pas attribuer des événements GA4 à des clients ou à des commandes individuelles ; une comparaison agrégée reste parfois possible, à un niveau de détail compatible.
Avant de joindre des données CRM, de revenus ou de produit, je contrôle les points suivants :
- Types et identifiants : Les clés doivent avoir le même type et la même définition. Un identifiant GA4 pseudonyme n’est pas automatiquement un identifiant client.
- Calendrier : Je vérifie le fuseau horaire, la définition de la date et le décalage possible entre événement, commande et comptabilisation.
- Revenus et devise : Je distingue chiffre d’affaires brut et net, taxes, remboursements, devise d’origine et devise de reporting.
- Consentement et valeurs manquantes : Je vérifie les effets du consentement sur la disponibilité des données et mesure les clés absentes, nulles ou dupliquées.
La requête ci-dessous illustre une jointure après agrégation par identifiant et date. Les tables et champs sont des exemples, explicitement à adapter au modèle réel. Elle n’est pertinente que si une correspondance documentée existe entre les deux clés.
-- Champs et tables à adapter au modèle réel.
SELECT
  g.event_date,
  g.user_key,
  g.ga4_revenue,
  c.net_revenue
FROM (
  SELECT
    event_date,
    CAST(user_key AS STRING) AS user_key,
    SUM(purchase_revenue) AS ga4_revenue
  FROM `projet.dataset.ga4_events`
  GROUP BY event_date, user_key
) AS g
LEFT JOIN (
  SELECT
    order_date AS event_date,
    CAST(customer_key AS STRING) AS user_key,
    SUM(net_revenue) AS net_revenue
  FROM `projet.dataset.crm_orders`
  GROUP BY event_date, user_key
) AS c
USING (event_date, user_key);
Je traite la minimisation des données comme une règle de conception : ne joindre que les champs nécessaires, limiter la granularité et éviter d’exposer des données directement identifiantes dans les tables d’analyse. Les indicateurs rapprochés doivent ensuite être définis avec leur périmètre, leur devise et leurs limites, puis publiés dans des rapports sous forme agrégée. Une différence entre GA4 et le chiffre d’affaires métier n’est pas forcément une erreur : elle peut refléter des périmètres ou des règles de comptabilisation différents.
Comment automatiser et fiabiliser les rapports ?
J’automatise la diffusion des indicateurs dans Looker Studio ou Power BI seulement après avoir validé les données, les modèles et leurs dépendances. Sinon, l’automatisation diffuse plus vite une erreur, sans la rendre plus visible.
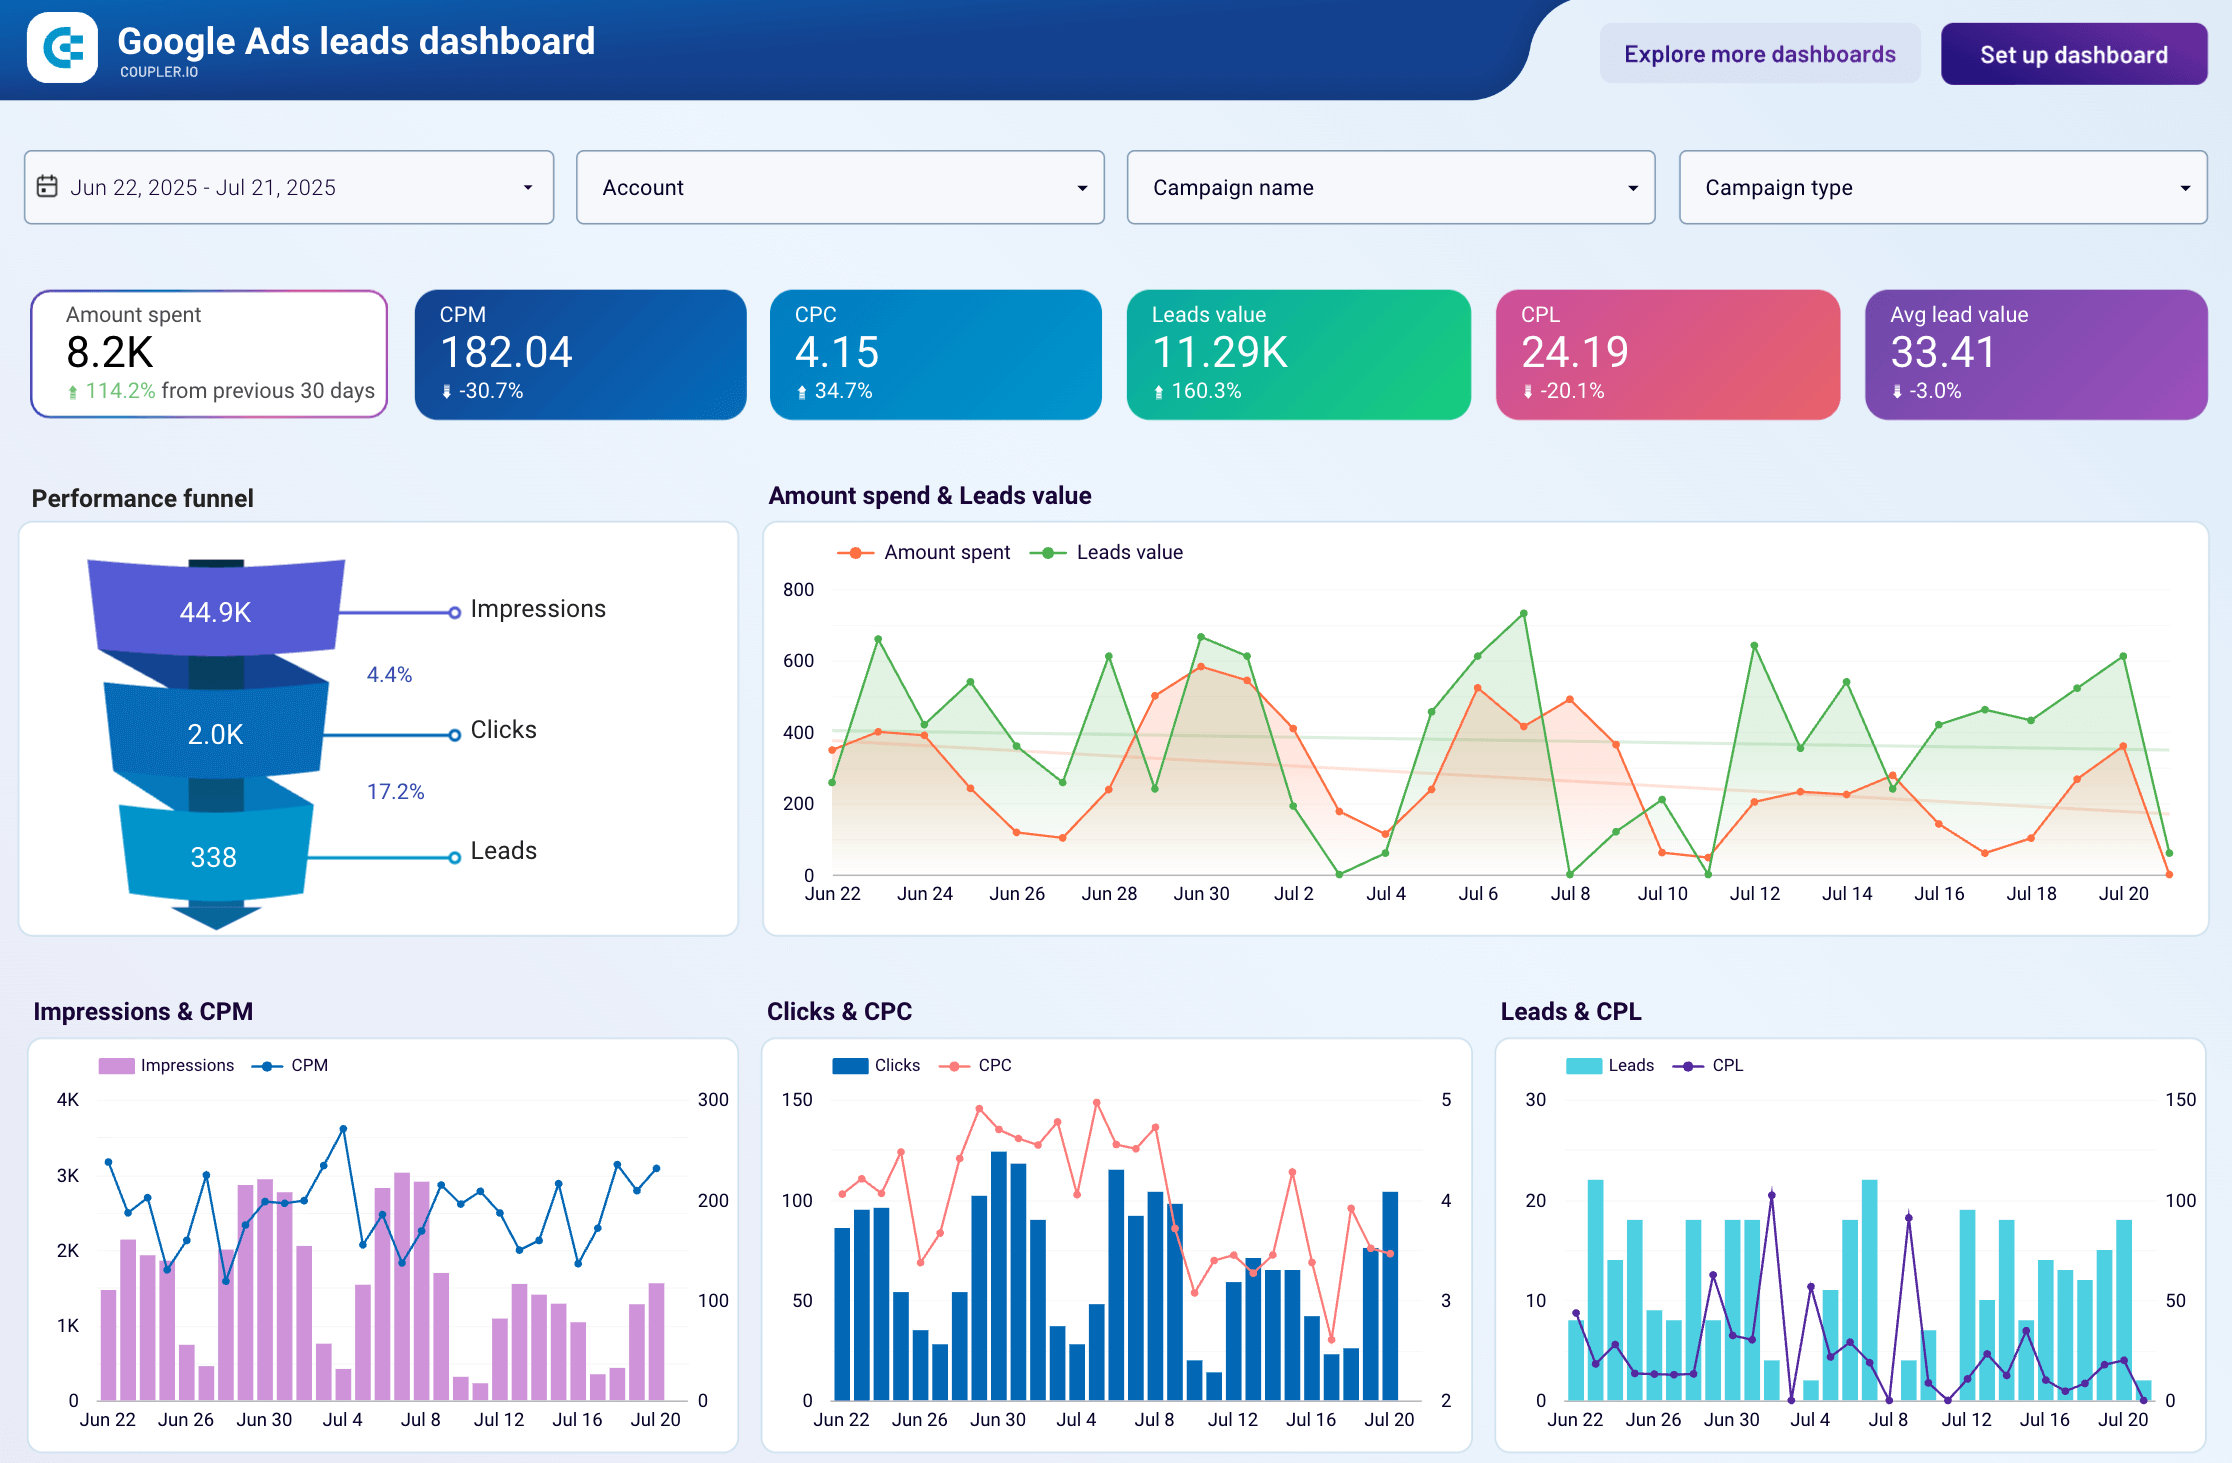
Chaque rapport doit être relié à des indicateurs gouvernés : une définition validée, une source identifiée et des règles de calcul cohérentes avec le modèle de données. Je vérifie que les filtres et le périmètre affichés ne changent pas le sens de l’indicateur. Un même KPI ne doit pas produire des résultats différents selon le rapport qui le présente.
Je teste aussi les parcours d’échec avant d’ouvrir la diffusion. Une donnée absente, partielle ou incohérente ne doit pas être présentée comme un résultat complet. Un changement de consentement peut modifier les données observées et donc les indicateurs, les comparaisons et les décisions prises à partir des rapports. Je vérifie ces effets dans les rapports concernés, puis dans les systèmes qui consomment leurs données. Un changement sans impact visible dans le tableau de bord peut quand même casser un usage en aval.
Avant d’automatiser, je contrôle les risques opérationnels suivants :
- Chaque indicateur du rapport correspond à une définition gouvernée et à un modèle validé.
- Les résultats du rapport concordent avec le modèle pour un même périmètre et les mêmes filtres.
- Les données manquantes ou partielles ne sont pas interprétées comme des résultats complets.
- Les parcours d’échec sont testés, et leurs conséquences sur les rapports sont comprises.
- Les changements de consentement sont évalués sur les données, les indicateurs et leurs comparaisons.
- Les systèmes dépendants sont identifiés et leurs usages vérifiés avant diffusion.
- La diffusion reste suspendue tant qu’une divergence ou une conséquence non maîtrisée subsiste.
La diffusion automatisée devient fiable quand chaque indicateur publié conserve son sens, y compris lors d’un échec ou d’un changement de consentement.
| Étape | Contrôles associés |
| Valider les données et les modèles | Définition, source et calcul des indicateurs cohérents. |
| Relier les rapports aux indicateurs | Périmètre et filtres conformes aux règles gouvernées. |
| Tester les échecs et le consentement | Effets sur les données, les rapports et les comparaisons vérifiés. |
| Vérifier les dépendances | Usages des systèmes en aval identifiés et contrôlés. |
| Automatiser la diffusion | Aucune divergence ni conséquence non maîtrisée. |
Quelle décision pouvez-vous mieux éclairer avec BigQuery ?
GA4 et BigQuery donnent accès aux événements bruts pour construire des analyses plus approfondies et les rapprocher des données CRM, commerciales ou produit. La fiabilité ne vient pas de la jointure seule : elle dépend du cadrage des décisions, du contrôle de la fraîcheur et de l’exhaustivité, de modèles SQL gouvernés et de vérifications précises sur les identifiants, les périmètres, le calendrier, la devise, le consentement et les valeurs manquantes. L’automatisation dans Looker Studio ou Power BI doit aussi être testée face aux échecs et aux changements de consentement. En structurant ces étapes, vous obtenez des rapports plus cohérents et des données réellement utiles pour décider.
FAQ
- Pourquoi exporter les données GA4 vers BigQuery ?
BigQuery permet d’interroger les événements et paramètres bruts de GA4, de les valider et de les rapprocher d’autres données, comme celles du CRM, des ventes ou du produit. - Que vérifier avant d’analyser les données GA4 ?
Définissez les décisions à soutenir, les métriques, les responsabilités, les sources et les règles de rapprochement. Vérifiez aussi la fraîcheur et l’exhaustivité des données. - Pourquoi créer des modèles SQL réutilisables ?
Ils permettent de produire des indicateurs gouvernés et réutilisables. Leur construction par couches facilite aussi le contrôle des dépendances en amont et en aval. - Quels contrôles effectuer avant une jointure avec le CRM ?
Vérifiez les types, les périmètres, les identifiants, le calendrier, la devise, le consentement et les valeurs manquantes. Limitez les données rapprochées au nécessaire. - Quels tests prévoir avant d’automatiser un rapport ?
Testez les parcours d’échec, les changements de consentement et leurs conséquences sur les rapports ainsi que sur les systèmes dépendants, avant de diffuser les rapports dans Looker Studio ou Power BI.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, Analytics Engineering, tracking avancé server-side, automatisation No/Low Code et intégration de l’IA. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtels, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.