

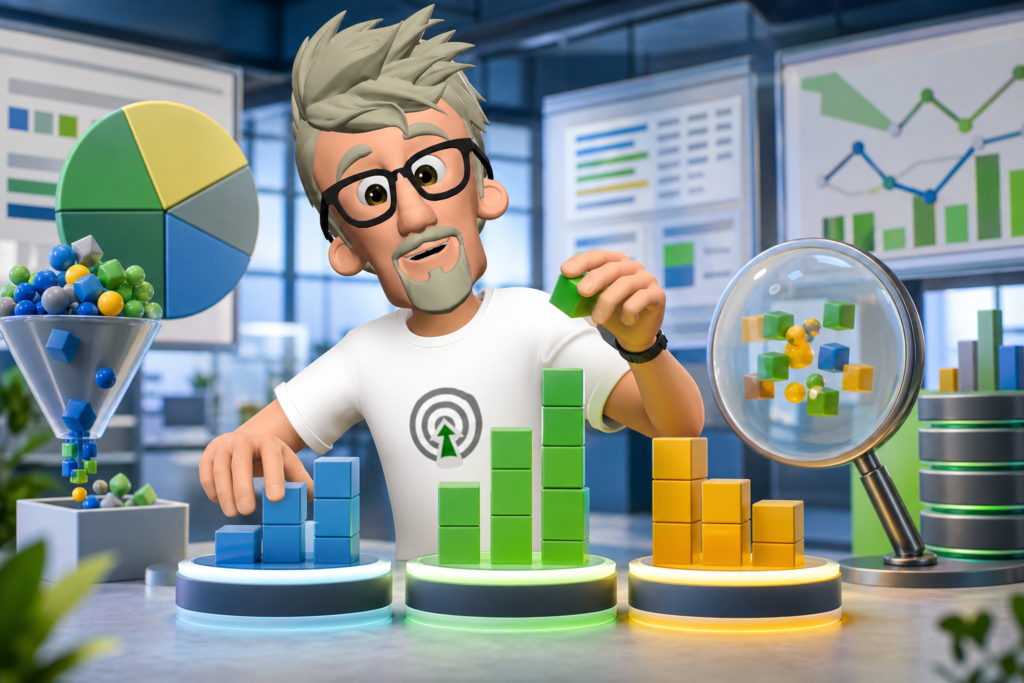
GROUP BY agrège les lignes par groupe, tandis que COUNT, SUM ou MAX calculent une valeur pour chacun. Je détaille aussi la règle des colonnes dans SELECT, la différence entre WHERE et HAVING, puis une requête complète pour compter les commandes par client.
Que calculent les fonctions d’agrégation SQL ?
Une fonction d’agrégation résume plusieurs lignes en une seule valeur. Sur une table de commandes, elle permet par exemple de compter les commandes ou de calculer des statistiques sur leur montant.
| Fonction | Calcul |
| COUNT(*) | Compte toutes les lignes, y compris celles où certaines colonnes valent NULL. |
| COUNT(montant) | Compte les lignes où montant n’est pas NULL. |
| SUM(montant) | Calcule la somme des montants non NULL. |
| AVG(montant) | Calcule la moyenne des montants non NULL. |
| MIN(montant) | Renvoie le plus petit montant non NULL. |
| MAX(montant) | Renvoie le plus grand montant non NULL. |
La différence entre COUNT(*) et COUNT(montant) est importante : le premier compte les lignes, le second compte uniquement les valeurs renseignées dans la colonne. Les fonctions SUM, AVG, MIN et MAX ignorent généralement les valeurs NULL. Elles ne les traitent pas comme des zéros.
Cette requête calcule plusieurs indicateurs sur l’ensemble de la table. Les commentaires précisent le résultat attendu pour chaque expression.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
SELECT
    COUNT(*) AS nombre_de_lignes,       -- Compte toutes les lignes
    COUNT(montant) AS montants_renseignes, -- Ignore les montants NULL
    SUM(montant) AS total_montants,     -- Additionne les montants non NULL
    AVG(montant) AS montant_moyen,      -- Calcule leur moyenne
    MIN(montant) AS montant_minimum,    -- Renvoie le plus petit montant
    MAX(montant) AS montant_maximum     -- Renvoie le plus grand montant
FROM commandes;
Sans regroupement, chaque fonction produit une valeur calculée sur toutes les lignes sélectionnées. Pour obtenir ces mêmes calculs séparément, par exemple pour chaque client ou chaque statut de commande, il faut répartir les lignes en groupes. C’est le rôle de GROUP BY.
Comment GROUP BY forme-t-il les groupes ?
GROUP BY répartit les lignes selon une ou plusieurs colonnes et calcule les agrégats séparément pour chaque groupe. Avec des commandes, chaque valeur de id_client définit un groupe. Les fonctions d’agrégation vues au chapitre précédent — comme COUNT, SUM ou AVG — s’appliquent alors aux commandes de chaque client, pas à l’ensemble de la table.
Cette requête compte les commandes et calcule leur montant total par client :
SELECT
    id_client,
    COUNT(*) AS nombre_commandes,
    SUM(montant) AS montant_total
FROM commandes
GROUP BY id_client;
Si les données contiennent trois commandes pour le client 12, elles forment un seul groupe. COUNT(*) renvoie 3 et SUM(montant) additionne les montants de ces trois lignes. Le résultat contient une ligne par valeur distincte de id_client présente dans commandes.
On peut aussi définir les groupes à partir de plusieurs colonnes. Chaque combinaison distincte devient alors un groupe :
SELECT
    id_client,
    statut,
    COUNT(*) AS nombre_commandes,
    SUM(montant) AS montant_total
FROM commandes
GROUP BY id_client, statut;
Un client peut ainsi obtenir plusieurs lignes dans le résultat, par exemple une pour ses commandes « payées » et une autre pour ses commandes « en attente ». L’agrégation est calculée séparément pour chaque combinaison id_client et statut.
Un client sans commande n’apparaît pas ici : aucune ligne de commandes ne porte son identifiant, donc aucune ligne ne forme de groupe pour lui. Pour inclure ces clients, il faut partir de la table des clients et utiliser une jointure externe, sujet distinct du regroupement.
Une contrainte importante s’applique aux colonnes de SELECT : chacune doit être incluse dans GROUP BY ou être utilisée dans une fonction d’agrégation. Sans cette règle, SQL ne saurait pas quelle valeur afficher pour une colonne qui varie à l’intérieur d’un groupe.
Quelles colonnes peut-on placer dans SELECT ?
Dans une requête avec GROUP BY, chaque colonne de SELECT doit être regroupée, calculée à partir des colonnes de regroupement, ou passée à une fonction d’agrégation comme COUNT ou SUM. Cette règle garantit une valeur unique par groupe.
Voici une agrégation par client. Le nom et l’identifiant définissent le groupe ; les commandes sont ensuite comptées et leurs montants additionnés.
SELECT
    clients.id,
    clients.nom,
    COUNT(commandes.id) AS nombre_commandes,
    SUM(commandes.montant) AS montant_total
FROM clients
LEFT JOIN commandes
    ON commandes.client_id = clients.id
GROUP BY clients.id, clients.nom;
Les colonnes clients.id et clients.nom figurent dans GROUP BY. Les deux autres valeurs sont agrégées. Une expression comme clients.id + 1 peut aussi apparaître dans SELECT, puisqu’elle dépend uniquement d’une colonne de regroupement.
À l’inverse, cette requête est incorrecte dans un SQL strict :
SELECT
    clients.nom,
    commandes.id,
    COUNT(commandes.id) AS nombre_commandes
FROM clients
JOIN commandes
    ON commandes.client_id = clients.id
GROUP BY clients.id, clients.nom;
commandes.id n’est ni regroupée ni agrégée. Un même groupe client peut contenir plusieurs identifiants de commande : le moteur n’a donc pas de valeur unique à restituer pour cette colonne. Certains moteurs acceptent des requêtes similaires dans des configurations particulières, mais la valeur renvoyée peut être indéterminée. Il faut soit ajouter la colonne au regroupement — ce qui change la granularité et crée un groupe par commande — soit choisir une agrégation adaptée.
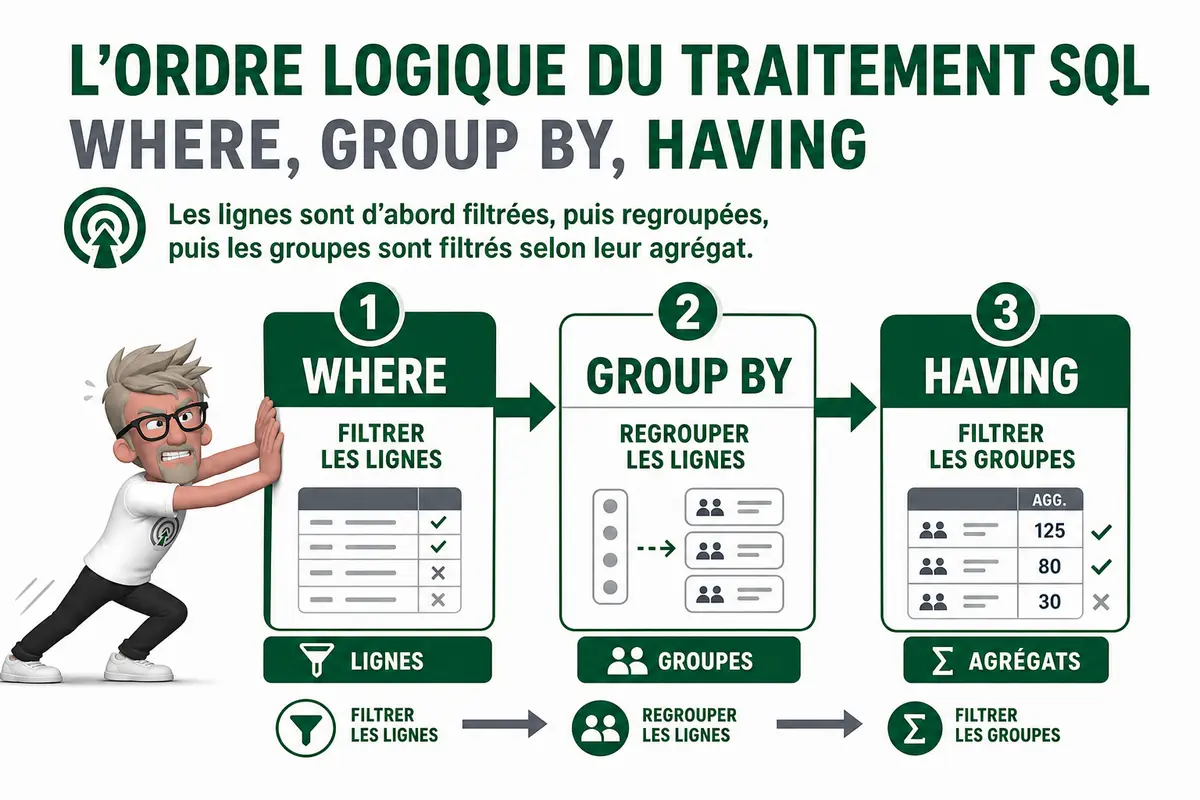
Cette distinction mène au filtrage. WHERE élimine des lignes avant leur regroupement ; HAVING filtre les groupes après l’agrégation. Pour ne garder que les clients ayant plusieurs commandes, la condition porte sur le résultat agrégé et se place dans HAVING.
Quelle différence entre WHERE et HAVING ?
WHERE filtre les lignes avant le regroupement, tandis que HAVING filtre les groupes après GROUP BY. La distinction est essentielle dès qu’une condition porte sur un résultat agrégé, comme un total ou un nombre de lignes.
Dans cet exemple, WHERE écarte les commandes annulées avant de calculer le chiffre d’affaires par client :
SELECT client_id, SUM(montant) AS chiffre_affaires
FROM commandes
WHERE statut = 'payée' -- Ne conserve que les lignes payées.
GROUP BY client_id;
HAVING s’applique, lui, au résultat de l’agrégation. Cette requête conserve uniquement les clients dont le chiffre d’affaires payé dépasse 1 000 :
SELECT client_id, SUM(montant) AS chiffre_affaires
FROM commandes
WHERE statut = 'payée' -- Filtre les lignes avant le regroupement.
GROUP BY client_id
HAVING SUM(montant) > 1000; -- Filtre les groupes après l'agrégation.
WHERE ne sert pas à filtrer sur un agrégat. Une condition comme SUM(montant) > 1000 n’a de sens qu’une fois les groupes calculés, donc elle se place dans HAVING.
L’ordre logique d’exécution aide à comprendre pourquoi :
| Étape | Rôle dans l’agrégation |
| FROM | Lit la table source des commandes. |
| WHERE | Écarte les lignes avant leur regroupement. |
| GROUP BY | Réunit les lignes ayant la même valeur, par exemple le même client. |
| HAVING | Écarte les groupes selon une condition sur leurs agrégats. |
| SELECT | Calcule et affiche les colonnes et agrégats demandés. |
| ORDER BY | Trie les résultats agrégés. |
| LIMIT | Réduit le nombre de résultats renvoyés. |
Cette séquence n’impose pas l’ordre d’écriture de la requête, mais décrit la logique de traitement. Pour aller plus loin, on peut combiner le regroupement par client avec un comptage des commandes, le montant maximum et un tri sur le chiffre d’affaires : WHERE sélectionne les lignes, GROUP BY forme les groupes, puis HAVING peut en limiter le résultat.
Comment compter les commandes par client ?
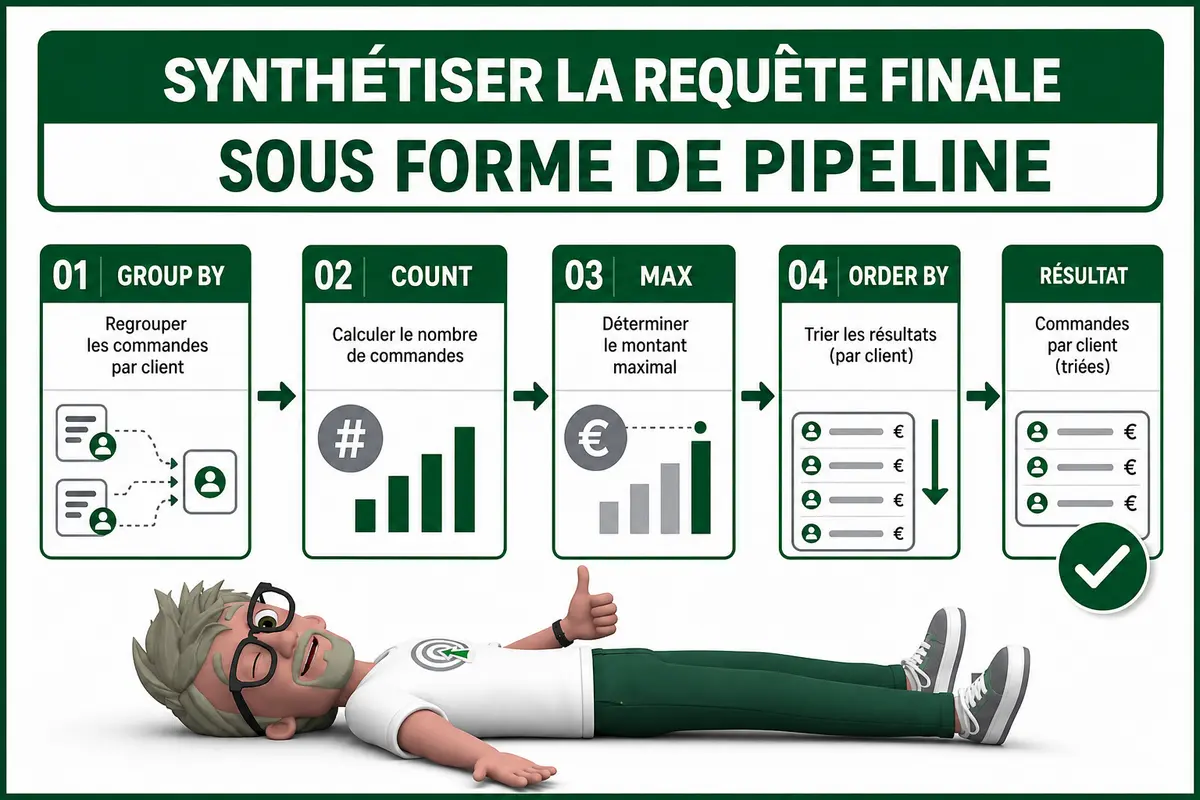
Pour compter les commandes par client et récupérer le montant de commande le plus élevé, je pars d’une table orders contenant une ligne par commande, avec les colonnes order_id, customer_id et amount. J’assume que order_id est unique et non nul.
SELECT
    customer_id,
    COUNT(order_id) AS order_count,
    MAX(amount) AS max_order_amount
FROM orders
GROUP BY customer_id
ORDER BY customer_id;
COUNT(order_id) compte les identifiants de commande non nuls dans chaque groupe. Ici, il donne le nombre de commandes par client. Comme order_id est supposé non nul, le résultat correspond au nombre de lignes de commande du groupe.
MAX(amount) renvoie le montant le plus élevé parmi les commandes de chaque client. Il ne calcule pas le total des commandes : pour obtenir celui-ci, il faudrait utiliser SUM(amount).
GROUP BY customer_id rassemble les lignes ayant le même identifiant client. Chaque groupe produit une ligne dans le résultat. La règle de regroupement est respectée : customer_id, la seule colonne de SELECT qui n’est pas agrégée, figure dans GROUP BY. Les deux autres colonnes sont calculées avec des fonctions d’agrégation.
ORDER BY customer_id trie les lignes finales par identifiant client, par ordre croissant par défaut. Les clients sans commande ne figurent pas dans ce résultat, car la requête lit uniquement la table orders. Pour les inclure, il faudrait partir de la table des clients et utiliser une jointure externe.
Avant de valider une agrégation, je vérifie les points suivants :
- Le niveau de détail de la table : une ligne correspond-elle bien à une commande ?
- La colonne comptée est-elle toujours renseignée ?
- Les colonnes non agrégées de SELECT sont-elles toutes dans GROUP BY ?
- Le tri porte-t-il sur les bonnes colonnes et les clients sans commande doivent-ils apparaître ?
Vous pouvez maintenant agréger vos données sans ambiguïté ?
Les fonctions COUNT, SUM, AVG, MIN et MAX résument plusieurs lignes en valeurs exploitables. GROUP BY calcule ces valeurs séparément pour chaque groupe, à condition que les colonnes de SELECT soient regroupées ou agrégées. La distinction entre WHERE et HAVING évite de filtrer au mauvais moment : WHERE agit sur les lignes, HAVING sur les groupes. En combinant ces règles, vous pouvez produire une ligne par client avec le nombre de commandes et le montant maximal, puis trier le résultat. Vous disposez ainsi d’une méthode fiable pour écrire et vérifier vos requêtes d’agrégation SQL, sans résultats ambigus.
FAQ
-
Quelle différence entre COUNT(*) et COUNT(colonne) ?
COUNT(*) compte toutes les lignes. COUNT(colonne) compte les valeurs non NULL de cette colonne et ignore les valeurs NULL. -
GROUP BY peut-il utiliser plusieurs colonnes ?
Oui. GROUP BY peut regrouper les lignes selon plusieurs colonnes. Les fonctions d’agrégation sont alors calculées séparément pour chaque combinaison de valeurs. -
Pourquoi une colonne doit-elle être regroupée ou agrégée ?
Une colonne non regroupée peut contenir plusieurs valeurs dans un même groupe. SQL ne peut donc pas déterminer quelle valeur unique afficher dans le résultat. -
Quand utiliser HAVING plutôt que WHERE ?
WHERE filtre les lignes avant GROUP BY. HAVING filtre les groupes après leur formation. Pour filtrer sur une valeur agrégée, utilisez HAVING. -
Pourquoi les clients sans commande n’apparaissent-ils pas ?
Aucune ligne de commande ne forme de groupe pour eux. Ils ne figurent donc pas dans le résultat d’une agrégation effectuée sur les commandes.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes sur la structuration et l’exploitation des données, avec une approche technique orientée résultats.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.