

BigQuery Measures réunit mesures métier gouvernées et relations d’un graphe de connaissances dans un même modèle. Les tableaux de bord, les requêtes SQL et les agents d’IA peuvent ainsi exploiter des indicateurs cohérents tout en accédant au contexte qui aide à les expliquer.
Que change la disponibilité générale de BigQuery Measures ?
La disponibilité générale de BigQuery Measures rend accessible un modèle unifié qui associe des mesures métier gouvernées à des relations issues d’un graphe de connaissances. Une même définition d’indicateur peut ainsi servir de référence aux tableaux de bord, aux requêtes SQL et aux agents d’IA, plutôt que d’être reconstruite séparément dans chaque outil.
Dans beaucoup d’organisations, un même terme recouvre plusieurs calculs. Le chiffre d’affaires, par exemple, peut varier selon la source, les filtres ou la période retenue. Ces écarts ne viennent pas toujours d’une erreur : ils reflètent souvent des règles métier dispersées, implicites ou différentes d’une équipe à l’autre. Les systèmes en silos amplifient le problème. Pour rapprocher les données, on ajoute des transformations et des pipelines spécifiques, qui deviennent difficiles à maintenir dès qu’une définition ou une source évolue.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
Je vois l’intérêt de l’approche dans la réduction de ces duplications. Les mesures gouvernées fournissent un cadre commun pour nommer et calculer les indicateurs. Les relations de graphe apportent le contexte qui relie ces mesures aux entités et aux concepts métier. Le même modèle peut alors être mobilisé par les outils de reporting, les utilisateurs SQL et les agents d’IA, sans supposer que chacun réimplémente les règles de calcul. Ça ne signifie pas que toute divergence disparaît automatiquement : la qualité dépend toujours des définitions et des relations établies dans le modèle.
Pour l’IA, cette distinction compte. Calculer une mesure répond à « combien ? ». Comprendre son contexte relationnel aide à interpréter « à quoi ce chiffre se rapporte-t-il ? », et quelles entités ou notions métier lui sont liées. La disponibilité générale rend cette combinaison accessible ; l’enjeu suivant est donc de distinguer le calcul fiable d’un indicateur de la compréhension de son environnement relationnel.
Comment réunir le quoi et le pourquoi dans un modèle ?
Pour réunir le quoi et le pourquoi, j’associe les mesures aux relations entre les entités dans un même modèle sémantique. L’IA peut alors relier un indicateur à son contexte métier, au lieu de produire un chiffre isolé.
Une banque observe une hausse des transactions dans le quartier de Prague. Le volume des transactions décrit l’ampleur du phénomène : il peut correspondre au nombre d’opérations ou à leur montant total, selon la définition retenue. Le nombre de comptes concernés répond à une autre question : la hausse est-elle répartie entre de nombreux comptes ou concentrée sur quelques-uns ? Les deux mesures apportent des lectures complémentaires.
Les données déjà disponibles peuvent alimenter le modèle : les enregistrements de transactions, les comptes et les relations qui les relient à une zone géographique. Il n’est pas nécessaire de reconstruire les sources. Le modèle sémantique expose ces entités et leurs liens, puis associe chaque mesure à la bonne entité et au bon niveau de détail.
GRAPH_EXPAND sert à parcourir les relations du graphe pour retrouver les entités liées à un contexte donné, comme les transactions associées à des comptes dans le quartier observé. AGG() permet d’agréger les mesures dans ce contexte. GQL, le langage de requête pour les graphes, permet d’explorer les relations entre les entités et de vérifier le chemin qui relie une transaction à un compte ou à une zone.
Le point critique, c’est le grain natif, c’est-à-dire le niveau auquel chaque enregistrement est unique. Un compte peut être associé à plusieurs transactions. Si le modèle répète le compte à chaque ligne de transaction, un comptage direct le compterait plusieurs fois. La mesure du nombre de comptes doit donc préserver l’unicité des comptes, tandis que le volume des transactions s’agrège au niveau des opérations. C’est cette séparation qui évite des réponses plausibles, mais fausses.
Comment composer des mesures avec MEASURE() et AGG() ?
Les agrégats de base se définissent une seule fois, puis AGG() permet de les combiner pour construire des mesures plus élaborées. MEASURE() prend en charge ces expressions composites et les mesures dérivées, en séparant la définition métier de la requête qui les consomme.
On peut, par exemple, définir un agrégat pour le chiffre d’affaires et un autre pour le nombre de commandes. Une mesure dérivée peut ensuite exprimer le panier moyen à partir de ces deux éléments. Cet exemple est conceptuel : il décrit les dépendances entre mesures, pas une syntaxe exécutable ni une formule BigQuery complète.
| Élément | Rôle conceptuel |
| Agrégat de chiffre d’affaires | Fournit une valeur agrégée réutilisable |
| Agrégat de commandes | Fournit le dénominateur nécessaire |
| Mesure de panier moyen | Combine les agrégats pour produire une mesure dérivée |
Ce modèle crée des dépendances entre les définitions. Lors de la compilation du schéma, BigQuery peut contrôler ces références et détecter celles qui sont invalides, ainsi que les références circulaires. Une référence circulaire apparaît lorsqu’une mesure dépend directement ou indirectement d’elle-même. Le contrôle intervient avant l’exécution des requêtes : une définition incohérente est donc repérée dans le modèle, plutôt que de produire des résultats ambigus dans un tableau de bord.
Cette distinction entre agrégats réutilisables et mesures dérivées limite aussi la duplication des règles métier. Si la définition d’un agrégat change, les mesures qui en dépendent restent liées au même élément du modèle, au lieu de conserver chacune une copie de la logique.
Le bénéfice est concret : la modélisation devient plus cohérente, les requêtes peuvent réutiliser des mesures définies dans le schéma et les outils BI affichent des indicateurs fondés sur une logique partagée. C’est un point important quand plusieurs équipes interrogent les mêmes données avec des définitions métier qui doivent rester alignées.
Pourquoi ce modèle aide-t-il les agents d’IA ?
Un agent d’IA peut accéder à des indicateurs gouvernés et aux relations entre les entités, qui donnent le contexte nécessaire pour interpréter ces indicateurs. Il ne s’agit pas seulement d’obtenir un chiffre, mais de pouvoir le rattacher aux dimensions et aux objets du modèle auxquels il correspond.
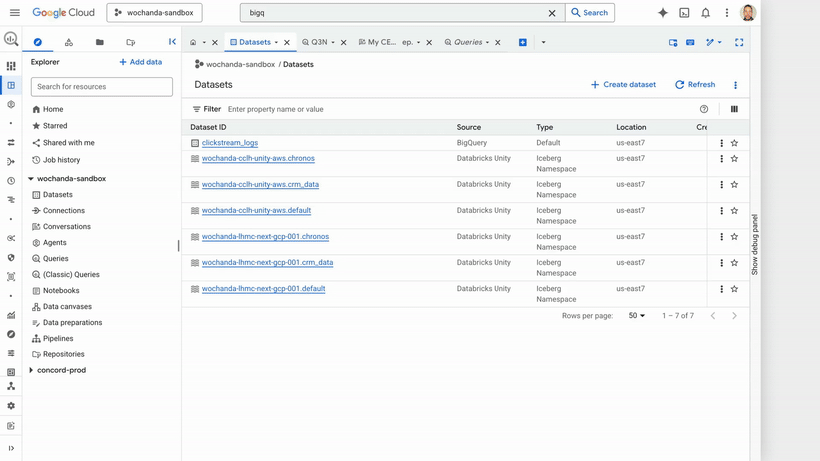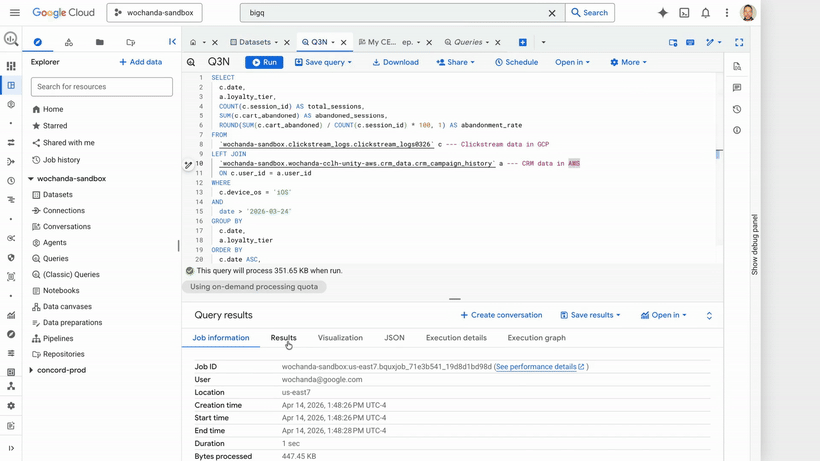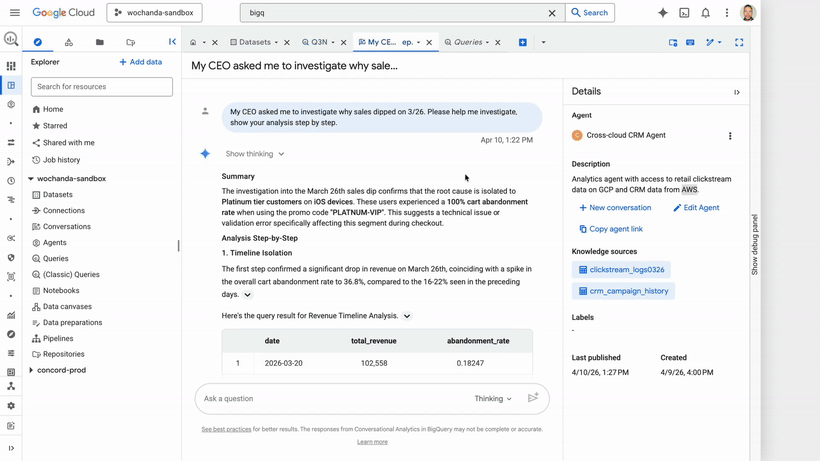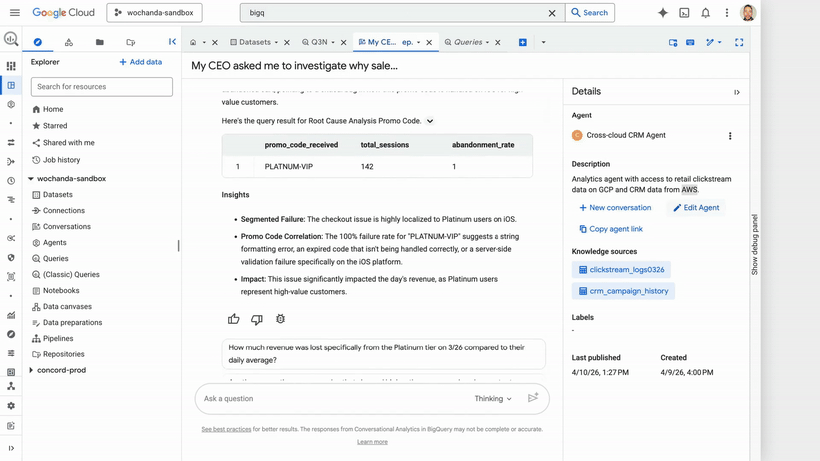
Quand les agents s’appuient sur le même modèle que la BI et les requêtes SQL, les définitions des mesures restent cohérentes d’un usage à l’autre. Le chiffre d’affaires, par exemple, n’a pas besoin d’être redéfini dans un système dédié aux agents. Les relations entre les données ne sont pas non plus à maintenir séparément. C’est un point important : dès que les définitions divergent, les réponses peuvent diverger aussi.
Je distingue deux opérations. Le calcul produit le résultat d’une mesure selon sa définition gouvernée. L’exploration de son contexte consiste à examiner les relations disponibles pour situer ce résultat : à quelle entité il se rapporte, ou selon quelle dimension il peut être analysé. Le modèle fournit ce cadre ; il ne garantit pas, à lui seul, que l’agent comprenne une question ambiguë ni qu’il choisisse toujours le bon parcours.
Cette unification réduit le nombre de modèles à synchroniser et limite les écarts entre les réponses de l’IA, les rapports BI et les requêtes SQL. Elle ne remplace pas la gouvernance : elle la rend réutilisable par ces différents usages.
La fiabilité dépend donc de trois conditions :
- Les mesures ont des définitions cohérentes et gouvernées.
- Les usages partagent un modèle commun, avec des relations correctement définies.
- Le grain des entités est respecté. Le grain désigne le niveau de détail d’une ligne, par exemple une commande ou une ligne de commande. Le mélanger peut fausser les agrégations et le contexte associé au résultat.
Que retenir de BigQuery Measures ?
BigQuery Measures associe les mesures métier gouvernées aux relations d’un graphe de connaissances dans un même modèle. Cette approche permet de réutiliser des indicateurs cohérents dans les tableaux de bord, les requêtes SQL et les usages d’IA, tout en donnant accès au contexte relationnel nécessaire pour interpréter les résultats. Les fonctions décrites couvrent le calcul avec GRAPH_EXPAND et AGG(), l’exploration avec GQL, ainsi que la composition de mesures avec MEASURE(). La préservation du grain des entités évite notamment de compter plusieurs fois un compte lié à plusieurs transactions. Pour vous, le bénéfice est concret : des métriques plus cohérentes et des résultats plus faciles à contextualiser.
FAQ
-
Qu’est-ce que BigQuery Measures ?
C’est un modèle qui réunit des mesures métier gouvernées et des relations de graphe de connaissances afin de servir les tableaux de bord, les requêtes SQL et les agents d’IA. -
À quoi sert l’association des mesures et des relations ?
Les mesures donnent les indicateurs calculés. Les relations apportent le contexte nécessaire pour explorer et expliquer les liens entre les entités concernées. -
Comment BigQuery Measures évite-t-il les comptes en double ?
Les mesures préservent le grain natif des entités. Ainsi, un compte associé à plusieurs transactions n’est pas compté plusieurs fois dans le calcul présenté. -
Quel est le rôle de MEASURE() et AGG() ?
MEASURE() prend en charge les expressions composites et les mesures dérivées. AGG() permet de combiner des agrégats de base définis une fois pour produire des calculs plus élaborés. -
Comment explorer les relations du graphe ?
GQL sert à explorer les relations entre les entités. GRAPH_EXPAND et AGG() interviennent dans l’exemple décrit pour calculer les mesures à partir du modèle.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. Je m’intéresse particulièrement aux modèles de données gouvernés qui rendent les indicateurs réutilisables et exploitables par les applications métier et les agents d’IA.

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
Data Engineering : BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
Automatisation IA : n8n, Apps Script, scraping, API, LLM
Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals