

Pour réduire les coûts BigQuery de GA4, limitez les données scannées avant de déplier les événements, puis réutilisez des transformations contrôlées. Le vrai enjeu est de diminuer les traitements inutiles sans fragiliser les métriques, la fraîcheur ni l’exhaustivité des analyses.
Que faut-il mesurer avant d’optimiser ?
Avant de connecter un tableau de bord, je clarifie les décisions que l’analyse doit rendre possibles : quelle dépense BigQuery liée à GA4 veut-on expliquer, quelle action peut-on engager et comment saura-t-on si elle a fonctionné ? Sans décision attendue, on risque surtout de produire des indicateurs difficiles à interpréter.
Je sépare trois niveaux de mesure, qui n’ont pas le même rôle :
- Les indicateurs de résultat décrivent l’effet recherché, par exemple l’évolution des coûts ou de la consommation associée aux analyses GA4.
- Les leviers opérationnels correspondent aux actions que l’équipe peut modifier, comme le périmètre des données interrogées ou les usages concernés.
- Les données de diagnostic aident à comprendre les écarts : période, source, type d’analyse ou population concernée.
Je cadre ensuite l’audience et la décision : qui doit agir, et que doit-il pouvoir décider à la lecture des résultats ? Je précise le périmètre du test, la fréquence de revue, les définitions des métriques et les contraintes des sources. Une même notion — « coût », par exemple — doit garder la même définition dans les données, les échanges et les rapports. Je fixe aussi la période de rapprochement entre les données GA4 et celles utilisées pour suivre la dépense, afin de comparer des périodes cohérentes.
Maîtrisez SQL pour exploiter pleinement vos données BigQuery !
Découvrez nos formations BigQuery adaptées à tous les niveaux, du débutant à l’expert. Apprenez à interroger, analyser et optimiser vos données avec SQL dans BigQuery, et exploitez toute la puissance du cloud pour des analyses avancées. Du niveau 1, où vous explorerez et visualiserez vos données avec BigQuery et Looker Studio, au niveau 2, qui vous permettra de maîtriser les requêtes SQL pour trier, filtrer et structurer efficacement vos données, jusqu’au niveau 3, dédié aux techniques avancées d’optimisation et d’automatisation.
Je constitue un état de référence daté avant toute optimisation. J’y consigne le périmètre observé, les définitions retenues et la période couverte. Cette référence permet de distinguer un effet réel d’un changement de périmètre ou de méthode.
Je choisis ensuite l’outil selon la question, pas selon l’envie de centraliser :
- Rapports GA4 pour consulter les indicateurs déjà disponibles dans l’interface.
- Explorations pour analyser une question plus ciblée dans GA4.
- Data API pour récupérer des données GA4 de façon automatisée.
- BigQuery pour interroger les données exportées et examiner les usages concernés.
- Looker Studio pour partager un suivi visuel adapté aux décisions de l’équipe.
Une fois cette base définie, je peux examiner les requêtes BigQuery et prioriser les optimisations sur des éléments mesurables.
Comment réduire les données scannées ?
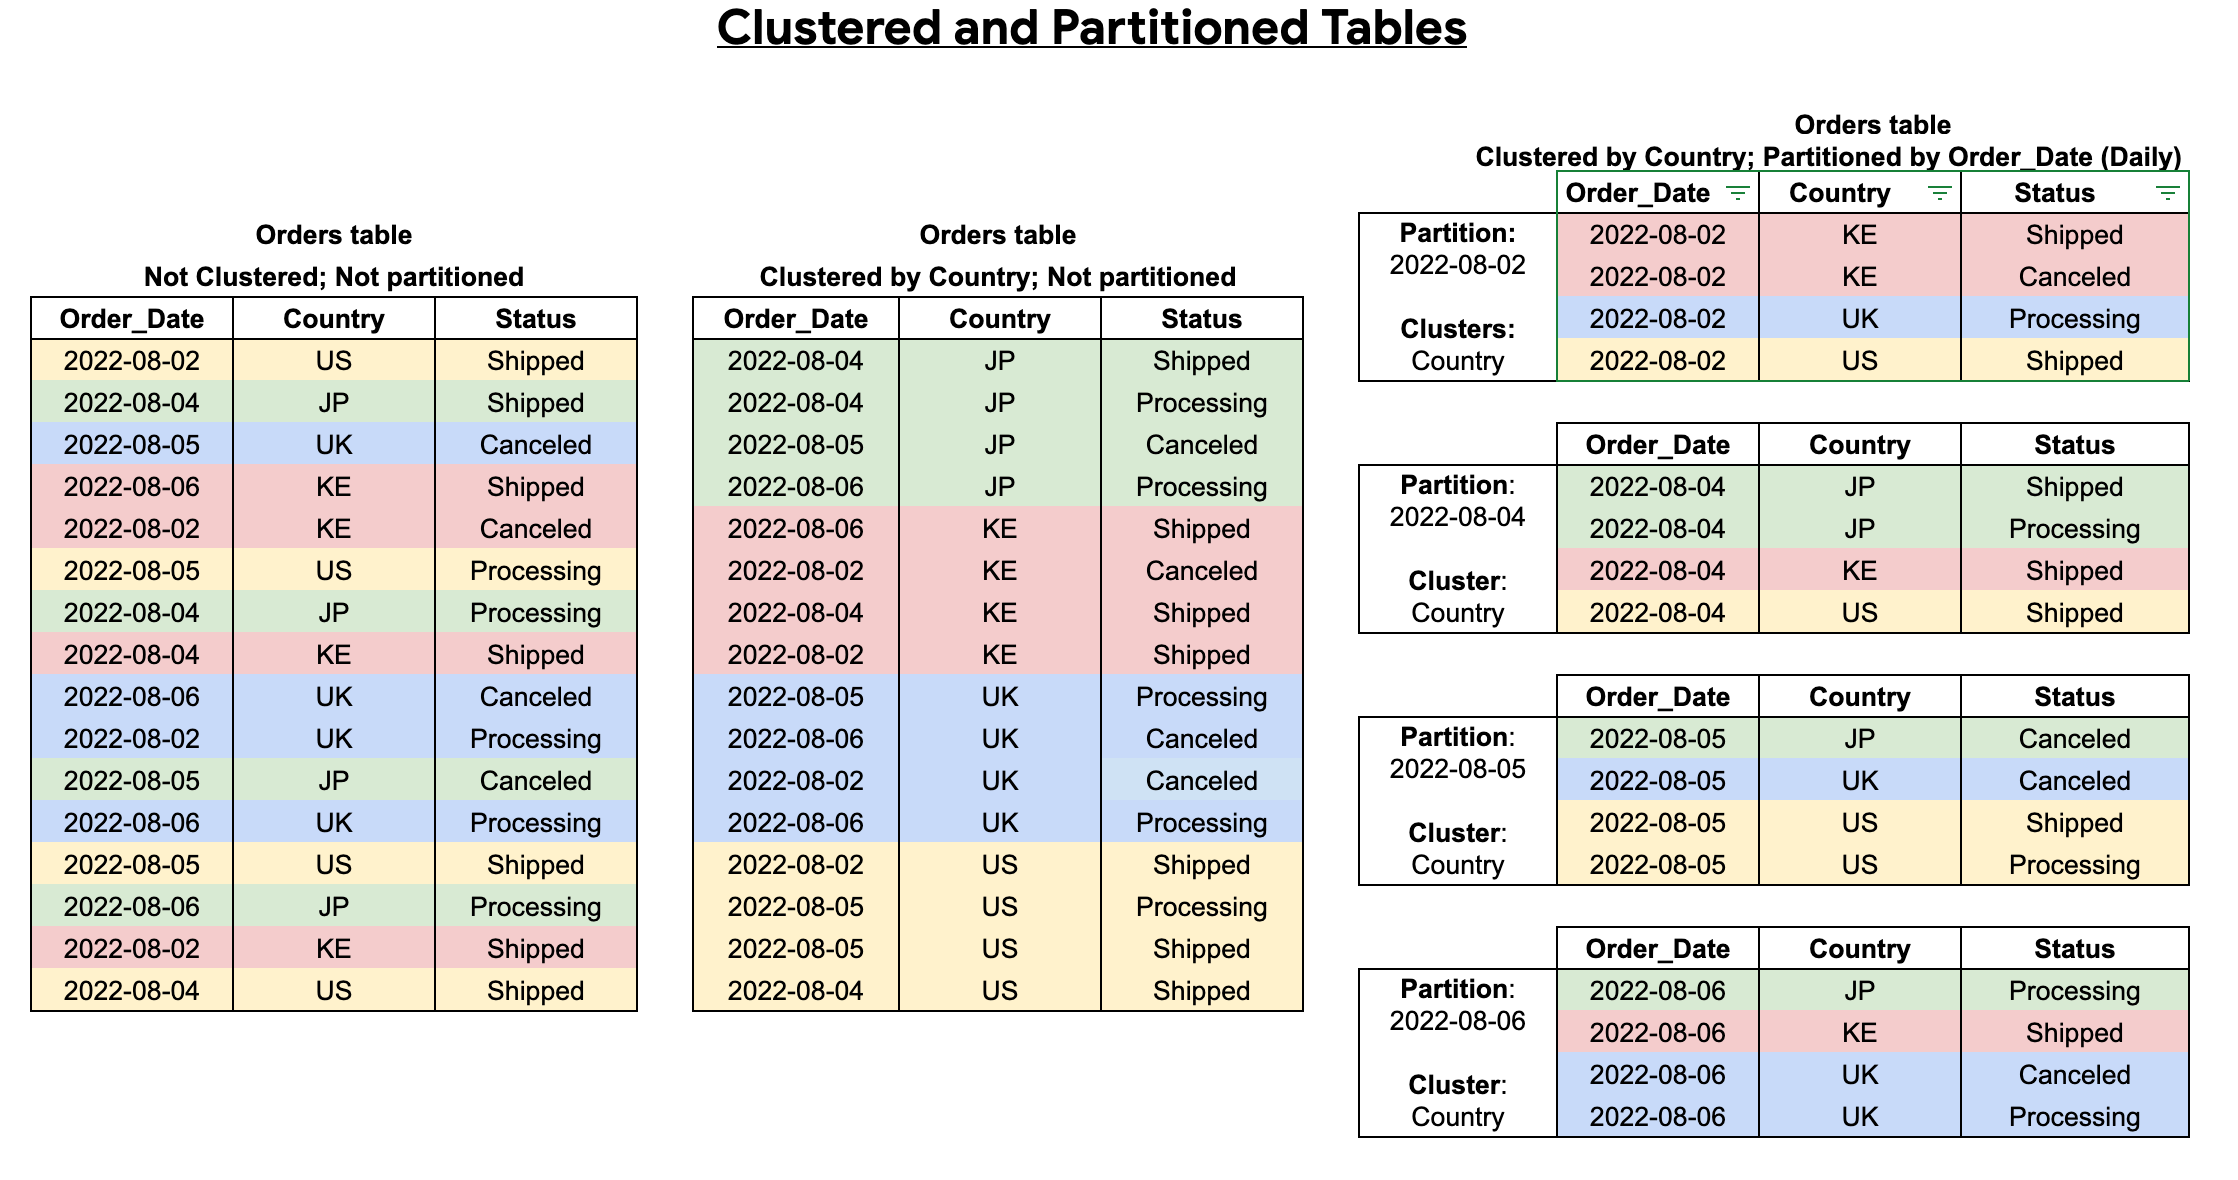
Je réduis les données scannées en filtrant les tables ou partitions avant de déplier les champs répétés, puis en sélectionnant uniquement les colonnes nécessaires. Le filtre sur _TABLE_SUFFIX limite les tables GA4 lues ; le filtre avant UNNEST évite de déplier les événements hors période. La sélection explicite des colonnes réduit les données lues dans ces colonnes. L’effet exact dépend du schéma et du plan d’exécution : je le vérifie avant de déployer.
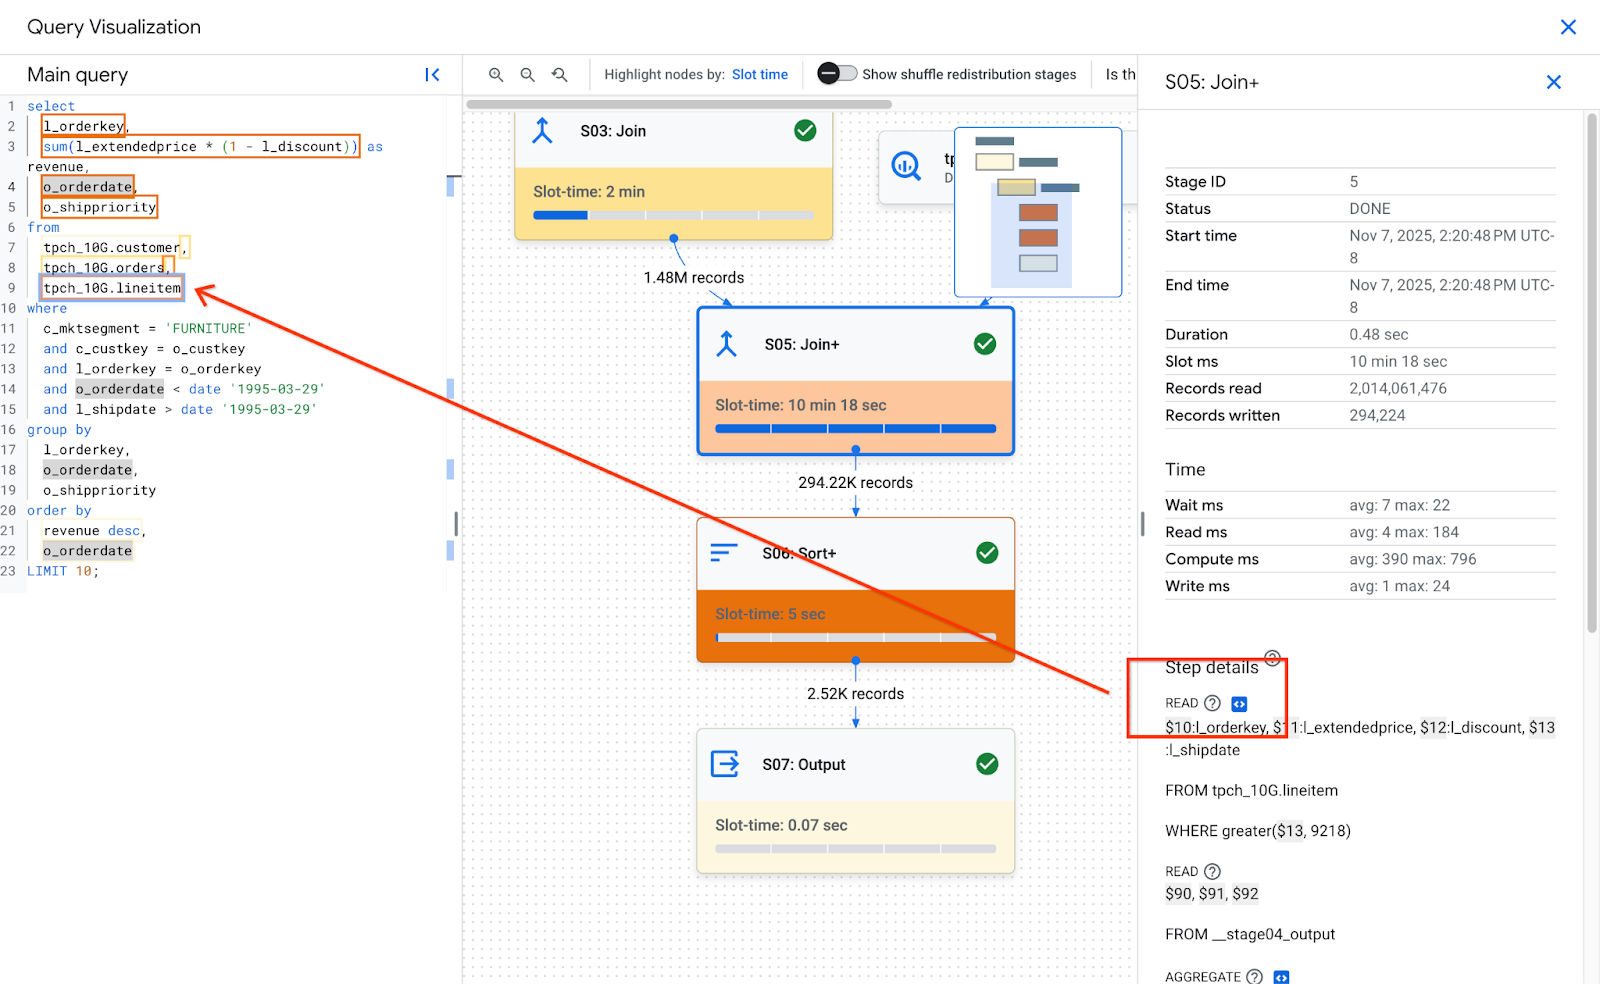
Dans cet exemple, les dates sont des paramètres au format YYYYMMDD, à adapter à la période analysée. Le nom du projet, du dataset et la structure de event_params sont aussi à adapter au schéma réel. Je n’utilise UNNEST que si la clé de paramètre est requise par le traitement aval.
-- Filtre d'abord les tables par suffixe, puis déplie les paramètres utiles.
WITH filtered AS (
  SELECT event_date, event_name, event_params
  FROM `project.dataset.events_*`
  WHERE _TABLE_SUFFIX BETWEEN @date_debut AND @date_fin
)
SELECT
  event_date,
  event_name,
  param.key,
  param.value.string_value AS param_value
FROM filtered
CROSS JOIN UNNEST(event_params) AS param
WHERE param.key = @cle_parametre;
La date de début et la date de fin viennent de la période métier à comparer et doivent correspondre au format des suffixes. La clé vient du besoin du modèle ou du rapport. Cet exemple conserve event_params uniquement parce qu’il faut le déplier ; sans ce besoin, je l’exclus.
Pour une extraction sans paramètres répétés, je liste les champs consommés en aval au lieu d’utiliser SELECT *. Les champs ci-dessous sont des exemples à valider selon le schéma GA4 et les dépendances du modèle.
-- Ne lit que les champs attendus par le traitement aval.
SELECT
  event_date,       -- Date de l'événement, utilisée pour le regroupement temporel.
  event_name,       -- Nom de l'événement, utilisé pour la segmentation.
  user_pseudo_id    -- Identifiant pseudonyme, requis uniquement si l'analyse l'utilise.
FROM `project.dataset.events_*`
WHERE _TABLE_SUFFIX BETWEEN @date_debut AND @date_fin;
En environnement sûr, je lance d’abord une estimation des octets avec une requête à blanc, puis j’inspecte le plan et le schéma. Je teste aussi les bornes de dates et les résultats sur un dataset de validation. En amont, les dates viennent de la période de référence et les champs du contrat de données GA4 ; en aval, je vérifie les modèles, tableaux de bord et traitements qui consomment la sortie.
Je compare ensuite la requête à une référence datée, sur la même période, avec les mêmes fuseau horaire, filtres et règles de déduplication. Je contrôle le schéma produit, le nombre d’événements et les agrégats métier. Je ne valide pas un changement sur le seul volume scanné. Une fois les transformations stabilisées, je peux les réutiliser dans des tables intermédiaires ou des modèles partagés.
Comment fiabiliser les tables réutilisables ?
Je réduis les coûts et les écarts d’analyse en construisant des tables de préparation et d’agrégation réutilisables. Chaque valeur doit rester traçable de son champ source à son champ de destination, avec une définition partagée par les équipes.
Avant de publier une table, je contrôle les points qui produisent le plus souvent des écarts :
- Noms et types. Les champs ont des noms stables et des types compatibles avec leur usage.
- Périmètres et délais. Les définitions précisent la période couverte, le fuseau ou la convention de date utilisée, et le délai attendu avant disponibilité des données.
- Identifiants et devises. Les règles de normalisation sont explicites. Une devise ou un identifiant manquant n’est pas remplacé par une valeur supposée.
- Consentement et valeurs vides. Les champs de consentement nécessaires sont conservés selon les exigences du projet. Les valeurs nulles, vides ou non renseignées sont distinguées.
Si une donnée est absente ou incorrecte, je corrige sa collecte à la source. La reconstruire à partir d’un libellé affiché, d’un montant formaté ou d’un autre élément de présentation crée une approximation fragile, parfois impossible à auditer. La minimisation des données se décide aussi dès la conception : je ne sélectionne que les champs utiles et je définis leur usage au regard des exigences de consentement applicables.
Voici un modèle à adapter aux champs réellement disponibles dans votre export GA4. Il sélectionne explicitement les colonnes, normalise les dates et les horodatages, et conserve le statut de consentement sans imposer de règle de filtrage.
CREATE OR REPLACE TABLE `projet.dataset.ga4_prepared`
PARTITION BY event_date AS
SELECT
  -- Date d'événement convertie en type DATE.
  PARSE_DATE('%Y%m%d', event_date) AS event_date,
  -- Horodatage converti depuis les microsecondes.
  TIMESTAMP_MICROS(event_timestamp) AS event_timestamp,
  event_name,
  NULLIF(user_pseudo_id, '') AS user_pseudo_id,
  NULLIF(user_id, '') AS user_id,
  privacy_info.analytics_storage AS analytics_storage,
  ecommerce.currency AS currency,
  ecommerce.purchase_revenue AS purchase_revenue
FROM `projet.analytics_123456789.events_*`
WHERE _TABLE_SUFFIX BETWEEN @date_debut AND @date_fin;
Documentez le mapping source-destination et validez les types, les champs disponibles et les règles de consentement avant mise en production. Une table fiable permet ensuite de planifier les traitements selon la fraîcheur requise : inutile de recalculer fréquemment une agrégation dont les données sources ne sont pas encore stabilisées.
Comment planifier et contrôler les transformations ?
Je planifie chaque transformation à une cadence adaptée au résultat attendu, puis je rends chaque changement testable, attribué à un responsable et réversible. Pour réduire les coûts BigQuery de GA4, une actualisation plus fréquente n’a de valeur que si les données doivent réellement être consommées plus tôt.
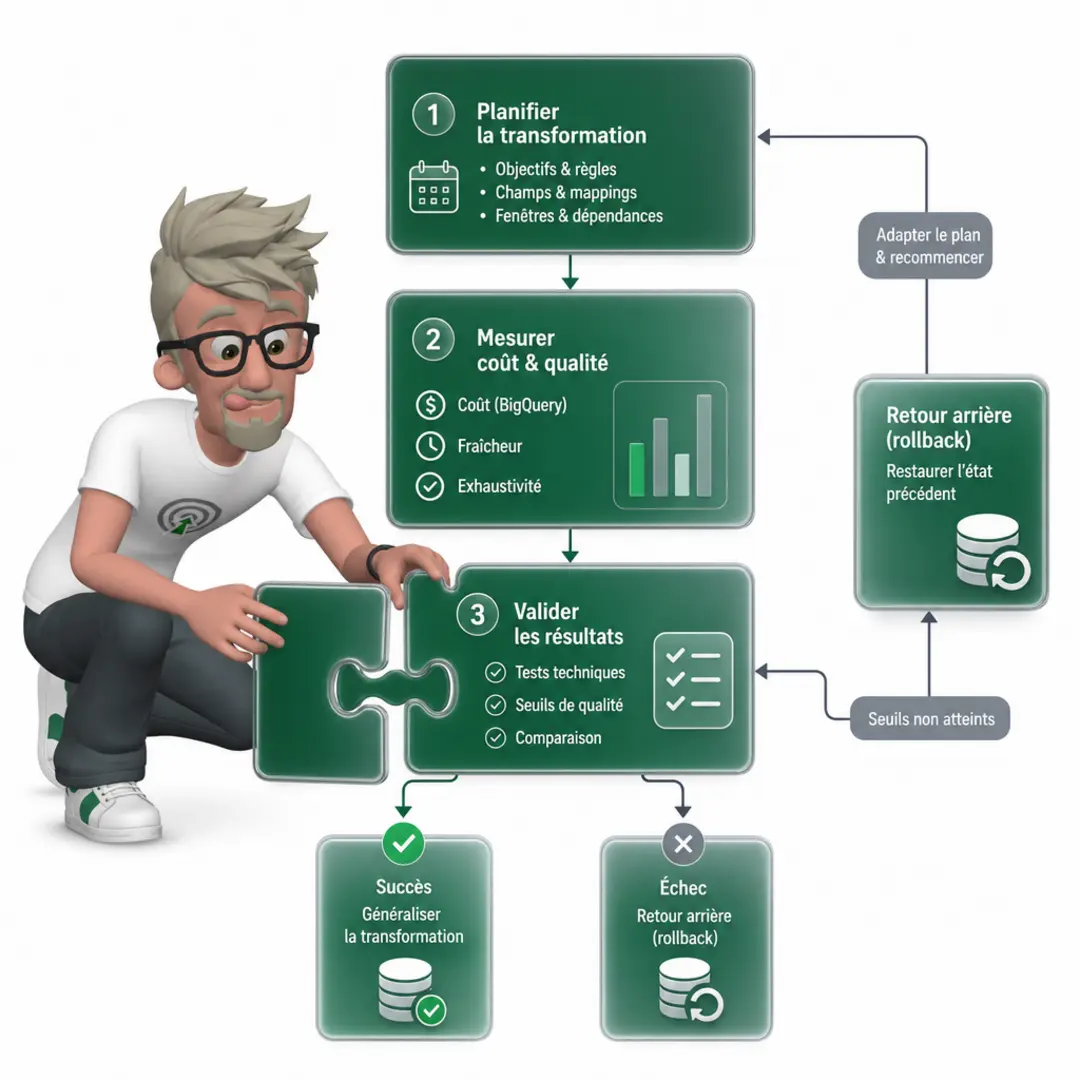
Avant le changement, je définis le résultat observable : coût estimé ou réel, volume de données traité, fraîcheur, exhaustivité et qualité des tables produites. Je précise aussi les dépendances, comme les tables sources, les règles de consentement et les rapports qui consomment les données. Ces indicateurs sont comparés à un état de référence établi sur une période représentative, avec les mêmes critères de mesure.
Après le changement, je vérifie que le résultat attendu est atteint sans dégrader les autres indicateurs. La fraîcheur doit rendre visible le retard entre l’événement et sa disponibilité. L’exhaustivité doit signaler les partitions ou journées absentes, plutôt que de laisser croire qu’une table incomplète est à jour.
Chaque plan de validation couvre les cas susceptibles de fausser le coût ou le résultat :
- Répéter l’exécution pour vérifier l’absence de doublons et de traitements inutiles.
- Actualiser les données, puis contrôler les partitions remplacées et les coûts associés.
- Simuler un échec, une erreur de validation et un retard de chargement.
- Annuler le changement et confirmer que l’état précédent peut être restauré.
- Vérifier les retours des utilisateurs, les usages mobiles et les changements de consentement, qui peuvent modifier les volumes ou la disponibilité des données.
La procédure de retour arrière indique le responsable, la condition de déclenchement, les objets à restaurer et les contrôles à rejouer. Elle doit aussi préciser les dépendances à suspendre ou à recalculer pour éviter qu’une table restaurée soit immédiatement écrasée.
Je ne généralise jamais une transformation sur la seule base d’une exécution réussie. Je vérifie d’abord le coût, la fraîcheur, l’exhaustivité et les usages réels sur un périmètre contrôlé, puis j’étends le changement si les résultats restent conformes.
Quelle première optimisation allez-vous tester ?
Maîtriser les coûts d’analyse GA4 dans BigQuery commence par un état de référence et des métriques définies, pas par un tableau de bord ajouté à la hâte. Filtrez les tables ou partitions avant le dépliage, sélectionnez uniquement les champs utiles, puis centralisez les transformations dans des tables de préparation et d’agrégation réutilisables. Vérifiez la traçabilité, la fraîcheur, l’exhaustivité, les consentements et les cas d’échec. Enfin, planifiez chaque changement avec un responsable, un résultat attendu, une comparaison datée et un retour arrière possible. Vous réduisez ainsi les traitements inutiles tout en gardant des analyses cohérentes et vérifiables.
FAQ
- Comment réduire les coûts d’analyse GA4 dans BigQuery ?
Je commence par limiter les tables ou partitions scannées avant de déplier les événements, puis je sélectionne uniquement les champs nécessaires et réutilise des transformations structurées. - Pourquoi filtrer avant d’utiliser UNNEST ?
Le filtre appliqué en amont limite les données traitées avant le dépliage des champs imbriqués. Il faut vérifier que le filtre correspond bien au périmètre de l’analyse. - Quels champs faut-il conserver dans une requête GA4 ?
Uniquement ceux requis par le cas d’usage et ses métriques. La source de chaque valeur doit rester explicite et les dépendances en amont comme en aval doivent être vérifiées. - À quoi servent les tables de préparation et d’agrégation ?
Elles rendent les transformations réutilisables et facilitent le suivi des valeurs entre leur source et leur destination. Il faut contrôler les noms, types, périmètres, délais, identifiants, devises, consentements et valeurs vides. - Comment vérifier qu’une optimisation n’a pas dégradé l’analyse ?
Définissez un résultat observable, comparez-le à une référence datée et testez les parcours normaux comme les répétitions, échecs, retards, annulations et changements de consentement. Prévoyez aussi un responsable et une procédure de retour arrière.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering. J’aide les équipes à structurer les données analytics dans BigQuery et à fiabiliser leurs modèles pour produire des analyses utiles, contrôlables et réutilisables.

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
- Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
- Data Engineering : BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
- Automatisation IA : n8n, Apps Script, scraping, API, LLM
- Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals